我用AI做了一集悬疑短剧
- 2026-11-18 22:47:40
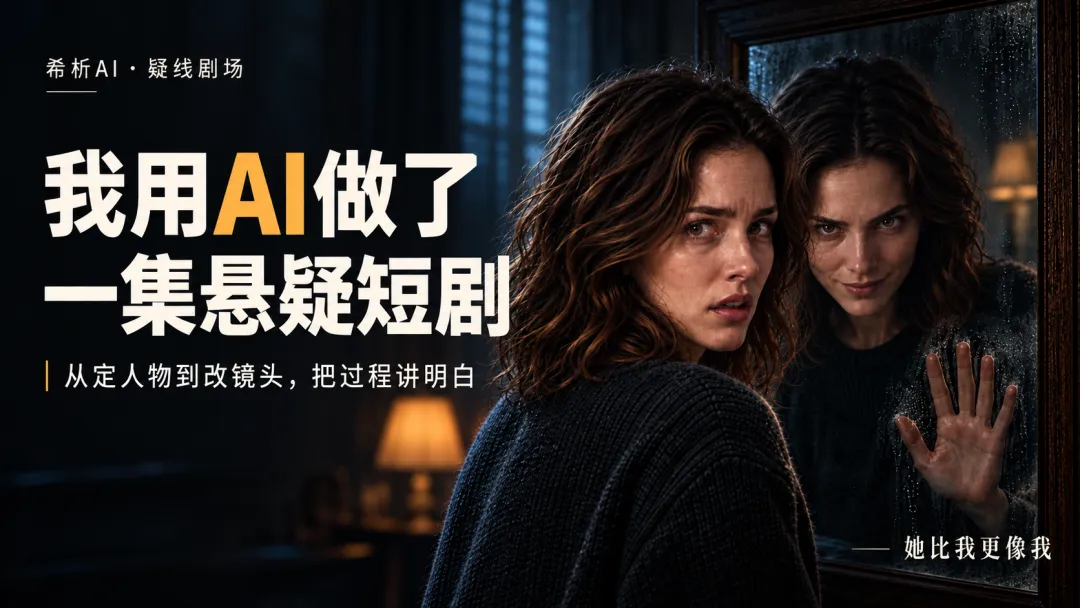
最近,我把《她比我更像我》的第一集做出来了。根据多位朋友的建议,还是把这个故事做成短剧的形式可能受政策限制更少。一共两分钟,真人质感的虚拟人物,英文对白,上面一行英文字幕,下面一行中文。
故事倒不复杂:Claire 发现,自己记得的事情,和别人说的不一样。海边合照变成了雪山,钥匙换了抽屉,陌生短信连同截图一起消失。她想写下来留个证据,第二天翻开本子,连“我是 Claire”都被改了。
听起来挺像那么回事吧?可做视频的时候,还有另一种“不对劲”:女主说话不张嘴,手机屏幕朝着观众,抽屉没人碰就自己打开。
这些可不是我安排的悬疑情节,是真得返工。
今天就拿这集说说,我是怎么把人物、照片、对白和动作一点点接起来的。你要是也想试,不必上来就做两分钟,先做通一小段,会轻松很多。
先把故事拆到能拍出来
最初我用豆包做过一点素材,后来决定继续用 Vidu 做这一版真人短剧。已有的人物图和场景图能用的就留下,没必要全推倒重来。
这里还有 Codex 帮忙整理素材、写镜头提示词、剪辑和检查。后面看到的字幕、补充的手机画面、镜头拼接,并不是在 Vidu 里点一次就全出来了。图片先准备好,视频分段生成,最后再合成,事情是分开做的。
我先按五件事来排:照镜子发现异常,看照片找闺蜜求证,回家找钥匙,收到又消失的短信,写本子后发现另一个自己。
然后继续往下拆。比如“她发现钥匙换了位置”,这句话能写进剧本,却还不能直接当成一个清楚的动作镜头。画面得让人看到:手拉开第三格,里面空了;再去拉第一格,钥匙在里面。
你可以先拿纸写三列:这一镜头看见谁、他做什么、观众会知道什么。第三列写不出来的镜头,先别急着生成。
人物先定下来 别一边拍一边换脸
这一版我定了三个人:Claire 是女主,Sophie 是闺蜜,Daniel 是男友。
前面的素材里,女主和闺蜜太像了,有些镜头还串了脸。单张看都挺好,剪到一起,就分不清是谁在说话。后来我把 Sophie 改成了微胖、圆脸、短卷发,穿墨绿色上衣。Claire 保留齐肩棕发和深灰针织衫,两个人的轮廓先拉开。
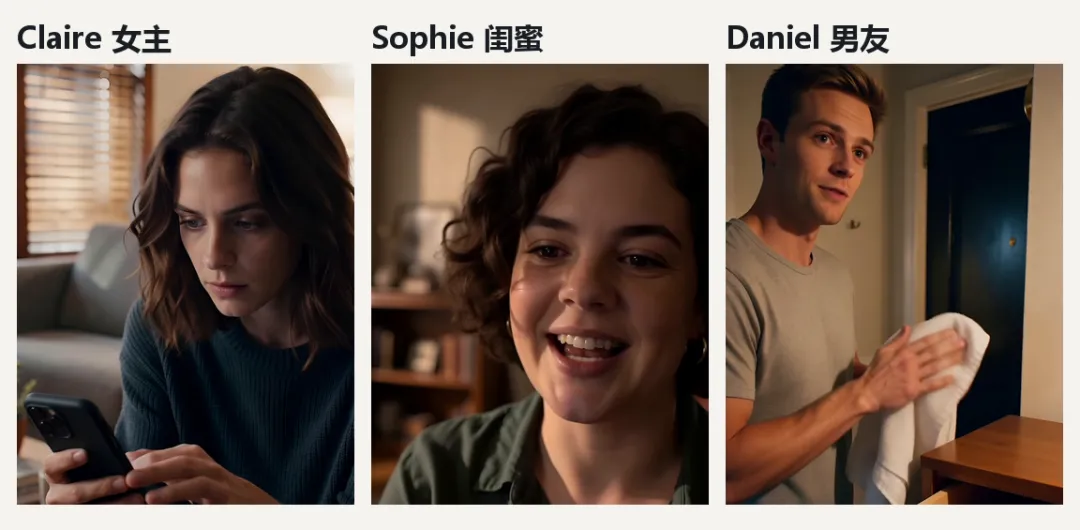
图1:Claire、Sophie、Daniel 的参考形象。发型和衣服也要跟着固定,不能只记名字。
这里我也走了弯路。第一次让闺蜜“胖一点”,出来的体型又太胖,只能改成“微胖”。所以,描述最好落到具体地方:脸颊稍圆、身形略丰满、短卷发到什么位置、穿什么颜色。
选定后,把正面和几个侧面的参考图存好。同一个人的镜头,尽量沿用同一套图。只拍 Claire,就不要顺手把 Sophie 也塞进参考素材里,给模型增加混淆的机会。
文件名也可以直白一点:“Claire正面”“Sophie短卷发”“客厅沙发”。后面几十张图混在一起时,这几个字真能省事。
到 Vidu 里 一次先做清楚一个动作
我这次用过 Vidu 的“参考生视频”:上传人物或场景参考图,再描述这一小段要发生什么。成片是竖屏,生成时也按 9:16 来做。操作顺序很简单:选参考生视频,上传这一镜头需要的参考图,设成竖屏,填动作和对白,确认时长及积分,再生成。出来以后先看一遍,确定能用再做下一镜。
提示词不用堆一长串“电影级”“超真实”。先把谁、在哪儿、做什么写明白。尤其是动作有先后顺序时,要把手和物体的关系说清楚。
拿第三格抽屉来说,可以照这个写法改:
保持参考图中三层木抽屉柜的结构。固定低机位,能看清三层抽屉。穿深灰针织袖的女主蹲下,右手握住最下面第三格的把手,向外拉开,伸手摸索空抽屉。上面两格保持关闭。动作连续,不出现其他人,无字幕。
别指望这一段文字一定一次成功。我第一次已经写了“第三格”,结果仍然开错。后来换了一张三格全部关闭、位置看得清的柜子参考图,把“第三格摸空”和“第一格找到”分成两段做,才把顺序交代明白。
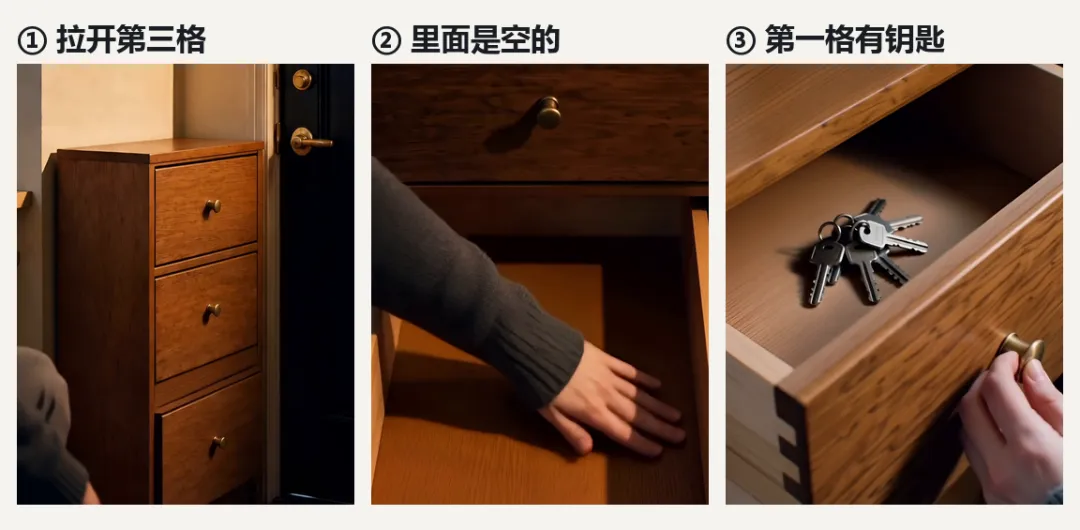
图2:拉开底部第三格,确认空了,再到顶部第一格找到钥匙。顺序要靠画面交代。
刚开始做时,尽量别在几秒里塞进“转身、拿手机、说话、开抽屉、拿钥匙”这么多事。少放一个动作,生成后就少一个需要排查的地方。
照片这场戏 先让观众知道她记得什么
照片段落我改过顺序。最后的处理是:Claire 翻相册,停住;给一个她记忆中的海边画面,再看到现在相册里的雪山照片;她觉得不对,才打电话问 Sophie。
闺蜜说:“去年去的是雪山。”Claire 才反问:“我们去的是海边吧?”这时候,观众知道她为什么紧张。
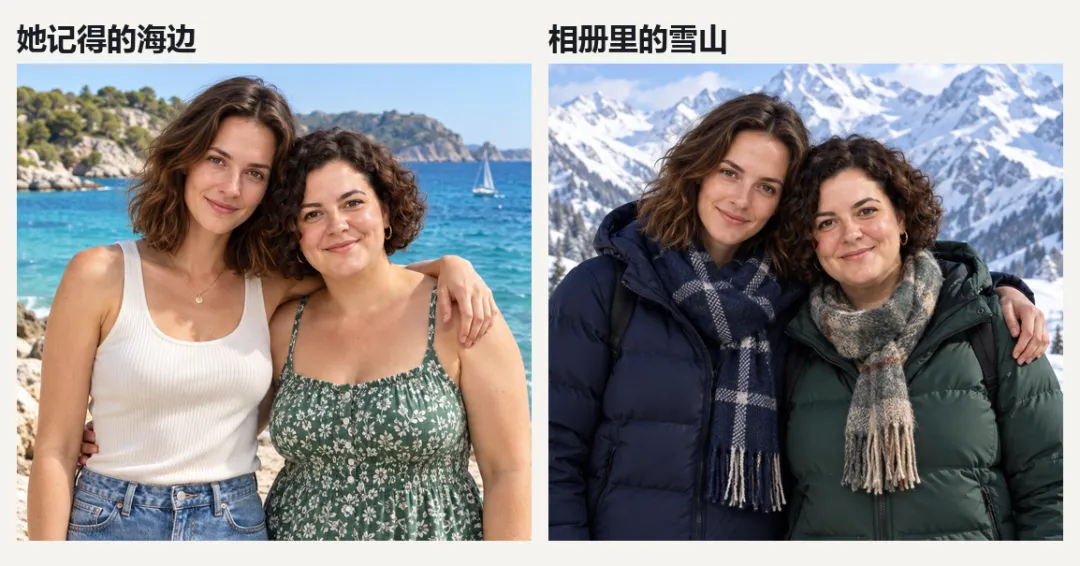
图3:同样两个人,海边是她的记忆,雪山是现在看到的照片。雪山里的衣服也换成了厚外套。
这里有两个小地方特别容易漏。一个是衣服:背景变成雪山,人却还穿着夏装,就会让人出戏。另一个是手机:她正对镜头看手机时,屏幕应该朝她,观众看到的是手机背壳。要展示照片内容,就切到她的视角。
我后面检查成片,又发现一分多钟的位置,手机背面突然变成了亮屏。最后用同一镜头里朝向正确的画面替换,并调整了速度,把原来的时长保住。
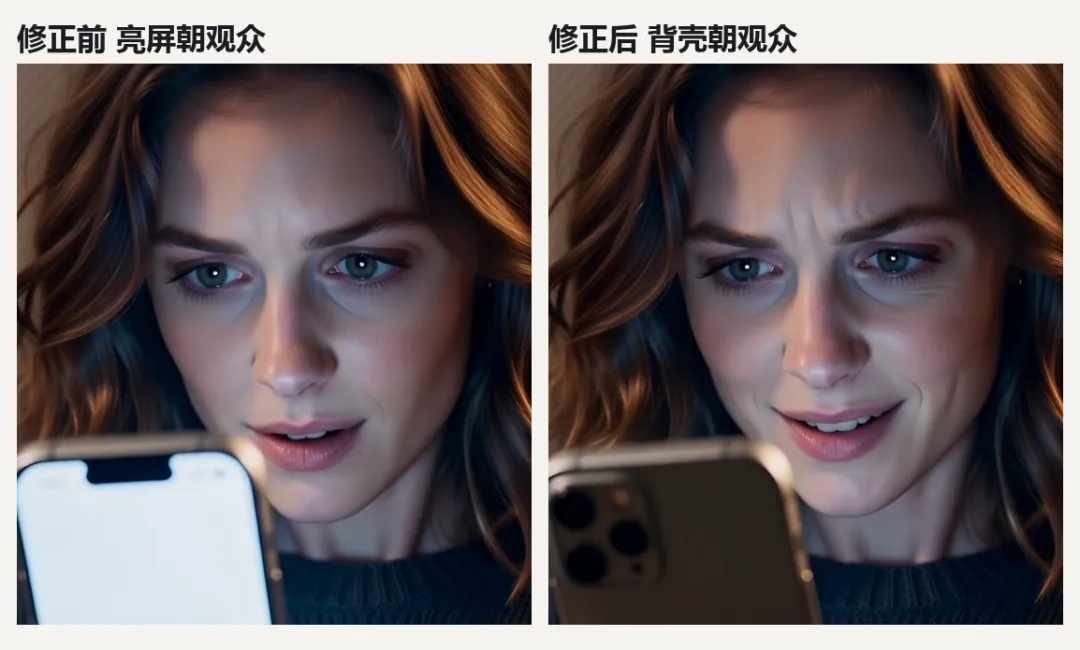
图4:左边是出错画面,亮屏朝着观众;右边是修正后,手机背面朝外。
所以,看生成结果时,别光看脸。顺着人物的眼睛想一遍:她正在看哪一面?手指应该点哪里?这比多写几个“真实自然”更好检查。
有声音 不等于嘴就对上了
这集用的是英文对白,字幕再配中文。检查到“我们去的是海边”那一句,才发现声音在走,女主的嘴却没跟上。
这段后来单独重做。提示词只留这句台词,强调由镜头里的 Claire 亲口说出,嘴唇和下巴有连续动作,不能变成画外音。生成后,再把新画面和它自己的对白一起换进去。
这里不要先把字幕做得漂漂亮亮,再去找画面配。先确定哪段视频能用,听清它实际说了什么,再按说话的时间放字幕。英文在上、中文在下,是我这集选择的排法。
检查时可以分两遍。第一遍关掉声音,看人物有没有张嘴、动作是不是顺;第二遍戴耳机听,看看台词有没有多说、少说,剪切的地方有没有把一个词截断。句子没说完,不要为了凑整数秒硬切。
写字和合本 得真的是同一本
本子这场戏,是我返工比较细的一段。
一开始,写字镜头里是一个笔迹,后面展示整页时又成了另一个样子。单独看,两张纸都没毛病,接起来就不像刚才那只手写的。
我的处理是:从实际写字的视频里取出写完的画面,直接用它承接后面的停留,再拿这张画面做合本的参考。这样,“I am Claire.”的字形和纸页就能接上。第二天被改动的落款,也沿着同一张纸和相近笔迹来做。
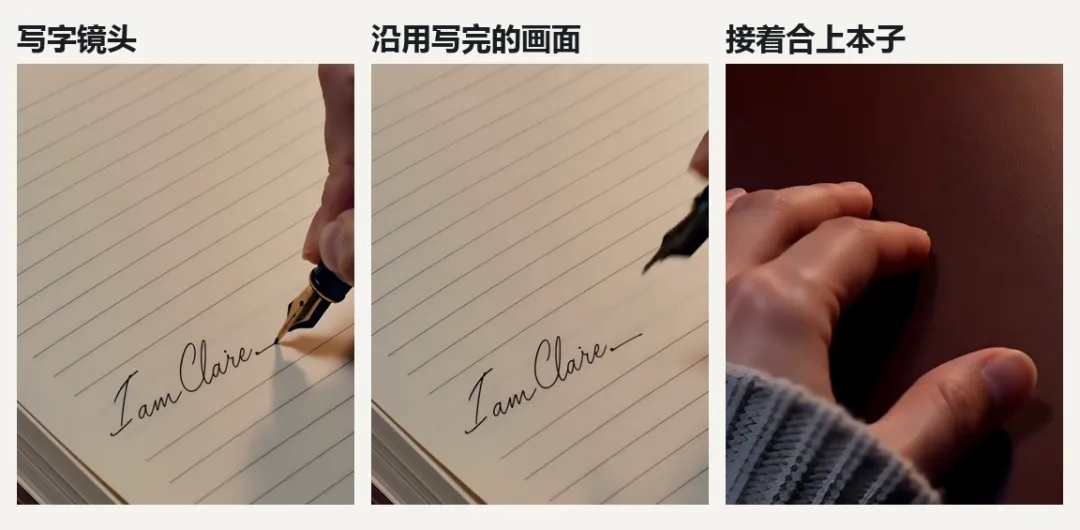
图5:写完、停留、合本,尽量围绕同一页来衔接。重新生成一张漂亮的纸,不一定接得上前一镜。
接着又有一个问题:她准备放本子时,抽屉先自己打开了。这个动作必须补出来——手伸向把手,握住,拉开,再放本子。后来我重做了这段,也单独补了合本镜头。
这类画面,我现在会盯着动作开始的那一刻看。东西动之前,手碰到了没有?书还在左手,下一镜怎么到了右手?有时候差的就是这半秒。
最后这遍检查 真别省
这次我没有把配乐重新加回来。对白和动作先理顺,已经够忙一阵了。音乐往往会把注意力带走,关掉音乐看,更容易发现哪里接得不对。
合成后的两分钟,我重点回看四件事:是不是同一个人,说话有没有口型,物体有没有突然换位置,前后两镜的动作能不能接上。还有字幕,一定拿实际准备发布的文件看,别只检查剪辑界面。
也别想着积分全花在第一次生成上。我最后这一轮补了五条短镜头,当时账户一共扣了132积分。这只是那次所选模型、时长和设置下的实际消耗,不是做一集的总费用,也不是现在统一的价格。准备提交时,看清页面显示的消耗,给返工留点余量。
如果你也想试,我建议先做一个很小的练习:一个人看手机,发现一张不对劲的照片,说一句话。人物、手机朝向、口型和字幕都能接顺,再往后加故事。
《她比我更像我》这两分钟做完,我记得最清楚的,反而是那只自己打开的抽屉。以后再写“她把本子放进去”,我一定会先补上一句:她伸手,拉开抽屉。
往期精彩

