Jellyfish 上手:把 AI 短剧流水线塞进一个工作台,角色终于不再换脸
- 2026-11-18 21:17:33
一、开篇:AI 短剧团队都在头疼的「一致性」难题
做 AI 短剧的团队,几乎都被同一个问题折磨过:剧本拆好了,镜头也排了,让 AI 出图、出视频,结果第一集的女主长这样,第五集变成了另一个人。角色走形、场景漂移、道具前后对不上——单镜头看着还行,连起来就崩。
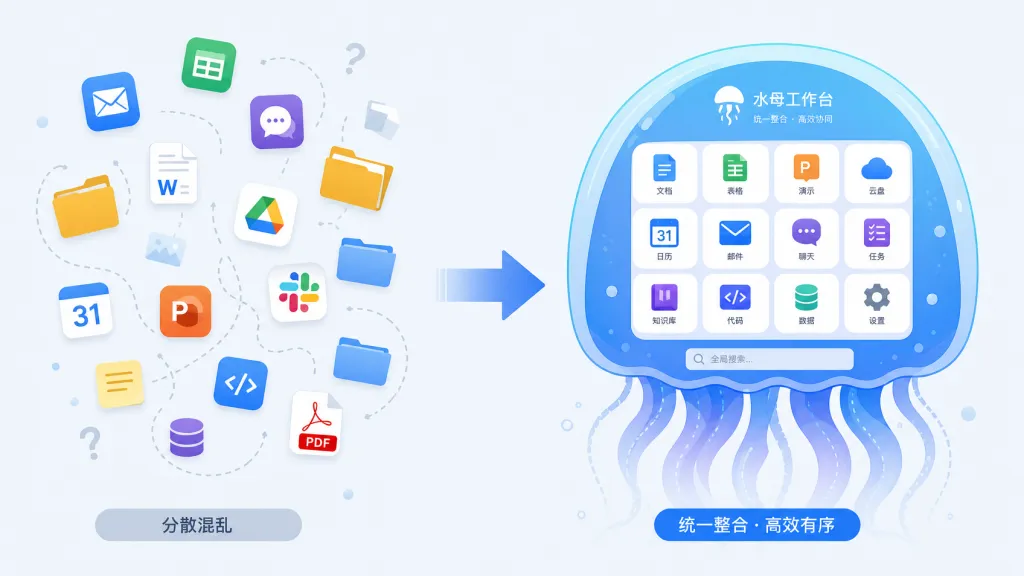
更糟的是,拆剧本、管理资产、跑生成任务、追踪进度,散落在七八个工具里。剪辑师在 Notion 找分镜,设计师在 Midjourney 出图,提示词工程师在飞书文档里维护模板,PM 在群里催进度。一次协作下来,光是同步「这版分镜是不是最新的」就要花半小时。
Jellyfish 想解决的,就是把这一整条流水线收进同一个工作台。
二、项目定位:它解决的是什么问题
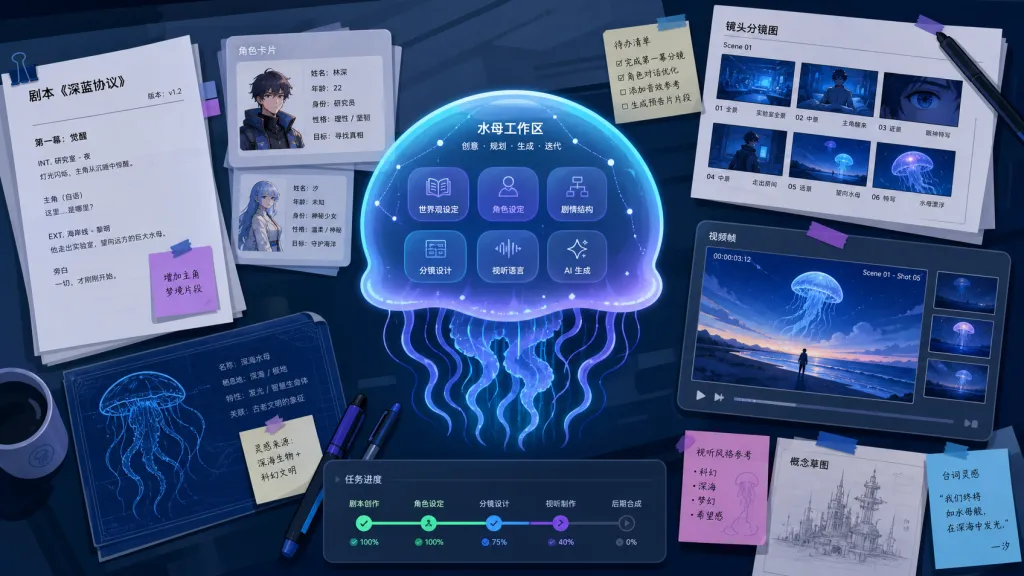
Jellyfish 定位为 AI 短剧一体化制作工作台,端到端覆盖从剧本输入到结构化分镜、一致性管理、镜头准备、视频生成与导出。
核心关键词四个:全流程串联、资产可复用、一致性优先、生成任务可追踪。项目采用 React + Vite 前端、FastAPI 后端、MySQL + Redis + RustFS 存储体系,并提供 Docker Compose 一键启动,遵循 Apache-2.0 协议。
三、核心功能深度解析
1. 剧本理解与分镜拆解
Jellyfish 不只是「把剧本丢给 LLM 出个分镜列表」。它支持把章节剧本按镜头切片,自动提取角色、场景、道具、服装、对白五类要素。同时支持剧本优化、简化、一致性自检,还能针对单角色做「人物小传」、针对单场景做「场景详情」的定向分析。拆完之后,每条候选资产都会进入待确认池,供制片人逐项拍板。
2. 镜头准备与确认工作流
这是 Jellyfish 主流程的核心。剧本拆解完成后的标准路径是:剧本拆解 → 镜头准备 → 候选确认 → 镜头就绪 → 生成工作区。在准备阶段,可以刷新资产候选、对白候选,采纳或忽略;可以把候选绑定到已有角色、场景、道具、服装上做复用;可以修正镜头级基础信息。系统用一个统一的「就绪状态」决定镜头是否能进入生成环节,并把「已准备」和「正在生成」两个状态严格区分开,避免误触。
3. 资产一致性与复用
系统维护了一套跨镜头共享的实体模型:角色/演员、场景、道具、服装。每个实体都有独立管理页和图谱,镜头级直接引用而非复制。这意味着第 3 集和第 12 集的女主,自动指向同一个角色节点,换发型、换服装时也只在实体层改一次。新建资产时还会做重名检查,鼓励复用而非重复造轮子。
4. 镜头级图像与视频编排
镜头进入 ready 状态后,生成工作区接管剩下的事:管理关键帧和参考图、预览镜头级视频提示词、发起图像或视频生成任务、支持单镜头和批量预检、生成结果回写到镜头与媒体库。也就是说,导演在镜头页改一行 prompt,工程师不用切窗口去另一个工具点提交。
5. 统一异步任务中心
文本处理、图像生成、视频生成走同一套异步任务基建:统一的状态、结果、耗时追踪,支持取消,全局任务中心可一键跳回关联的项目/章节/镜头。AI 生成动辄跑几分钟到十几分钟,没有这套基建就只能盯着轮询日志。
6. 模型、提示词与生成基础设施
支持多供应商、多模型管理,按类别设置默认模型;提示词模板按图像、视频、镜头分类管理;前端请求 helper 和类型直接由后端 OpenAPI 规范生成,输出到 front/src/services/generated/,前后端契约稳定,便于后续 AI 工作流扩展。
四、技术亮点与性能数据
架构上,Jellyfish 采用前后端分离:FastAPI 负责异步任务编排与 OpenAPI 暴露,React + Vite 负责交互层,MySQL 存结构化数据,Redis 做任务队列与缓存,RustFS 存生成出来的媒体文件。生成产物(关键帧、参考图、视频)全部带上下文回写到镜头与实体层,避免「图在哪?当时用啥 prompt?」的考古。
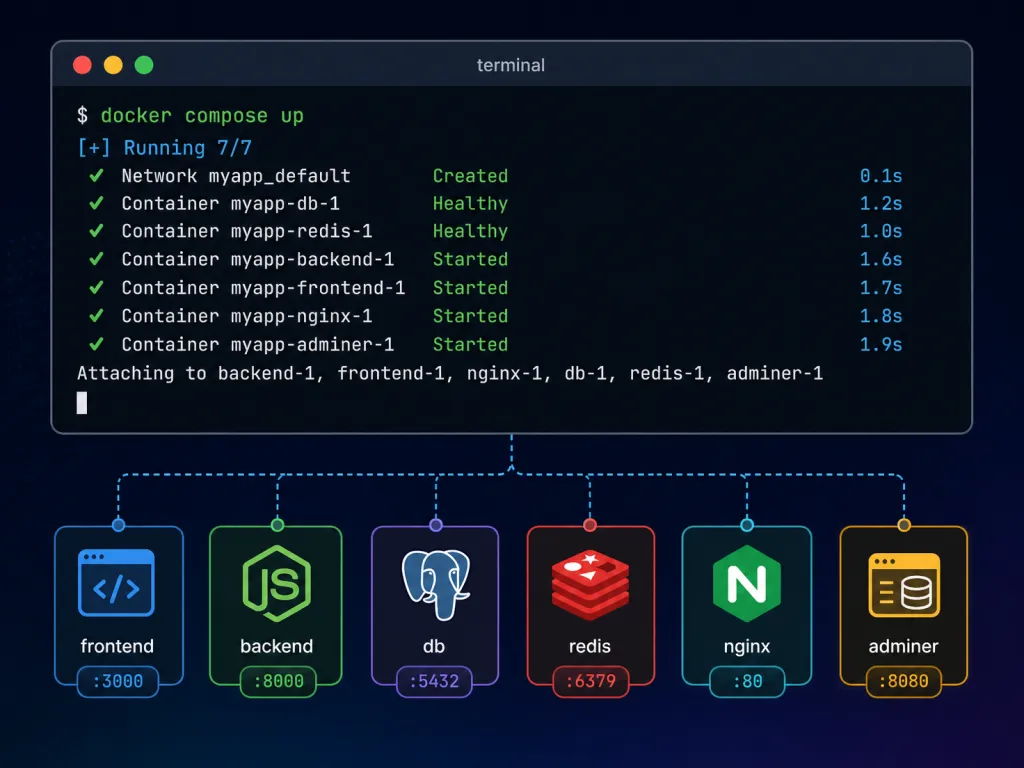
部署侧提供 Docker Compose 一键拉起,前端 :7788、后端 :8000(含 Swagger 文档)、MySQL、Redis、RustFS 端口全部预设,开箱即用。CI 侧同时配置了站点部署和 GHCR 镜像构建两条工作流。
五、适用场景与人群
适合谁:
短剧/微短剧团队,需要把剧本到成片的流水线收拢到一个工具里 AI 视频工作室,做批量生产、要管几十上百个分镜的团队 独立创作者,摸索竖屏短剧方向的个人 教育/培训团队,做课程视频需要稳定的人物与场景 品牌与电商团队,做剧情向短广告,需要控制角色一致性
不太适合:单张图玩玩、对一致性没要求的轻度用户;以及只想做纯文本创作、不需要生成环节的剧本写作场景。
六、竞品对比
Jellyfish 的差异化在于把「剧本拆解 + 资产一致性 + 镜头级编排 + 任务追踪」四件事压进同一个数据模型,而不是靠插件拼凑。
七、如何快速上手
Docker Compose 一键启动(推荐):
cp deploy/compose/.env.example deploy/compose/.envdocker compose --env-file deploy/compose/.env -f deploy/compose/docker-compose.yml up --build启动后访问 http://localhost:7788,后端 Swagger 在 http://localhost:8000/docs。
本地开发模式:
后端:
cd backendcp .env.example .envuv syncuv run uvicorn app.main:app --reload --host 0.0.0.0 --port 8000前端:
cd frontpnpm installpnpm devOpenAPI 类型同步:后端跑起来后,在前端目录执行 pnpm run openapi:update,自动从 http://127.0.0.1:8000 拉取最新规范生成请求 helper。
进阶建议:先用「项目管理 → 章节 → 剧本拆解」跑通最小闭环,再接入模型供应商配置;镜头级生成前务必把候选资产全部确认到 ready 状态,避免批量返工。
八、总结与行动建议
Jellyfish 的核心价值一句话概括:把 AI 短剧从「散落的工具链」变成「可追溯的生产流水线」,并把一致性问题提到了和生成能力同等优先级。
如果你正在用 3 个以上工具协作做 AI 短剧,建议先用一个 5 镜头的短剧做 PoC,重点验证两点:跨镜头角色一致性是否真的稳住、生成任务追踪是否能替代当前的群消息同步。
项目地址:https://github.com/Forget-C/Jellyfish ,Apache-2.0 协议,欢迎提 Issue 反馈需求。
短剧流水线收进一个工作台,角色才不会再「换脸」。
#jellyfish #Jellyfish #forget-c #开源项目 #GitHub
推荐阅读
视频号视频下不来?这个 8.7K Star 的开源工具帮你一键搞定 8 个子技能覆盖 25 套中文风格:沐阳插画 Skills 让 Codex 出图省掉重复调参 ComfyUI MiniMax H3 Director:AI 视频生成还在手搓?这 5 份工作流直接拉成产线 GPT-Image2 画图翻车?22.8K Stars 项目把 538 个案例逆向成可复用模板 从网盘管理到 AI 追剧:BoxPlayer 怎么把影音工作台做成一件事 6.2K Stars 的 portfolio-ideas:60+ 开发者个人主页案例一站看完 搬运海外视频还在手敲字幕?pyVideoTrans 帮你一键翻译配音 5 个 Skill,这套公众号 Agent 套件把排版配图建草稿拆成流水线 零配置、18KB JS、AI 原生:这个 2.3K Star 的文档生成器值得一试 22.5K Stars 的开源项目,让我彻底告别 YouTube 广告与追踪

