AI真人短剧一眼假?这5种表演最容易暴露AI味
- 2026-11-19 11:59:38
你有没有发现,现在很多AI生成的视频,画质已经越来越接近真人影视了。
人物的皮肤、头发、服装,甚至场景里的光影,看起来都挺真实。
但有时候,人物只要一开口、转个头,或者做出一个表情,就能立刻让人看出:
这不是真人演的,这是AI生成的。
为什么?
因为画面真实,不代表表演真实。
有些AI人物一生气就瞪眼,一难过就低头,一紧张就握拳。
还有的人物,明明只需要安静听别人说话,却不停地眨眼、转头、皱眉,像是生怕观众看不出来他有情绪。
最近我在制作《史里有戏》等AI真人短剧时,一直在研究怎样让人物表演更加自然。
今天结合实际制作中反复关注的表演问题,分享5种很容易暴露AI味的表现,以及我是怎么调整提示词的。
这次主要使用的工具是即梦AI SD2.0 Fast,全能参考模式。
不过,下面的方法并不局限于某一个模型,核心还是如何把人物表演描述得更准确。

人物一有情绪,就开始疯狂做表情
这是最常见的问题之一。
比如剧本里写:
“男人听到质问,心中震惊,但极力保持镇定。”
很多人可能会直接给AI这样的提示词:
❌ 容易失控的写法:
男人听到质问后十分震惊,表情复杂,眼神充满愤怒与不甘,努力压抑自己的情绪,展现出强烈的内心挣扎。
这段话看起来写得很有情绪。
但对于视频生成模型来说,“震惊”、“愤怒”、“不甘”、“内心挣扎”都是比较抽象的要求。
而且几个情绪同时出现,模型可能选择一些最明显的外部表情来表现它们。
比如突然瞪大眼睛、皱紧眉头、张开嘴巴。
最后画面就很容易变成一种夸张的短剧式表演。
那应该怎么改?
✅ 更具体的写法:
男人听完对方的质问,没有立即回答。视线保持在对方脸上,下颌缓慢收紧,嘴唇轻轻闭合。停顿片刻后,恢复平稳呼吸,表情没有明显夸张变化。
注意,这里没有反复强调“震惊”“愤怒”。
而是把人物的反应变成了几个可以实际看到的变化。
真正自然的表演,不是让观众看见一个情绪标签,而是让观众看见情绪如何影响人物的行为。
当然,如果剧情需要人物当场崩溃、大哭或愤怒爆发,夸张表情也完全可以成立。
问题不在于表情幅度大,而在于它是否符合人物当时的处境。
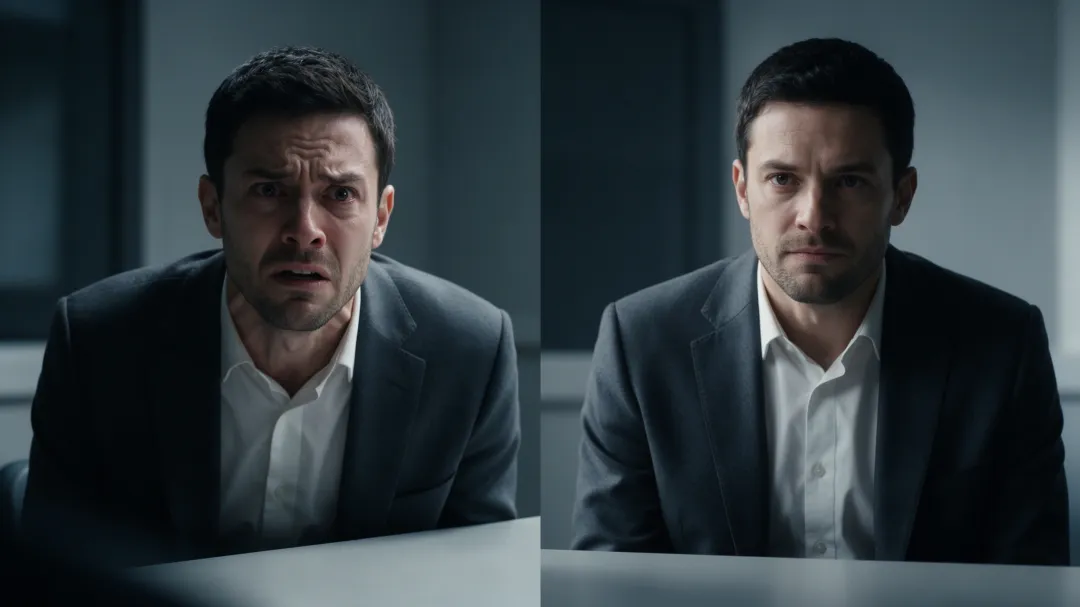
左侧失控写法VS右图具体写法

人物眼神乱飘,不知道到底在看谁
这一点很容易被忽略。
有时候我们生成一段双人对话视频,人物脸部其实很真实。
但仔细观察会发现:
他明明正在和面前的人说话,眼睛却一会儿看左边,一会儿看右边。
听别人说话时,视线甚至会突然看向镜头。
还有一种情况。
人物说完话,突然转头看向画外。
可那个方向根本没有任何值得他注意的东西。
这样的表演,会让人觉得人物的反应没有依据。
❌ 容易出错的写法:
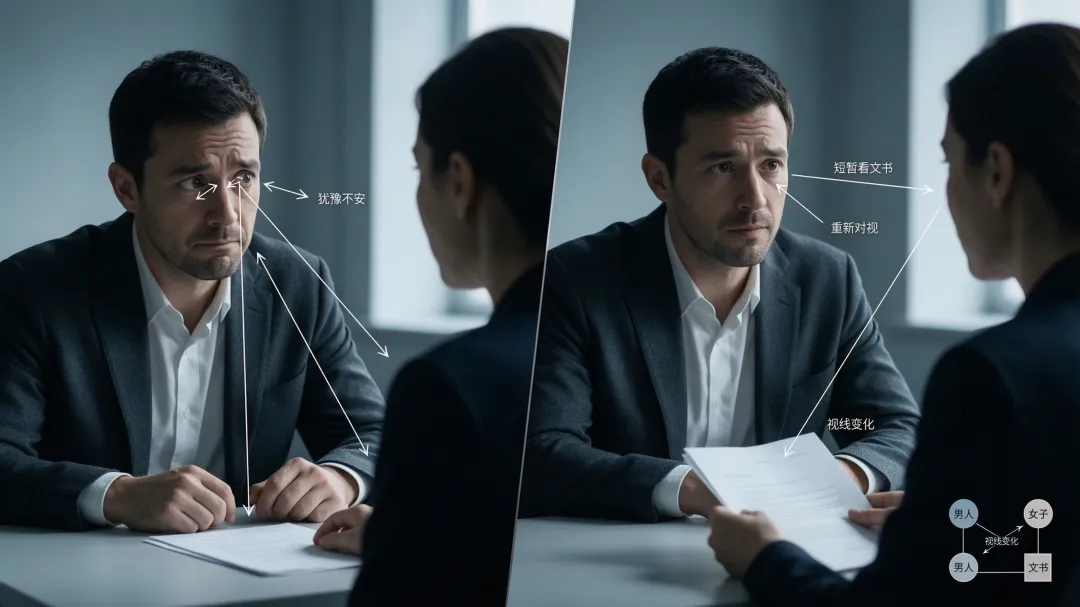
男人眼神复杂,目光不断变化,表现出内心的犹豫和不安。
这里最大的问题就是:
“目光不断变化”,但没有说明视线应该看哪里。
于是AI只能自己补充。
✅ 更具体的写法:
男人始终看着面前的女子。听到她说出最后一句话后,视线短暂落到女子手中的文书上,随后重新看向女子的双眼。过程中不看镜头,不无故转头。
现在,人物每一次视线变化都有了明确目标。
第一次看女子,是在倾听。
第二次看文书,是因为某句话让他注意到了文书。
第三次重新看向女子,是为了回应。
这样,人物的眼神就不再是随机变化。
这里分享一个特别实用的方法:
写人物眼神之前,先回答三个问题:他在看什么?为什么要看?看完之后有什么变化?
如果这三个问题都回答不了,就不要随意添加眼神动作。

每个人都在做同一套微动作
如果你经常使用AI生成真人视频,可能会发现一种很熟悉的表演套路。
人物说话前,先低头。
随后深吸一口气。
接着缓慢抬头。
然后皱眉、握拳,最后坚定地看向前方。
不管是皇帝、将军还是普通百姓,都喜欢这一套。
为什么会出现这种情况?
有时候,问题就来自我们的提示词。
比如:
❌ 常见写法:
人物表演自然细腻,有丰富的微表情,包含眨眼、皱眉、抿嘴、吞咽、深呼吸、握拳等动作。
为了让人物更像真人,我们反而给他安排了太多动作。
但真实演员并不是每隔一秒就需要做一个表情。
真正有意义的微动作,通常来自人物正在经历的事情。
比如一个人想说话,却决定暂时不说。
那么他可能只是嘴唇微微分开,又重新闭上。
这个动作有意义,是因为它表现了人物想要开口却克制住的过程。
而不是因为“抿嘴”本身就有电影感。
✅ 更合理的写法:
男人原本准备回答,嘴唇微微分开;听见对方继续说话后,他没有发声,重新闭上嘴,保持原有站姿,继续听完。
这段动作很少。
但它有完整的原因和结果。
人物本来准备做一件事,却因为外部变化而改变了行为。
少量有原因的动作,往往比一串没有目的的微表情更自然。
以后写提示词时,可以试着删除那些不影响剧情的眨眼、握拳和深呼吸。
看看人物的表演会不会反而更加干净。

人物动不动就转身、走路、靠近镜头
这也是我在实际制作中非常在意的一个问题。
很多时候,剧情并不需要人物移动。
但视频模型可能为了让画面产生运动,让人物突然向前走几步,或者莫名其妙转身。
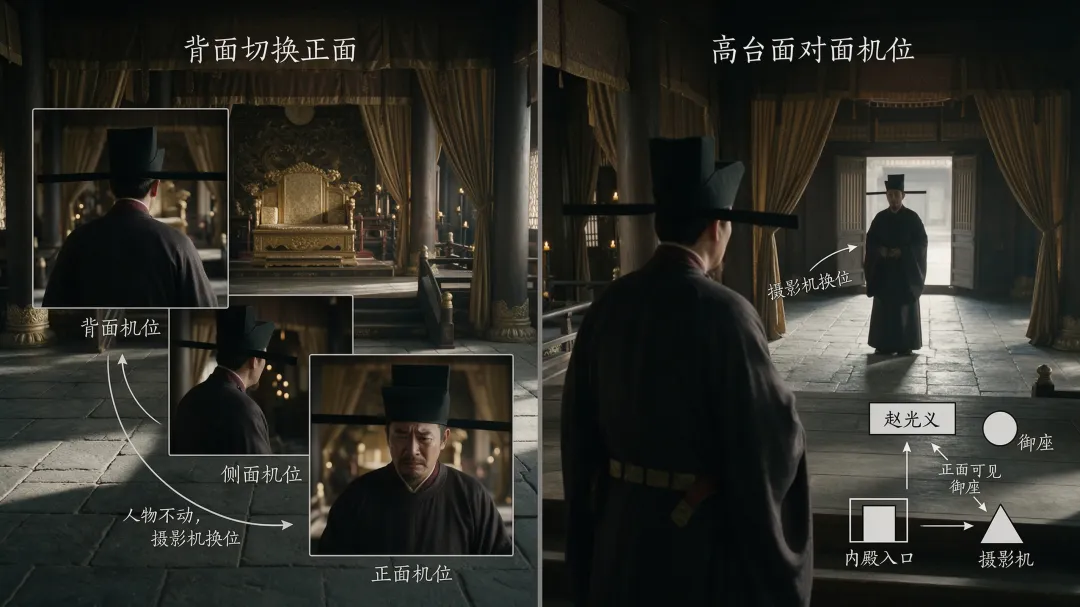
比如我们制作的赵光义大殿镜头。
整场戏里,赵光义始终站在御座下方,面朝御座。
镜头需要从背面切换到侧面,再切换到正面。
这里有一个非常重要的区别:
人物从背面变成正面,不代表人物转过了身。
我们需要改变的是摄影机的位置,而不是赵光义的站姿。
但如果提示词只写:
❌ 容易产生歧义的写法:
镜头从人物背面切换到正面,展示人物听到质问后的表情。
AI可能会理解成让人物转过身来面对摄影机。
结果人物本来应该一直面向御座,却突然转身了。
这不仅破坏人物动作,还会破坏整场戏的空间关系。
后来,我在这组镜头的提示词里专门增加了这样的约束:
✅ 实际使用的提示词节选:
摄影机在高台这一侧,与赵光义面对面,朝内殿入口方向拍摄。
赵光义始终面朝御座,因此镜头看到他的正面;赵光义本人没有转身,没有向镜头走近。
这里的重点是:
明确说明摄影机改变位置,人物保持原位。
当时我们还把赵光义的身体朝向、脚底与台阶的位置关系,以及背后的殿门状态一起锁定。
最终修订后的提示词,解决了此前这组镜头反复出现的主要空间错误。
产生歧义的写法 VS 约束写法
这个方法也适用于其他场景。
比如两个人正在谈判。
一个人坐在桌边,另一个人站在对面。
如果剧情没有要求人物站起来、走近或者转身,就不要随便给他们添加动作。
人物移动应该是剧情事件,而不只是为了让视频看起来在动。

人物没有真正“听见”别人说话
前面四种问题,主要发生在表情和动作上。
第五种,我觉得对AI短剧的观感影响更大。
那就是:
人物只是在完成自己的动作,却没有对其他人的话产生自然反应。
举个例子。
两个人正在对话。
A说:“这份文书,是你亲手签的吗?”
B听完后回答:“是。”
如果我们只是让AI分别生成A说话、B说话,很容易得到两段看起来各自正确,但连接起来很生硬的视频。
原因在于:
B的表演没有体现出他正在听A说话,也没有体现听完问题后才作出回答。
人物只是按顺序张嘴。
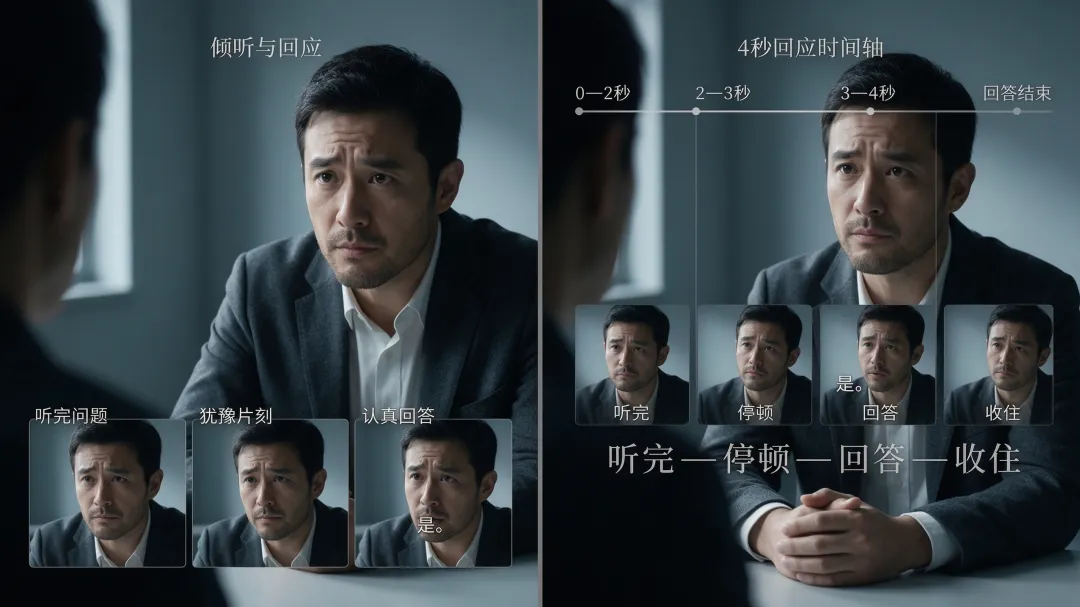
对于这种情况,我更推荐使用带时间顺序的表演指令。
❌ 比较笼统的写法:
男人听到问题后神情凝重,犹豫片刻,认真回答:“是。”
✅ 更具体的写法:
0—2秒:男人看着对方,保持安静,嘴唇闭合,听对方把问题说完。
2—3秒:对方话音结束,男人仍看着对方,没有立即开口。
3—4秒:男人用平稳的音量回答:“是。”
回答结束后,嘴唇闭合,不额外补充台词。
这个例子看起来非常简单。
但里面有一个重要细节:
人物的反应,必须发生在触发它的事件之后。
听见问题,再作出反应。
而不是问题还没说完,人物就开始摇头、皱眉、张嘴。
这种时间关系,对AI视频尤其重要。
另外,如果是双人对话,还要明确谁在说话、谁在倾听。
否则有时会出现画外音属于A,画面中的B却跟着张嘴的情况。
所以我现在制作对话场景时,会特别检查:
人物有没有听完?
反应有没有提前?
说话者有没有弄错?
应该沉默的人有没有乱动嘴?
这些细节看起来不起眼,但经常决定一段AI对话是不是自然。

什么叫克制的表演?
回到我们这次《史里有戏》的制作案例。
赵光义站在大殿里,听到画外音:
“你却坐上了皇位!”
这句话很重。
按照常见的AI提示词写法,可能会写:
“赵光义听到质问,内心受到巨大冲击,神情震惊,眼神复杂,显得十分愤怒。”
但这样很容易让人物突然做出强烈的表情。
其实,我更希望这一刻表现的是:
赵光义听完质问,却没有立即回应。
所以最后的提示词中,我们采用了这样的处理:
赵光义眼睛始终看向前方御座方向,听见最后两字后下颌略收、视线定住、嘴唇闭合,全程无口型。
只有三个很小的变化:
下颌略收。
视线定住。
嘴唇保持闭合。
为什么这样处理?
因为前面已经用背面和侧面镜头交代了赵光义与御座的关系。
到了正面近景,观众需要的是他的反应,而不是一个新的大动作。
而且这个镜头本来就是人物正面近景。
不需要通过突然转身、挥手、走路来强调人物情绪。
只要让他听完,停住,就已经有了表演空间。
这里还有一个细节:
如果当前镜头拍摄的是人物背面,就不要在提示词里要求表现人物的眼神和嘴角变化。
因为摄影机根本看不见。
背面镜头可以描述肩背、站姿、身体重心等可见动作。
正面近景才适合表现视线、下颌、嘴唇等细微变化。
这一点,也是我现在写AI真人短剧提示词时会特别检查的地方。

一套简单的表演提示词方法
如果你正在用即梦全能参考制作AI真人短剧,可以尝试按照下面这个顺序写人物表演。
第一步:明确人物的目标。
人物此刻想做什么?
是逼问对方、掩饰慌乱,还是争取信任?
这一步先在自己设计分镜时想清楚,不一定需要直接写进AI提示词。
第二步:找到触发反应的事件。
是听到一句话?
看到一件东西?
还是发现对方做了一个动作?
第三步:写出镜头实际看得见的行为。
尽量使用具体动作。
比如视线停在谁身上、嘴唇有没有张开、身体是否移动、手里的东西有没有放下。
第四步:安排动作发生的先后顺序。
对于10秒的多镜头视频,可以按时间轴控制重要动作。
不要让人物提前回应还没有听到的信息。
第五步:删除没有必要的表情和动作。
尤其是那些为了“显得有情绪”而添加的皱眉、低头、深呼吸和握拳。
最后,再检查人物在当前机位下能不能真正被看见。
总结起来,就是一句话:
先确定人物为什么反应,再决定他怎么反应,最后才把反应写成AI能执行的动作。

写在最后
现在AI视频模型的画面质量已经可以做得相当不错。
但制作AI真人短剧,我们不能只关注人物有没有变脸、场景有没有穿帮、动作有没有完成。
还需要关注另一个问题:
这个人物的行为,看起来像不像一个真正处在剧情中的人?
他有没有认真听对方说话?
他的视线有没有明确目标?
他的动作是不是有原因?
他的反应有没有发生在正确的时间?
当我们开始关注这些问题时,提示词就不再只是要求模型“生成一个有情绪的人”。
而是在安排人物如何经历一件事,以及这件事如何改变他的行为。
这次分享的5种问题,并不是说AI人物一定不能瞪眼、皱眉、转身或者做夸张动作。
而是这些动作必须符合当时的剧情、镜头和人物目标。
真实感不等于动作少,而是每个动作都发生得有道理。
对于想把AI漫剧做成真正具有影视质感的作品的创作者来说,我觉得这比单纯追求画面精致,更值得花时间研究。
 如果这篇文章对你有帮助,欢迎点个关注。后续我会持续更新AI漫剧的实操拆解,包括提示词模板、分镜案例、短片教学、不同平台的横向对比等。有什么想了解的具体问题,也可以在评论区留言,我尽量回复。

