AI古诗词短剧→制作流程
- 2026-11-14 22:56:57
最近发现全民都在看没有营养的短剧,我也想起了做点有意义的AI视频。好了,流程快做出来了。AI古诗词短剧制作全流程
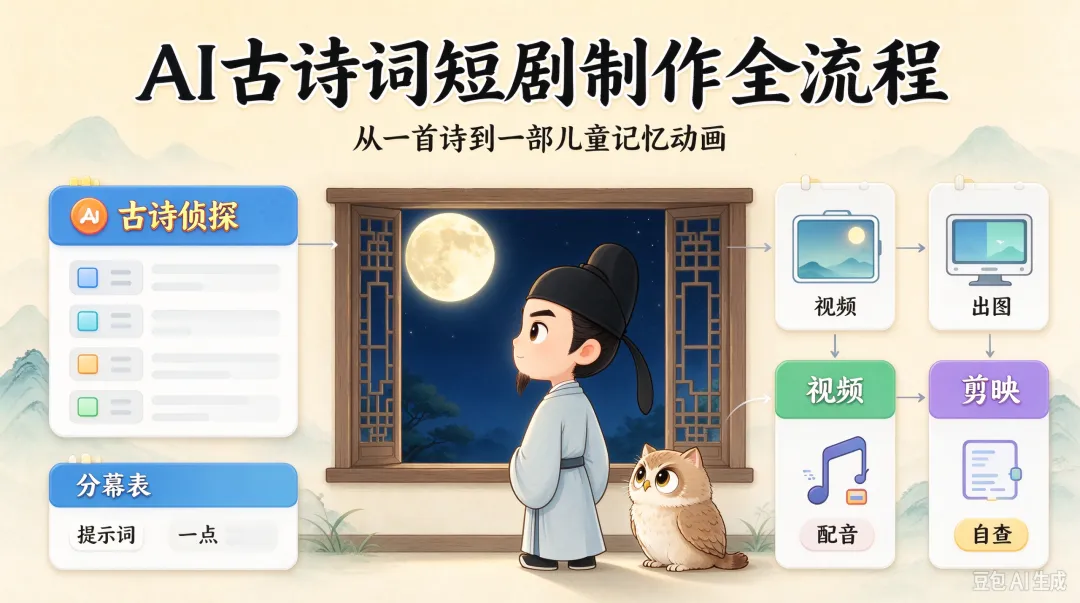
这把一首诗变成一部30到70秒的Q版动画短片,配合最强大脑的记忆大师体系、让6到12岁的小朋友看一遍就能记住。
今天我把自己摸索出来的完整工作流拆给你看。从一首诗到一个成片,全程只需要国产AI工具,不需要付费软件,不需要编程基础。
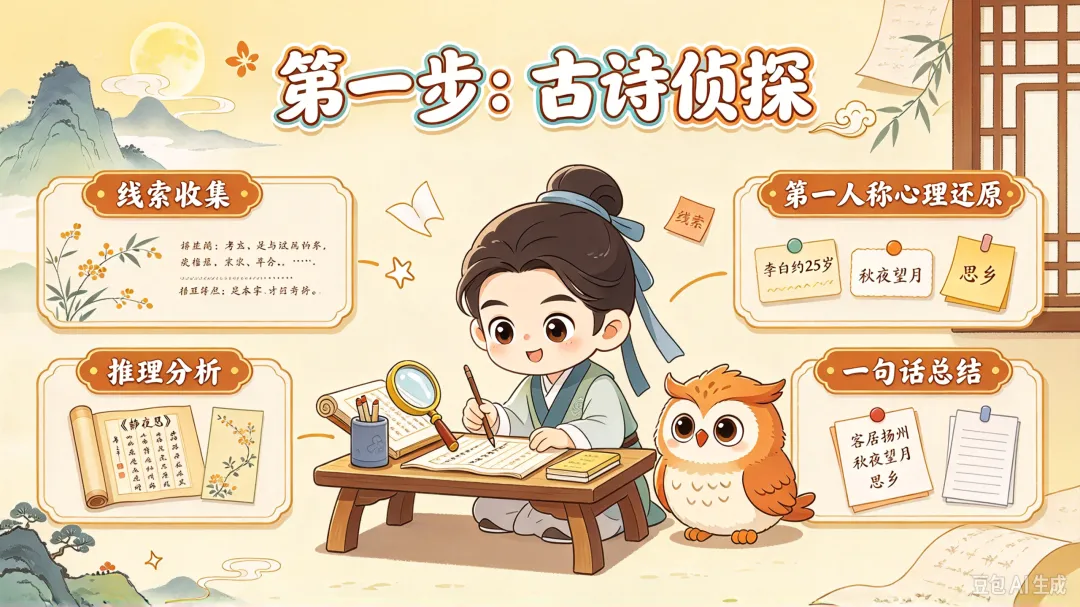
第一步:让AI当一回"古诗侦探"
大多数人教古诗,方式是"诗人写这首诗的时候,他想表达什么"。但这个问题的答案,课本上写的是后人的总结,不是诗人自己的话。
我的第一个提示词,叫"古诗侦探兼心理共情者"。你把一首诗丢进去,AI不是给你做鉴赏,而是像侦探破案一样,根据文本线索推理出作者写这首诗时的处境、心情、动机和隐含意图,最后用第一人称还原作者的心声。
以《静夜思》为例。输入诗题、作者、原文,AI输出六个模块:线索收集、推理分析、文本细读、第一人称心理还原、争议存疑、一句话总结。
它不会告诉你"这首诗表达了思乡之情"这种正确的废话。它会说:李白当时大概25岁,刚离开四川不久,客居扬州旅舍,秋夜月色照进屋子,他抬头看见月亮,低头想起故乡。这些不是课本告诉你的,是AI从文本线索推理出来的,每一条推理都标了依据和推测等级。
这个步骤的最终产物,是"推理结论"和"一句话总结"这两段。你把它们复制下来,准备贴到第二步。
为什么先做这一步?因为后面要画Q版动画,你得先理解诗人当时是开心还是难过、在什么场景下写的诗。理解错了,画面就全偏了。
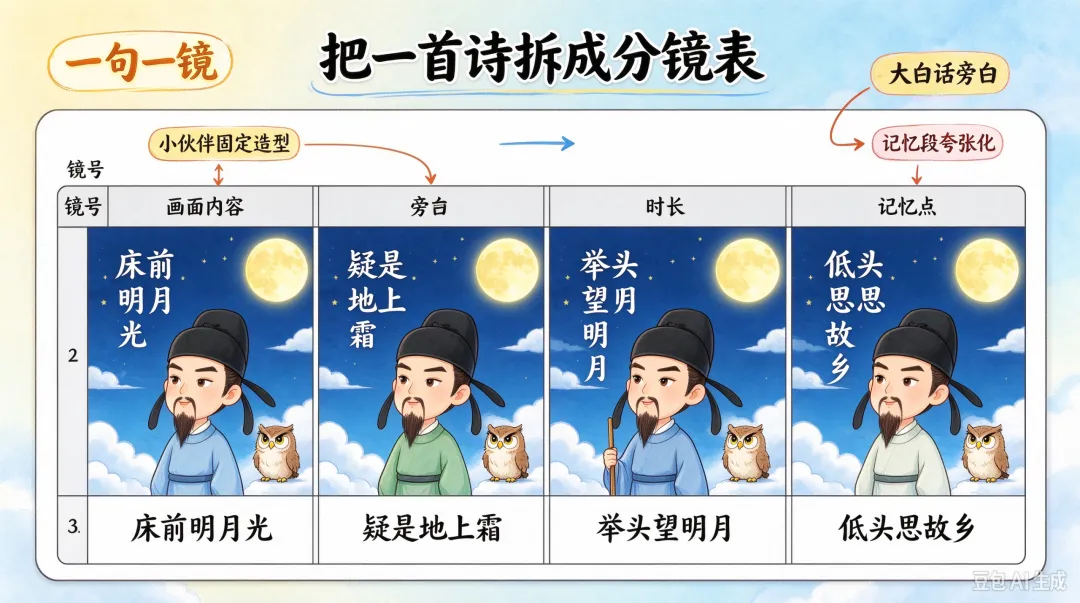
第二步:把诗拆成分镜表
这一步是最核心的。我有一个叫"02_E路线·小朋友Q版"的提示词,角色定位是"儿童教育动画片导演加记忆编码教练"。
你把上一步的推理结论贴进"诗意理解"字段,再填上诗题、作者、动画风格(Q版国风卡通)、适合年龄(小学生)、画幅(横屏16:9),发送。
AI会按一条加工链跑:古诗拆解→关键词提炼→记忆法编码→连续Q版画面→脚本镜头。
输出内容很丰富,分两段。第一段输出记忆成品(一句话主旨、主画面、口诀顺口溜)、基础信息、人物设定(含角色定妆生图提示词)、关键词记忆编码表。你说"继续",它输出第二段:分镜表、易错点提醒、视觉设计、配音建议,末尾附自检清单。
这里有几个设计细节值得说一下。
第一,每句诗至少对应一个镜头,不并句不漏句。《静夜思》四句,演诗段就至少四个镜头。这是硬约束,违反就不合格。
第二,必须加一个"小伙伴"角色——一只可爱的小动物或小精灵,比如小猫头鹰、小书童。作用是带着小朋友一起进入诗里。而且小伙伴的外貌必须固定写死,品种、颜色、大小、标志性特征全写进角色定妆提示词。为什么?因为AI出图时如果不固定外貌,每一镜里的小伙伴长得都不一样,小朋友会困惑。
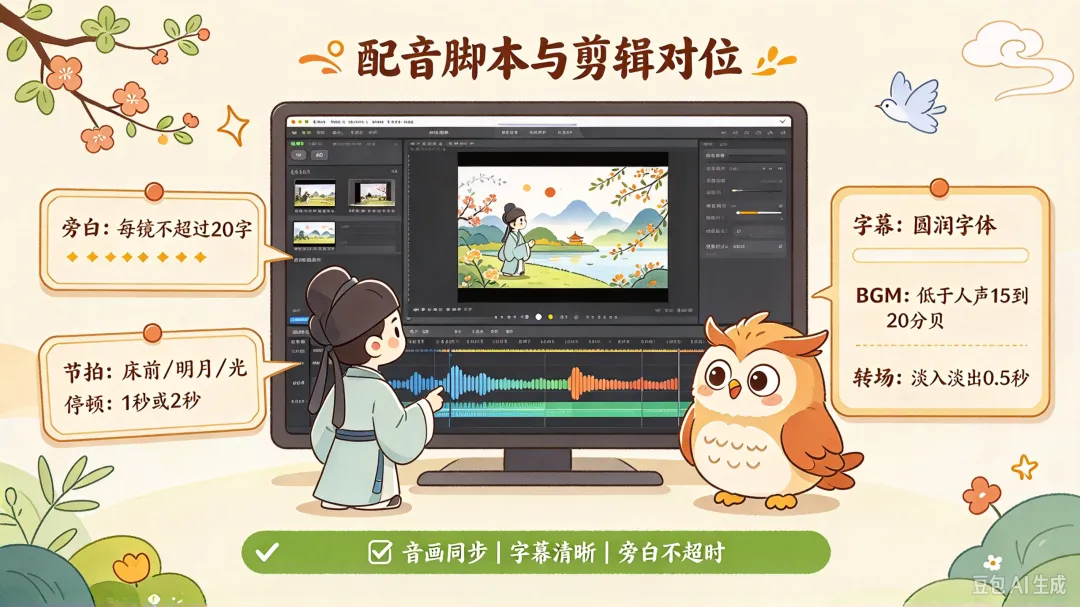
第三,旁白用大白话。诗句可以念,但旁边要加一句小朋友能懂的解释。比如"白日依山尽——就是太阳慢慢落到山后面去啦"。每镜旁白不超过20字,保证在镜头时长内念得完。
第四,视频结构是公式制的。总时长=开头5秒+演诗镜数×3到6秒+记忆段15到20秒+片尾5秒。四句绝句约37到49秒,八句律诗约49到73秒。不需要改模板,随句数自动伸缩。
第五,"帮你记"段是这部短剧的灵魂。不是含蓄的留白,而是夸张到小朋友会笑出来的画面。"飞流直下三千尺",就画成瀑布像倒水一样冲下来,小鱼都被冲飞了。记忆法按内容类型选:叙事推进的用故事法和动作链,并列意象的用空间定桩,抽象哲理用对比画面加具体化,句数少的口诀法就够了。
这一步的最终产物,是一张Markdown格式的分镜表。表头固定:镜号、段落、画面内容、情绪、景别、运镜、时长、字幕(原句加节拍)、旁白、记忆点。这张表是后面所有步骤的输入源。
第三步:生成出图出视频的提示词
拿到分镜表后,贴进"03_Q版终版提示词生成器"。这个提示词的角色是AI视频提示词工程师,专攻Q版儿童古诗动画。
它输出三样东西。
第一样是全局风格块。Q版国风卡通、二头身三头身、大头小身子、圆脸大眼、表情夸张可爱、鲜艳明亮高饱和、绘本质感、横屏16:9。所有镜头共用,只写一次。还有一份Q版负面词清单:写实、真人比例、成人化、阴暗、恐怖、灰暗色调、现代建筑、汽车、手机,全列出来。这些词填进出图平台的负面提示词框,防止画面跑偏。
第二样是"三件套参考图提示词"。这是保证全片一致性的锚。出每一镜素材图之前,先出三张锚点图:角色定妆图(主角加小伙伴站在一起的定妆照,正面全身纯色背景)、全局风格参考图(一张能代表全片画风色调的空镜)、场景参考图(本片主场景,如山间草庐或宫廷庭院)。
三件套怎么用?拿到三张参考图后,出每一镜的素材图时,把这三张一起拖进即梦或豆包的"参考图模式"。角色和画风就不会跑偏。如果某镜场景和主场景不同,比如从室内切到室外,先出该场景的参考图再出这镜的素材图。
第三样是逐镜提示词,每镜两段。生图提示词写这镜的主体、动作、场景、景别、构图,角色外貌沿用定妆描述。图生视频提示词只写运动变化部分——运镜加微动加时长,静态画面交给参考图,文本只描述"动什么、怎么动"。
这里有个关键原则:所有提示词统一用中文。即梦和豆包都是字节系国产模型,中文语义理解优先于英文,中文提示词出图出视频更稳定。专业术语可以括号标注英文,但主干描述用中文。
还有一个微动原则必须遵守:主体尽量不动,只做全局微动。头发衣袖飘动、云朵移动、水波荡漾、花草轻摇。Q版慎用快速环绕、大幅甩镜、手持晃动——小朋友看着会晕,也容易让角色变形。
输出量大,分段跑。第一批出全局风格块加三件套,之后每批最多4镜,出完等"继续",直到全部镜头出完。
第四步:出图
打开即梦或豆包,先把三件套参考图出了。用角色定妆图提示词出一张主角加小伙伴的定妆照,用全局风格参考图提示词出一张空镜,用场景参考图提示词出一张主场景。
然后逐镜出素材图。每镜的生图提示词复制进去,三件套参考图拖进参考图模式,出图。检查角色长相是否和定妆图一致、画风是否统一、情绪是否外化明显。不合格就重出。
出完所有素材图,命名归档。建议按镜号命名,比如"镜1开头.mp4""镜2演诗.mp4",方便后面剪映组装时对照分镜表。
第五步:图生视频
把素材图喂给即梦视频或可灵视频,配上图生视频提示词。注意只描述运动变化,比如"缓慢推近,头发和衣袖轻轻飘动,主体保持稳定不动,4秒"。
等视频生成完,检查三点:时长是否在3到6秒、运动是否符合提示词描述、角色有没有变形。不合格重新生成。
第六步:配音脚本
这一步可以和出图并行跑。你只需要02_E的分镜表,不需要等视频结果。
把分镜表贴进"05_配音文本整理"提示词,AI把旁白列和字幕列整理成一份可直接喂TTS的连续配音脚本。按镜号排列,每镜一段,标注语速(快、中、慢)、节拍(用斜杠分隔,如"白日/依山/尽")、停顿(停顿1秒或2秒)。
"帮你记"段会拆成三部分:口诀念一遍、动作链解说、一句话总结。片尾跟读单独标注慢速完整朗读。如果某镜旁白超过镜头时长能念完的字数,会标注超时并给出缩短建议。
拿到配音脚本,喂给剪映AI配音或豆包TTS,音色选活泼可爱的,语速1.0到1.2,比成人版快。
第七步:剪映组装
打开剪映,按顺序操作。
导入所有视频片段,按镜号拖入时间轴:开头引入→演诗镜(按句序)→帮你记→片尾跟读。检查总时长是否在公式范围内。
加字幕。每镜加诗句字幕,原句按分镜表字幕列的节拍标注断行。字幕样式建议圆润字体、白色字体加彩色描边、居中偏下。片尾全诗字幕停留5秒,字号略大。
导入TTS音频,对位每镜,音频起点对齐镜头起点。检查旁白是否在镜头时长内念完,超时调语速或截断镜头。
选轻快活泼儿童感BGM,音量调至低于人声约15到20分贝。BGM从开头引入镜开始,片尾跟读镜结束前2秒淡出。
转场方面,Q版默认用淡入淡出0.5秒,演诗镜之间节奏快时可用硬切,帮你记到片尾跟读用叠化。
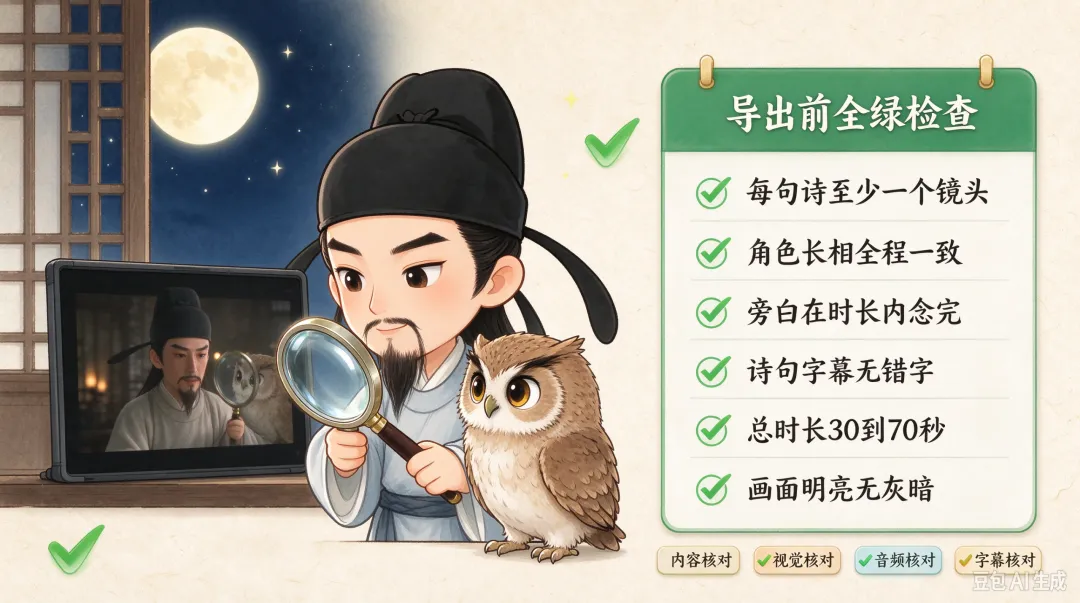
第八步:成片自查
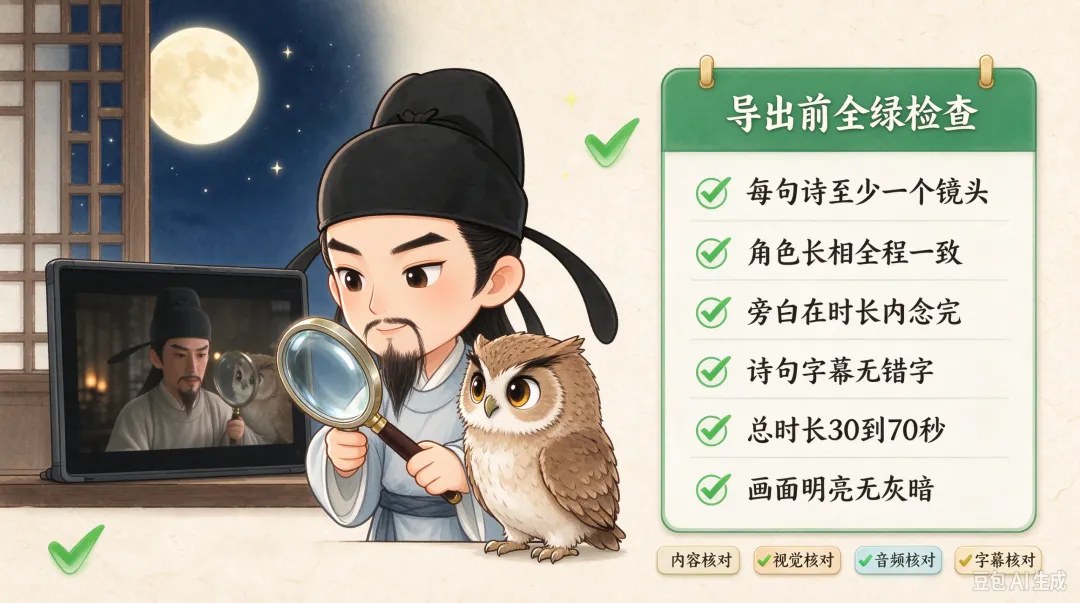
导出前逐项检查,全绿才能导出。
视觉核对:角色全片长相一致、画风统一Q版国风卡通、画面鲜艳明亮无灰暗、情绪外化明显、画幅16:9。
不管哪种方式,前提是每一步的提示词都设计好了交接点——输出什么、输入到哪、格式是否结构化。这套提示词已经把交接点设计清楚了,分镜表是Markdown表格格式,列名固定,机器可解析。未来想自动串联,骨架已经在了。
工具清单
整套流程只用国产平台。推理、改编、提示词生成、配音脚本整理,用豆包。出图、图生视频,用即梦或豆包。TTS配音,用剪映AI配音或豆包TTS。剪辑,用剪映。全程不需要Midjourney、Runway、Sora这些海外工具,也不需要付费软件。
最后
一首诗,从二十个字变成一部30秒的Q版动画短片。中间经过推理、拆解、记忆编码、分镜、出图、出视频、配音、剪辑、自查,九个环节,全部AI辅助完成。
不追求画面极致,只求让小朋友看一遍就记住。一切画面、口诀、镜头都为这个目标服务。想看的朋友们点个关注,后面根据大家的需求持续更新。

