AI 短剧画面已经能以假乱真,台词还是一群豆包在聊天
- 2026-11-17 18:25:42
台词像一群豆包,不是哪一家模型的问题。换成 Kimi、DeepSeek、Claude,写出来还是同一个味道。
三件事叠在一起:剧本由同一个人一次写完,对齐训练让模型爱说标准答案,配音自带播音腔。
口碑好的作品,解法出奇一致:画面交给 AI,台词和声音交回给人。
我做后端这些年,每天拿新 AI 工具干真活。让模型写文案时,我总撞见同一个毛病。想看我接着拿新工具试出什么边界,关注一下。
一、一部修仙剧,闭上眼分不清谁在说话
最近刷到一部 AI 古装短剧,讲一个十六岁参透胎中之谜、想起前世的少年。画面确实好:服化、光影、脸都稳,放两年前没人敢信是生成的。
可一开口就出戏。父亲、师尊、反派、同门,音色各不一样,句式却是同一套:每句都完整、讲道理、立场鲜明。
时不时还来一句能截出去的金句。闭上眼睛听,你分不清是谁在说话。
这不是个例。2026 年 9 月,腾讯新闻的报道里,「宁可少讲点,也不能坏了规矩」这类台词被网友玩成了梗。
相关讨论播放量 700 多亿,同一句话在川菜厨师、绣娘、饺子店老板娘嘴里轮番出现。经济观察网干脆拿「不烧心的台词」做了标题。
二、这几年,画面、脸、嘴型一块块补上了
按时间排一遍,就知道台词为什么是最后剩下的那块。
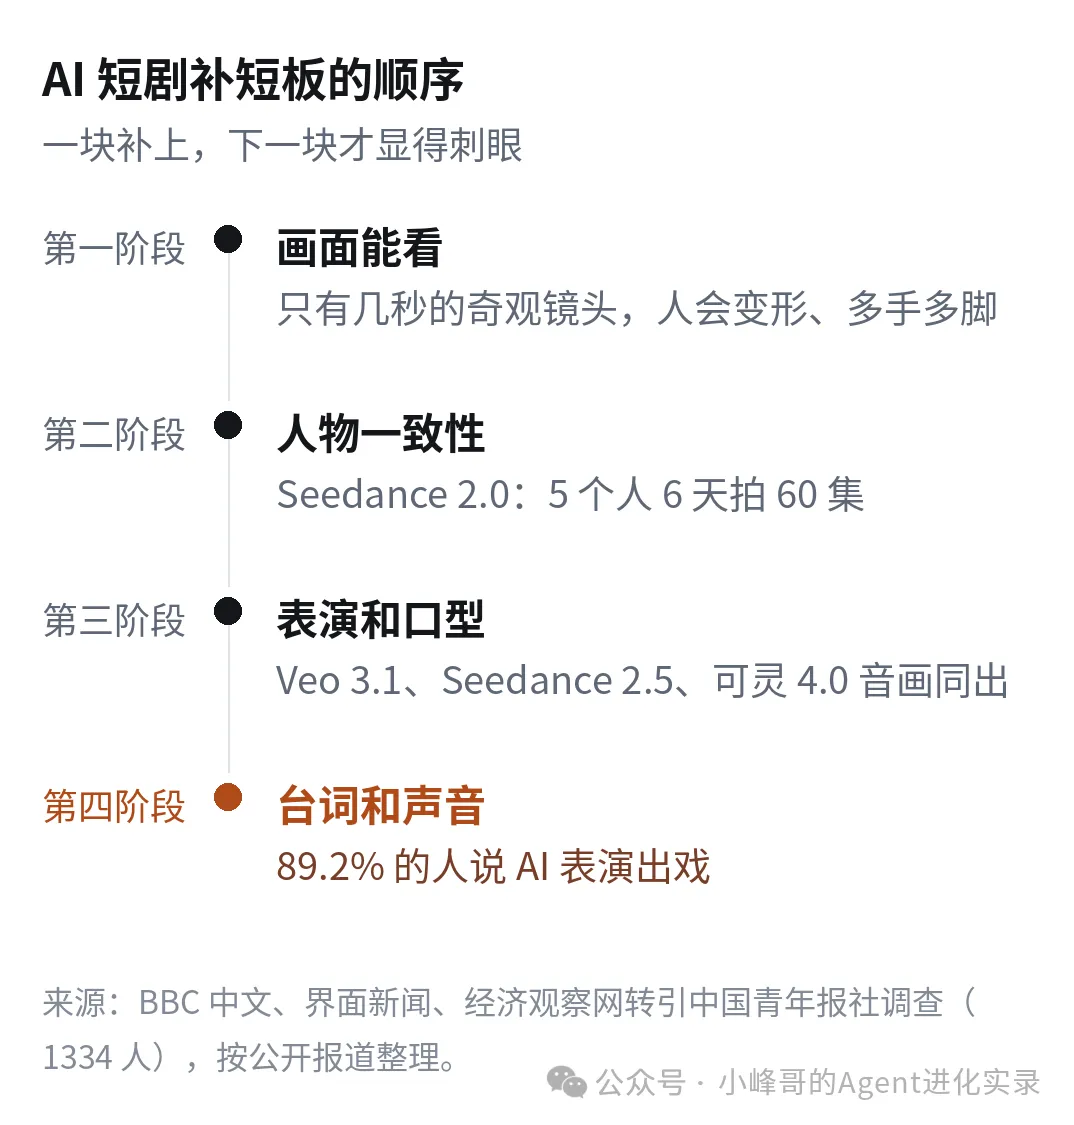 四个阶段按公开报道整理的顺序,不是官方路线图。
第一步是画面能看。早期 AI 视频只有几秒,人会变形、多手多脚,只能拍奇观镜头。
第二步是人物一致性。短剧要连拍几十集,同一张脸不能换来换去。
2026 年 2 月,字节发布 Seedance 2.0。
BBC 中文 6 月的报道里还有个数字:5 个人 6 天做出一部 60 集的剧,成本不到真人短剧的十分之一。
第三步是表演和口型。2025 年 5 月,Veo 3 第一次让画面直接带出对白,10 月的 Veo 3.1 把音频做得更细。
到这一步,眼睛被喂饱了,注意力自然落到耳朵上。
第四步是台词和声音。这一步,现在是卡住的那一块。
中国青年报社社会调查中心问了 1334 人:89.2% 觉得 AI 表演有出戏的地方,49.4% 说表情空洞(经济观察网转引)。
这句话里的出戏,说的是表演和台词,不是服化光影。
所以「几个豆包在对话」不是行业退步,是别的地方都追上来了,这块短板才显得刺眼。
现在这一代,嘴对上了,说的还是同一套话
拿 Sora 当参照的,得换了:它已经停了。网页和应用 2026 年 4 月 26 日下线,API 9 月 24 日关闭。
这一年补的全是「怎么说」。音画同出基本成了标配,表情和口型也越对越准。
Seedance 2.5 和可灵 4.0 都能一次拍 30 秒,可灵还带双声道。
再往下,给一段音色参考,角色音色就定住了。
MiniMax H3 支持 11 种对话语言,可灵的中文分北京、四川、粤语口音,官方样例里有人轮流讲话。
还差的也具体。Runway 引 Google DeepMind 的话:自然连贯的说话声,尤其短句,还在研发中。
字节在 Seedance 2.5 发布文里也承认,极多主体交互时,稳定度还要提。
音画同出也不是家家都有。Runway 的 Gen-4.5 自己不生声音,得靠可灵、Seedance 出声,或后期配。
可这些都在「怎么说」。台词「说什么」还是同一个文本模型写的,声音越像人,同一套金句越扎眼。
三、三个原因,换哪家模型都一样
一个模型替所有人说话
流水线的典型做法是:买剧本,或者让模型直接写,抽卡师按分镜出画面,台词跟着剧本走。
剧本用哪家模型?娱乐资本论问过从业者:有人说「多数时候用 GPT」,也有人要求低的就用豆包。
不管用哪家,问题都一样:主角、反派、路人都是同一个作者写的,模型只是给它们贴上「霸气」「阴险」的标签。
界面新闻让 6 个模型各写 5 集商战剧,一共 30 个剧本。每一个都出现了「良心」,80% 出现了「规矩」。
更极端的是一个剧本拍好几遍。制片人任绎朵对经济观察网说,平台会把一套剧本分给七家 AI 公司同步生成,只换虚拟人脸和背景。
对齐训练让模型爱说标准答案
这一层有研究撑着。四篇论文说的是同一件事。
《Verbalized Sampling》指出,人给训练数据打分时偏爱「更典型、更眼熟」的文本,输出就被推向少数几种最常见的说法,也就是 mode collapse。 《We're Different, We're the Same》发现,不同厂家的模型之间,比不同人之间更像。换一家模型,不等于换了一个作者。 《Do LLMs Always Tell The Same Stories?》测了 10 个模型,越前沿的越往「平均故事」上收敛,负面提示和调高温度都救不了多少。 《PersonaWeaver》点出「助手人格」:模型写的角色总站在道德正确的一边,有问必答,很少回避或打岔。
真人吵架会抢话、说半截、答非所问。模型最不会写的,恰好就是这种话。
配音的腔又把差异抹了一遍
就算台词写好了,配音也会把差异抹掉。
SinCoSphere 的配音指南提到,预置音色自带播音腔、客服腔,加「带哭腔」「咬牙」这类提示,读出来还是播报。
音画同出模型如果用了朗读腔的参考音频,连节奏也一起学走。
再加上成本。方正证券的研报里,AI 短剧中档制作每分钟 800 到 1200 元。
这个价位上,没人愿意给配角单独请编剧和配音演员。
四、做得好的作品,都在同一处使劲
我找了几部台词和配音不像同一个模型在说话的作品。路数不一样,方向一样。
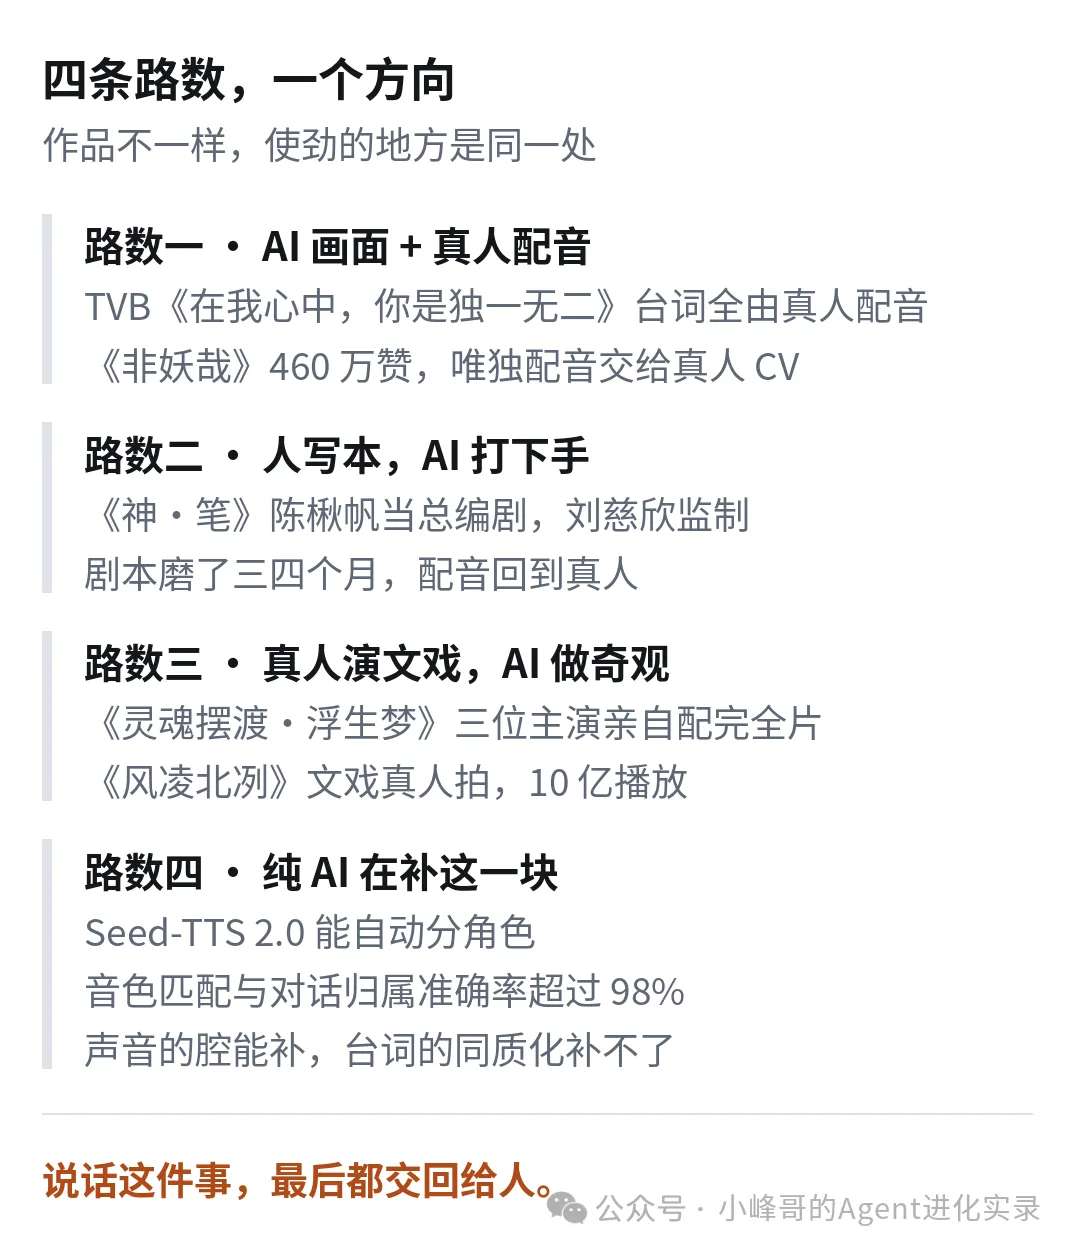 四条路数按公开报道整理,不是官方分类。
路数一,AI 画面加真人配音。TVB 的《在我心中,你是独一无二》,台词全由真人配音员演绎。
观众挑出了表情僵硬、动作卡顿,却很少说声音出戏。
《非妖哉》累计获赞超过 460 万。作者用 LibTV 一个人包了剧本、分镜、画面、剪辑,唯独配音交给真人 CV。
路数二,人写本,AI 打下手。《神·笔》改编自陈楸帆的小说,他本人当总编剧,刘慈欣做文学监制,剧本磨了三四个月。
导演说得很直接:试过 AI 配音,瑕疵还在,最终还是以真人配音为主。
路数三,真人演,AI 做奇观。《灵魂摆渡·浮生梦》三位原班主演亲自完成全片配音,每版 AI 形象都由本人确认。
《风凌北冽》的文戏、情感戏、近身武打都由真人拍。妖兽、宫殿、法术对决、边关战场这些大场面,交给 AI。
全网播放破 10 亿。
路数四,纯 AI 也在补。豆包语音的 Seed-TTS 2.0 能读整章上下文、自动分角色,音色匹配和对话归属准确率超过 98%(官方数据)。
声音的腔正在被拆开。但台词本身的同质化,靠声音解决不了。
五、接下来会怎么变
我的判断有三点,前两点有迹可循,第三点是推测。
分层会越来越清楚。低价流水线继续出「烧心体」,被笑一轮就换套模板。界面新闻发现「烧心」在新剧本里一次没出现,猜是进了禁用提示词。 台词会变成新的工种。像抽卡师一样,值钱的是能给每个角色定说话方式的人:口头禅、句子长短、怎么回避、对谁用什么口气。 模型层面会出现针对性的修复。像 Verbalized Sampling 那样一次要多个候选、再挑不那么典型的,迟早会被做进短剧工具链。
到那时,「闭上眼睛能不能分出谁在说话」,会成为判断一部 AI 短剧及格与否的标准。
画面追上了,嘴也对上了,最后差的是人味。这一块,现在还得靠人来补。
下次看剧,先闭上眼听半分钟
分不出谁在说话,就别指望它能让你追下去;分得出,说明台词这一环没省钱。
AI 能力边界这条线我会继续跟:视频每补上一块短板,都会顺带抬高一次对「人还剩下什么」的要求。
下一块我盯着的是声音——真人声音能授权到什么程度,界线在哪儿。
点上面的名片关注,顺手设个星标。
参考链接
界面新闻 / 娱乐资本论:《6大AI、30个剧本实测》 https://www.jiemian.com/article/15232583.html 界面新闻:《"真人+AI"为何成了行业新解法?》 https://www.jiemian.com/article/15112620.html 腾讯新闻:《短剧"制式台词"遭群嘲》 https://news.qq.com/rain/a/20260929A0AY6W00 经济观察网:《"不烧心"的台词,"烧心"的AI短剧》 http://www.eeo.com.cn/2026/1020/1070258.shtml BBC 中文:《中国AI短剧是怎样炼成的?》 https://www.bbc.com/zhongwen/articles/c0ey9jyw37po/simp Seedance 2.0 论文《Seedance 2.0: Advancing Video Generation for World Complexity》(摘要写明 2026 年 2 月初在中国发布) https://arxiv.org/abs/2604.14148 字节跳动 Seed:《一镜成片,随心参考|Seedance 2.5 正式发布》(2026-07-31,单次 30 秒、最多 30 图/10 视频/10 音频参考;文末承认极多主体交互仍需提升) https://seed.bytedance.com/zh/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5 快手科技投资者关系:《可灵 AI 新一代模型 Kling 4.0 正式上线》(2026-10-17,10 月 15 日上线、单次最长 30 秒、音色参考) https://ir.kuaishou.com/zh-hans/news-releases/news-release-details/kelingaixinyidaimoxingklin1g-40zhengshishangxian/ xiaohu.ai:《Kling 4.0 官方发布页整理》(双通道立体声、多语种与方言、表情与口型匹配改善、多人轮流讲话样例) https://xiaohu.ai/article/kling-4/ MiniMax:《MiniMax H3 正式开源》(2026-08-03,4–15 秒、32 kHz 立体声、稳定支持 11 种对话语言) https://www.minimax.cn/news/minimax-h3-open-source Runway:《Can AI generate videos with sound?》(引 Google DeepMind 对自然连贯语音的说明;Gen-4.5 不生成内嵌音频) https://runway.com/resources/can-ai-generate-videos-with-sound llms.blog:《Best AI Video Generators in October 2026》(2026-10-19,Veo 3.1 与各家 30 秒能力对照) https://www.llms.blog/posts/best-ai-video-generators-in-october-2026-kling-4-0-seedance-2-5-veo-runway-and-more 钛媒体:《刘慈欣监制,AI科幻短剧〈神·笔〉》 https://www.tmtpost.com/7876025.html 新浪财经:《对话〈非妖哉〉主创》 https://finance.sina.com.cn/roll/2026-09-05/doc-iniquyir0524256.shtml 电影界:《TVB香港首部AI短剧》 https://www.dianyingjie.com.cn/2025/1009/398308.shtml 新浪科技:《豆包语音「AI多人有声剧」方案》 https://finance.sina.com.cn/tech/roll/2025-10-27/doc-infvisyr0574087.shtml SinCoSphere:《AI 短剧配音怎么做》 https://sincosphere.cn/learn/ai-voice-for-drama/ Google DeepMind Veo https://deepmind.google/models/veo/ OpenAI 帮助中心:《Sora 停服说明》(网页与应用 2026-04-26 停用,API 2026-09-24 停用) https://help.openai.com/en/articles/20001152-what-to-know-about-the-sora-discontinuation Verbalized Sampling https://arxiv.org/abs/2510.01171 We're Different, We're the Same https://arxiv.org/abs/2501.19361 Do LLMs Always Tell The Same Stories? https://arxiv.org/html/2606.17350v1 PersonaWeaver https://arxiv.org/html/2601.03396v2

