做AI短剧之前,先看这6张事故报告单
- 2026-11-17 12:05:58
刷到 AI 生成的 10 秒视频时,很多人会冒出一个念头:现在做一部 AI 短剧,是不是一个人就能搞定?
画面不差、配音有工具、剧本可以让大模型写——看起来一个人顶一个剧组。
但真开工之后,大部分人会卡在同一批地方。这些问题并不新鲜,在创作者的复盘帖和平台方的分享里反复出现,只是很少被整理到一张清单上。今天的这篇不讲教程,讲翻车:我们把它做成 6 张「事故报告单」,每张单子固定四个栏目——现场还原、误诊、真凶、处方。适合两类人:正打算开机的,和已经翻过车、但不知道哪一步错了的。
No.1 演员「换脸」了
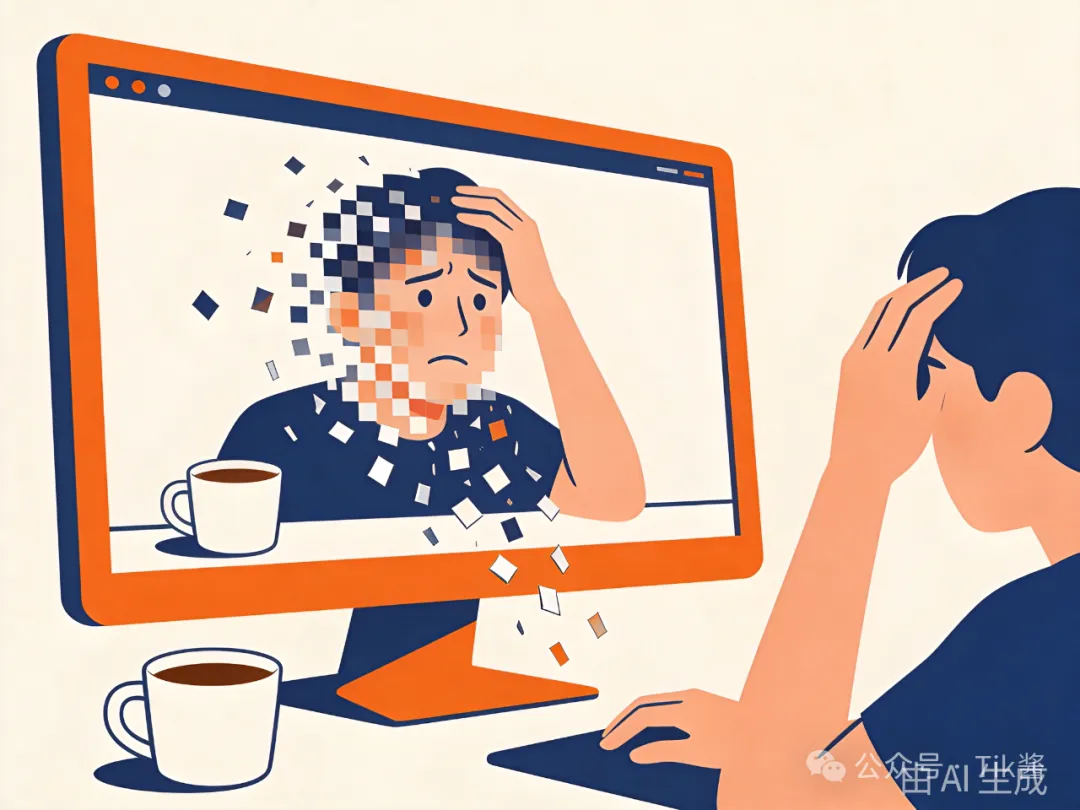
现场还原:第 3 镜和第 12 镜的主角,看起来像两个人。发型变了、眼距变了、年龄感也变了,观众在评论区问:这是换演员了吗?
误诊:以为是工具不行,换一个模型就好了。结果换完,脸照样漂。
真凶:角色信息只活在提示词里。角色描述每次复制粘贴、每次微调,都会引入细微偏差,累积到十几个镜头之后就会明显「走形」[1]。
处方:
把角色从「一段描述」变成「一个资产」:角色卡上同时放固定描述、可复用提示词和参考图,整部剧内不再随意改动;
跨镜头一致性靠三件事叠加:稳定的角色描述、清晰的参考图、逐镜头的人工检查——第三件不能省[2];
每个角色卡至少写清年龄段、体型、发型、服装、标志性特征。只写「帅气男主」这四个字,约束不了任何生成结果[2]。
事故等级:高发。换场景之后必查。
片场便签:任何工具宣称「上传参考图就不会变脸」,都要打折听。参考图是一致性管理手段,不是一致性保证[1]。
No.2 抽卡抽到肉疼
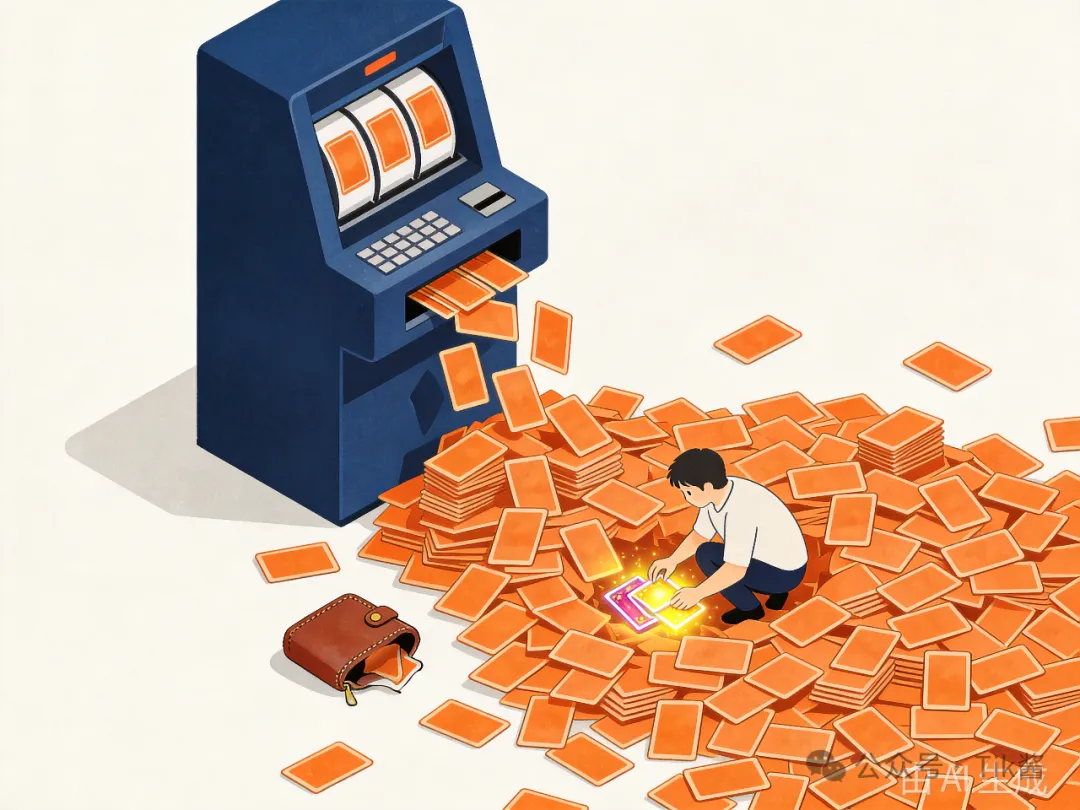
现场还原:一个镜头不满意,反复重抽。一晚上过去,钱包和心态一起空了。
误诊:一定是我提示词写得不够好。
真凶:不稳定的模型 10 抽 1、20 抽 1,而现在的工具按调用次数收费——生数科技解决方案负责人郑重的原话是:生产场景里,可控比单次惊艳重要得多;一个十次里九次没法用的模型,本质上只适合做能力探索,不适合做生产力[3]。
处方:
选工具时别只看上限,看下限:稳定满足要求的比例,比偶尔惊艳一次重要[3];
抽卡失败先停手,判断问题出在哪:是参考图不对、提示词自相冲突,还是这个镜头的动线本来就超出模型能力,再决定改哪一个[2];
盲目重抽是成本黑洞:定位问题比多抽三次便宜。
事故等级:中高发,且随镜头数放大。
No.3 剧本写飞了
现场还原:让 AI 连写 5 集,单看每段都挺顺,连起来不知道在干嘛。人物像按设定表打卡,戏不好看。
误诊:AI 写作能力不行,再换个模型试试。
真凶:两个。一是结构——大模型连续写三五集剧情没问题,但整部剧的走向交给它,会写飞[3];二是人物——你给角色一个「小气」的标签,模型会特别忠实地让他在每个情节都小气,但一个只有单一特质的角色是工具人,工具人多,戏就不好看[3]。
处方:
人定骨架,AI 填血肉:主题、结构、人物弧光这些「好作品的定义」由人来定,AI 负责展开和填空。把「需求定义清楚」本身当成一项专业工作,而不是一句话甩给模型[3];
每个主要角色要有目标、有弧光、有一部分观众能代入他,而不是一个性格标签[3];
分集大纲和人物小传自己写,再交给 AI 拆分镜。
事故等级:高发,且不易察觉——因为单段读起来都挺好。
No.4 一键批量,一键团灭
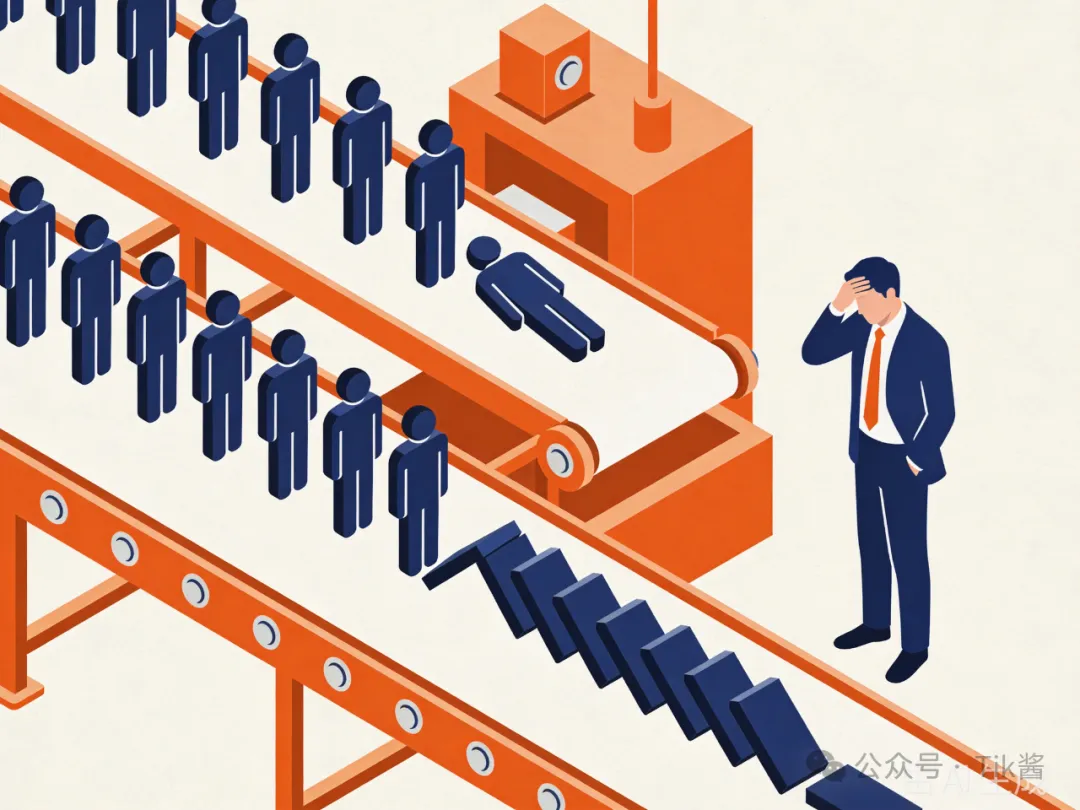
现场还原:为了省事,把几十个镜头丢给一次「批量生成」。结果第 7 镜不对,整批重来,而且说不清是哪一步偏了。
误诊:批量功能不好用。
真凶:把「批量生成」理解成「一个生成器把所有镜头混在一起生成」。合理的批量是分组对应——每个镜头一个独立任务,可以分别调整参考图和提示词;某个镜头失败,只需要重做那一个[1]。
处方:
按镜头建独立任务,逐个可调、可单独重生成[1];
批量创建前,逐条确认每个镜头的角色引用没挂错;批量生成后,逐条筛一遍,别让问题流到视频环节[2];
同一场景的镜头集中处理,减少光照和风格断层[2]。
事故等级:中发,但一旦发生就是整批返工。
No.5 画面全齐了,嘴对不上
现场还原:做完所有镜头才去配音,结果台词长度和画面节奏对不上,要么补镜头,要么改口播,剪辑表推倒重来。
误诊:配音工具不好用。
真凶:流程顺序错了。配音、试听、裁剪、变速这些音频环节,应该和画面对齐着做,而不是留到最后[2]。
处方:
每做完一批镜头就配一轮音,画面和台词的时长互相校准[2];
复杂混音和多轨精剪交给专业剪辑软件。把 AI 平台当作「从剧本到可用素材」的环节,把剪辑软件当作「最终打磨」的环节[2]。
事故等级:只要流程顺序错了就一定出现,改流程后基本绝迹。
No.6 镜头一动,人就碎了
现场还原:提示词里写了「剧烈奔跑、快速转身」,生成出来人物肢体变形,抽了十次卡,次次碎。
误诊:模型画不好动作。
真凶:运动幅度给太大。短剧镜头多数是稳定机位或轻微推拉,描述成剧烈运动,人物很容易形变[2]。
处方:
先求稳,再求动:能用固定机位讲清楚的,别上大幅运镜[2];
重视首帧:分镜图往往就是视频的首帧,首帧里人物的朝向和视线,直接影响后面几秒动作合不合理[2]。
事故等级:高发于动作戏爱好者。
开机前 60 秒自查表
把上面六张单子折成七条,开机前过一遍:
主要角色有资产卡了吗?还是只有一段提示词?
角色卡写清了年龄、体型、发型、服装、标志特征,并配了参考图吗?
分镜表里每个镜头都关联到角色和场景了吗?
剧本的结构和人物弧光,是人定的还是全交给模型了?
批量生成是「按镜头分组」还是「一锅炖」?
台词节奏和画面,是边做边对齐,还是打算留到最后?
运动幅度,是不是按「稳定机位优先」设计的?
这七条都过完,再按下生成键。返工量不一定归零——生成模型本身有随机性,同一条提示词两次生成也可能有细微差别——但至少返工是「局部重做」,不是「整集重来」[2]。

