AI 短剧只做了一半:剩下那一半是声音
- 2026-11-19 01:02:16
有个判断,做 AI 短剧的人大概都听过:观众能接受画面假,但接受不了声音不对。
这句话是有道理的。画面里的人物稍微假一点,观众会把它当成风格;可只要人声和嘴对不上,或者整段片子安安静静只有背景音乐,那股廉价感立刻就出来了。
问题在于,现在画面这一半已经被卷得很厉害了。模型三个月一更新,大家都在拼画质、拼一致性、拼镜头。而声音那一半,很多人还停留在「配一段 AI 配音,再随便找首歌垫上」。
这一篇就讲剩下那一半怎么补。它是目前投入最小、回报最陡的一块——不需要更好的显卡,也不需要重新生成任何一帧画面。
一、声音不是「配音」,是四层
新手最容易犯的第一个错,是把声音当成一个东西:找个人配个音,完事了。实际上一条片子里的声音是四层叠在一起的,缺哪一层,观众都能感觉到,只是说不出来。
第一层,人声。台词、旁白、喊叫。这是唯一不能缺的一层,观众的信息主要靠它接收。
第二层,环境底噪。房间里的空调声、街上的车流、雨声、办公室的键盘声。这一层最不起眼,但它负责告诉观众「这个地方是什么样」。没有它,人物像站在一个真空里说话。
第三层,音乐。情绪靠它推。紧张、委屈、反转,观众的情绪反应有一大半是音乐给的。
第四层,音效。脚步声、门响、杯子放下、纸张摩擦、衣服的窸窣。这一层是细节,也是性价比最高的一层——加和不加,差别很大,花的力气很小。
你可以拿自己那条片子做个测试:把音乐和音效全关掉,只留人声听一遍。如果这时候觉得干得没法听,说明底噪层是空的;如果觉得听不出情绪,那是音乐层的活儿没做。
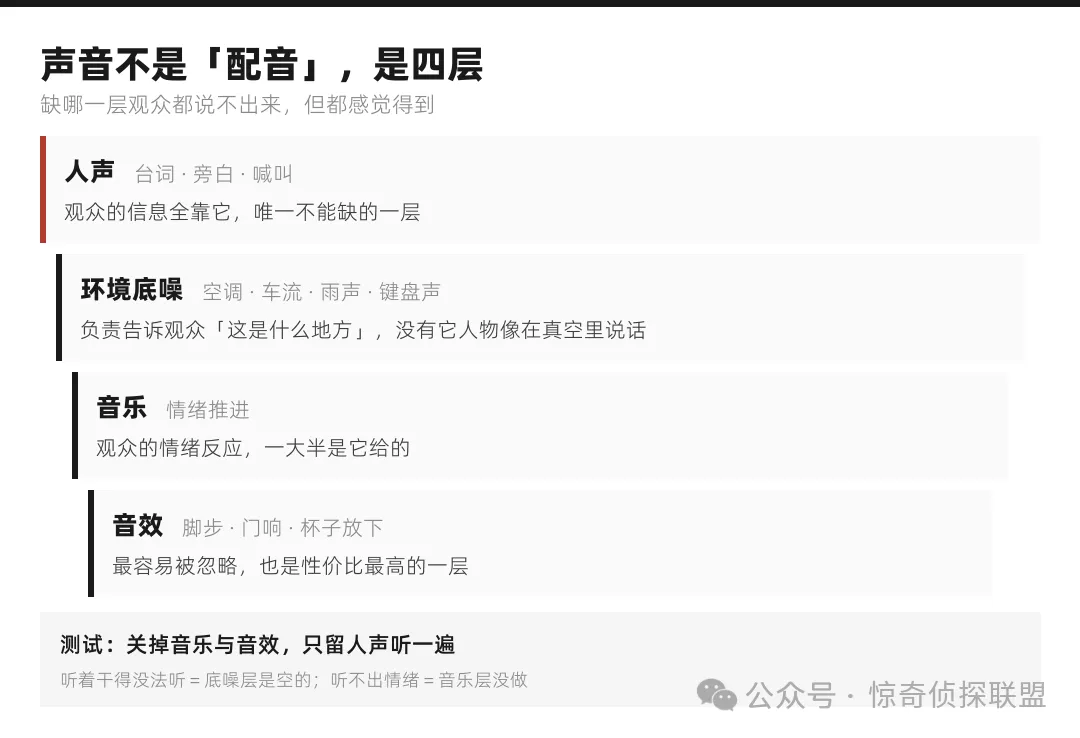
四层声音,缺哪一层观众都说不出来,但都感觉得到
二、顺序比内容更重要
如果只记一条,记这条:人声 → 环境 → 音乐 → 音效。每一步做完再进下一步,不要同时铺。
为什么音乐要排在这么后面?因为音乐是最容易掩盖问题的东西。你一上来先垫一首带感的歌,再听台词,会觉得「好像还行」——其实那首歌把所有的断句别扭、情绪不对、音量忽大忽小都盖住了。等到导出成片,在手机外放上一听,全露馅。
正确的做法是先把片子在没有音乐的状态下听懂。台词清不清楚、节奏对不对、情绪到没到位,都在这一步解决。确认过了,再上音乐,你才知道音乐该在哪个点进来、什么时候该让开。
四步各自的验收标准也不一样:
人声这关:关掉画面,只听声音,能听懂全部剧情。
环境这关:每个场景有自己的底噪,换场景的时候底噪也跟着换。
音乐这关:有台词的地方,音乐退到后面去;情绪点上它才推上来。
音效这关:关键动作都有声,但没有任何一处盖过人声。
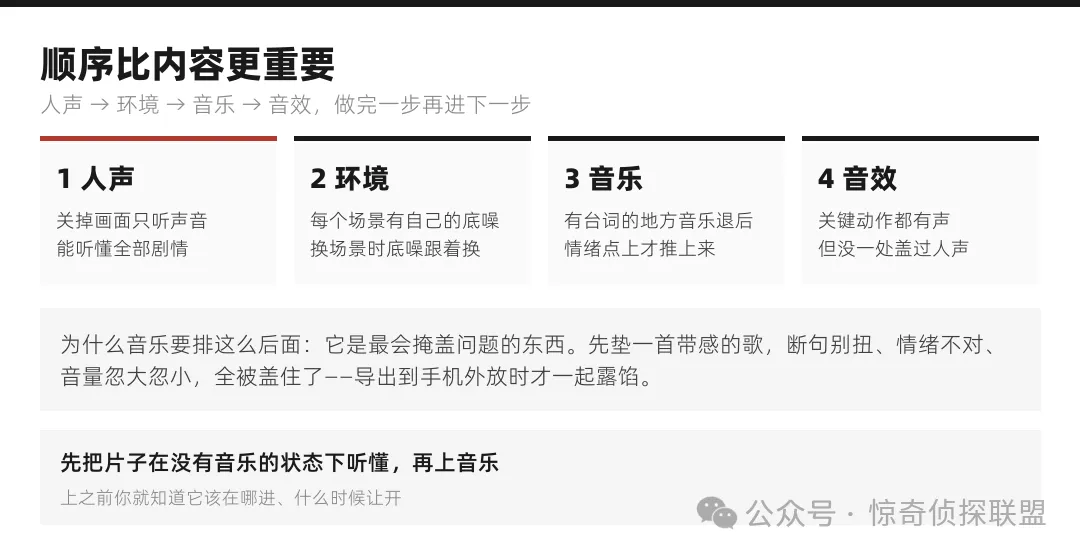
四步顺序,以及每一步的验收标准
三、人声:听三件事,别只看「像不像」
现在 AI 配音的音色已经很自然了,所以挑音色的标准不该是「像不像真人」,而是下面这三件事。
断句自不自然。同一句话,在哪里停、停多久,决定了它像人说话还是像念稿。AI 最容易出的毛病是一口气读完,中间没有呼吸。
重音落在哪。「我没说过这句话」,重音放在「我」「没」「这句话」,意思是三句不同的话。AI 默认会把重音放得比较平均,需要你手动标一下。
语速跟不跟得上画面。配音太长,镜头就得拖;配音太短,情绪还没出来就切走了。
还有一个新手常踩的坑:拿一个音色配完全场。主角、配角、旁白全用同一个声音,观众分不清谁在说话,听着听着就累了。至少给主角和旁白各配一个,两个人音色拉开一点距离。
另外,AI 读的是你给的文字。书面语念出来一定别扭,把台词改成能说出口的短句再喂进去,这一小步的收益比换工具大得多。台词里标上情绪(愤怒、低沉、犹豫)和停顿(用逗号和省略号都能影响节奏),出来的效果差别很明显。
四、口型对不上时,优先保什么
这是新手问得最多的问题。配音生成好了,放进时间线,发现人物的嘴和声音对不上。
处理顺序是这样的,从上往下试:
第一优先:改镜头长度去贴声音。不要让配音迁就画面,反过来做。先定配音时长,再按它去裁镜头——镜头短了就让它多留半秒,长了就提前切。画面是可伸缩的,台词不是。
第二优先:把嘴藏起来。这招最省事。说话的时候让角色背对镜头、侧脸、或者用手和下巴挡一下;也可以切到听的人的反应镜头,让说话的人不出画。观众完全不会觉得有问题,反而觉得你会拍。
第三优先:做口型同步。现在有工具能把配音驱动到画面上,让人物的嘴跟着动。效果最好,代价是要多跑一遍生成、多花算力,而且不是每个镜头都稳。建议只用在关键的特写上——一场戏里留一两个正脸说话的镜头做同步,其余用前两招带过去。
这个顺序背后的取舍是:声音是准的,画面是软的。观众记住的是那句台词,不是那个镜头多长。
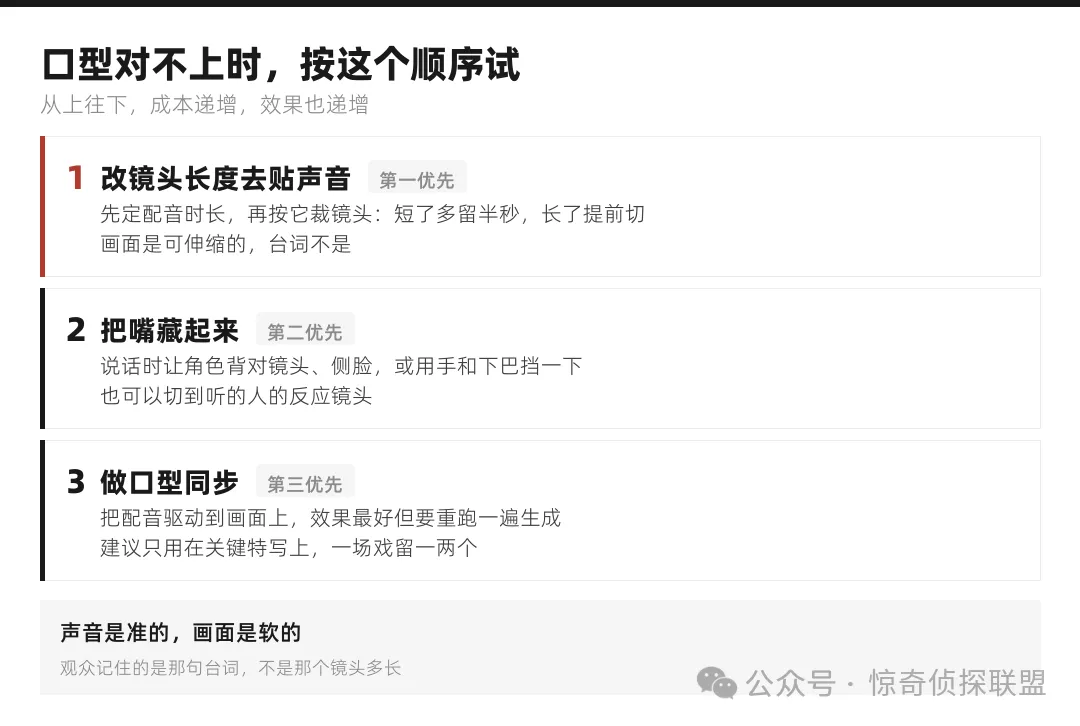
口型对不上时的三条路,按这个顺序试
五、音乐:分段、卡点、给台词让路
配乐最常见的做法是「全片一首」,从开头放到结尾。这样最省事,也最容易把片子做平——因为没有起伏,观众的情绪从头到尾一条直线。
更好的做法是按情绪段落分段。一分钟左右的片子,通常切成两三段就够:开场一段、转折一段、结尾一段,段与段之间用淡入淡出接上。每一段只负责一件事,别贪心。
再就是卡点。把剪辑点对齐到音乐的鼓点或者旋律转折处,成片质感会立刻不一样。这一步不花钱,只是多拖几次时间线,但它是新手和专业感之间最短的一段距离。
关于音乐来源,提醒一句:随便搜一首热门歌用上去,是最容易踩的坑。用工具按情绪生成一段专属配乐,既贴合剧情,也从根上绕开了版权问题。生成时可以给出情绪、乐器、节奏这些条件,比在曲库里翻要快。
六、音量:一张表,照着调就行
声音做完了,最后还要排一下谁大谁小。这一步叫混音,听着专业,其实新手只要记住一个原则:人声永远第一,其他都让路。
常用的经验区间是这样的:
人声:-12 到 -6 dB。这是主轨,其他一切都以不影响它为准。
音乐:-20 到 -18 dB,一到台词进来就再压低一些。有歌词的人声和台词叠在一起是最难听的,能不用带人声的歌就不用。
音效:比人声低,但要比音乐高一点点,动作类的可以短促地冲一下。
整体响度:短视频平台常见的参考值在 -14 LUFS 上下。这个数字不用死记,你只要做到同一集里音量别忽大忽小、相邻两集之间别跳变,就已经比大多数片子强了。
调完之后,别只在电脑音箱上听。用手机外放再听一遍——你的片子九成以上的人是用手机看的,手机喇叭对低频和高频的处理跟电脑完全不同,很多「听着挺好」的混音,到了手机上人声就被音乐糊住了。
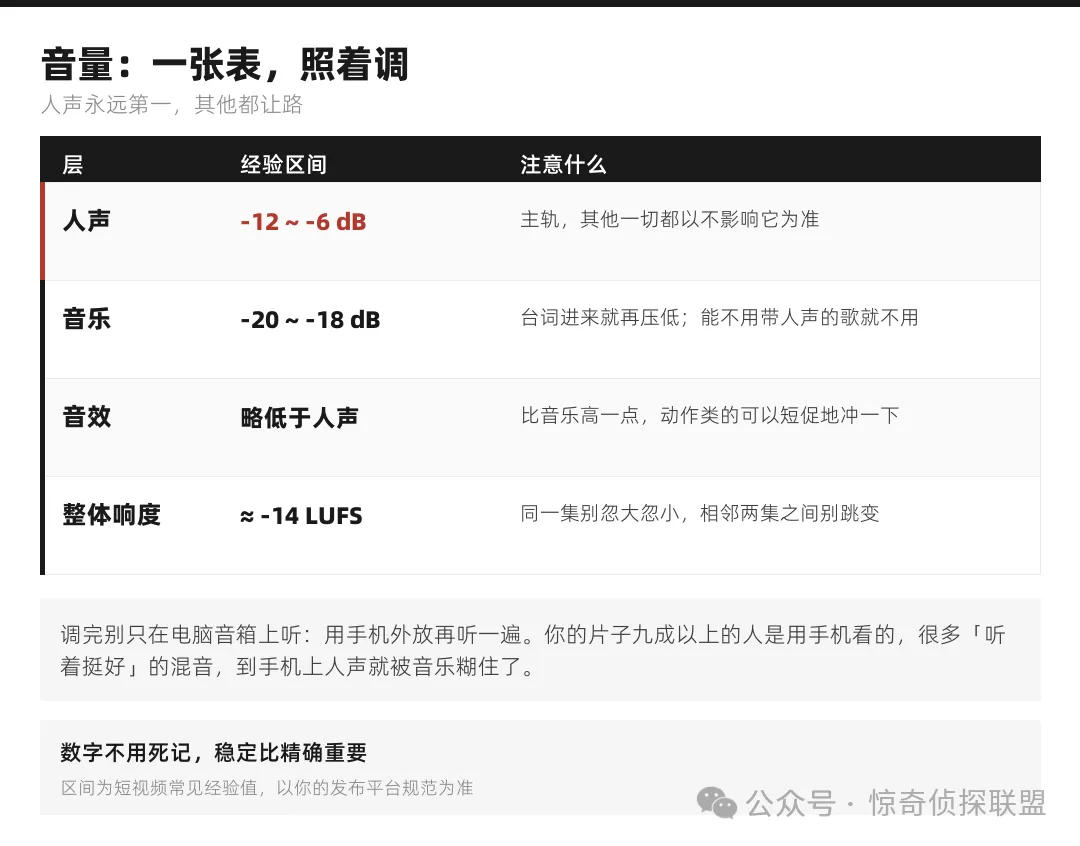
音量层级,以及最后那道手机外放检查
七、没时间的话,按这个优先级做
四层全做当然最好,但新手第一次做,往往顾不过来。这时的取舍顺序是:
第一,语音清晰度。这条是底线。台词听不清,其他全白做。
第二,音乐和情绪对得上。这条决定观众的情绪走向,也最影响完播。
第三,音效细节。这条没做,观众通常说不出哪里不对,但会觉得「差点意思」。所以它是加分项,不是必选项。
反过来说,如果你只有半小时,只做一件事,那应该是给全片铺一层环境底噪。它比想象中管用:一段空调声或者远处的车流声铺在底下,人物立刻就「在那个地方」了,整条片子的塑料感会掉一大截。
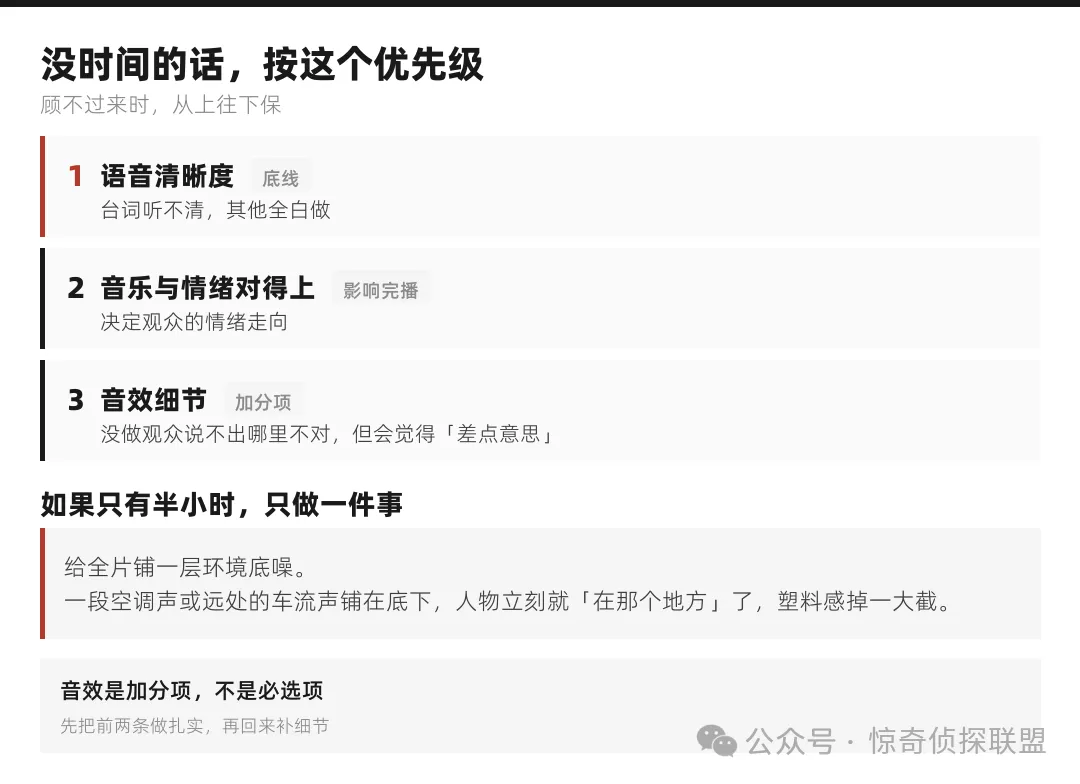
没时间时的取舍,以及最划算的一步
八、今天就能做的一件事
打开你最近做完的那条片子,做一件五分钟就能完成的事:把画面关掉,只听声音,从头到尾听一遍。
背对着屏幕听,或者干脆把窗口最小化。你会发现一堆看画面时被忽略的问题——某句台词吞了、某处音乐把人声盖住了、换了个场景底噪却没换。这些问题,看着画面是发现不了的,因为画面会替声音补答案。
听完之后,挑最明显的一处改掉。就一处。
画面这一半,模型还在帮你往前推;声音这一半,从今天起就是你自己能补的。而这一半的边际收益,眼下比再换一个新模型高得多。
说明:文中提到的音量区间与响度参考值,为短视频领域常见的经验区间,不同平台、不同内容类型的要求会有差异,具体以你的发布平台规范为准。音乐与音效请注意使用授权范围,优先使用可商用素材或自行生成的音频。本文不含任何收益承诺。
杭州 · AI 自学会 · 长期开放
一个人容易停在第二周
声音这一半,道理都懂,真到自己片子上往往卡在同一处——知道音乐要给人声让路,可一垫上带感的歌,就舍不得再压下去。
我们有个杭州 AI 自学会的群,平时在里面聊 AI 短剧、AI 漫剧和 AI 内容创作,也有人把自己跑的第一集丢出来让大家挑毛病。下一场线下实操的时间和主题,也会先在群里说。
什么时候进来都不晚,带着你的第一条片子来就行。
点开图片可看大图,长按识别二维码进群

