一个人,5 分钟 AI 短剧,成本 27 块
- 2026-11-18 18:48:36
先看两个数字。同一部 5 分钟的短剧,用开源模型在 RunningHub 上跑,视频那一步花掉 27 块多;换成 Seedance 2.5 按火山方舟官方价,要 1360 块左右。同一批素材、同样的抽卡次数,差 50 倍。
这个差价不是「哪个模型更强」的问题,是成本结构的问题。搞清楚结构,你会发现 90% 的人把力气用错了地方。
这篇把整套流程拆成三段:前期(只花文字和图片的钱)、视频(唯一真正烧钱的环节)、后期(基本免费)。每段给能直接抄的提示词,以及我踩出来的判断。
封面:一个人,一台电脑,一整个剧组
一、你现在缺的不是工具,是分工
先看这段话:「编剧、分镜、美术、摄影、演员、剪辑、制片人」——正常一部短剧要七个人。你只有一个人。
但工具把每一环都拆成了可替换的模块,于是这七个位置可以塌缩成一个:
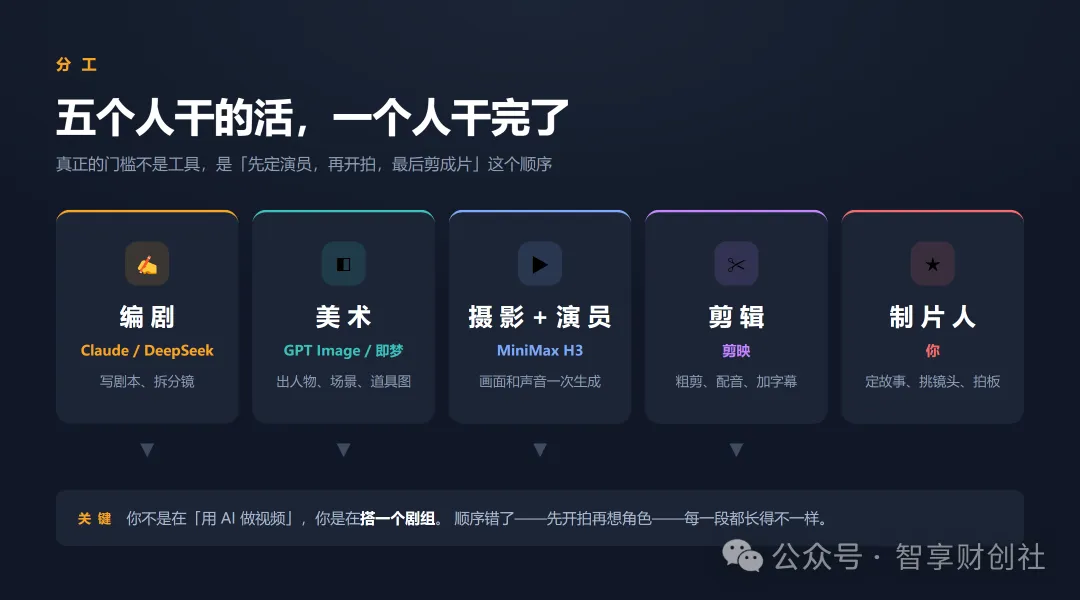
五个人干的活,一个人干完了
真正要盯的不是「用哪个工具」,而是顺序:先定演员,再开拍,最后剪成片。顺序错了——先开拍再想角色长什么样——每一段生成的素材都是不同的人,你会在后期发现白剪了。
二、先把账算清楚:钱花在三段完全不同的地方
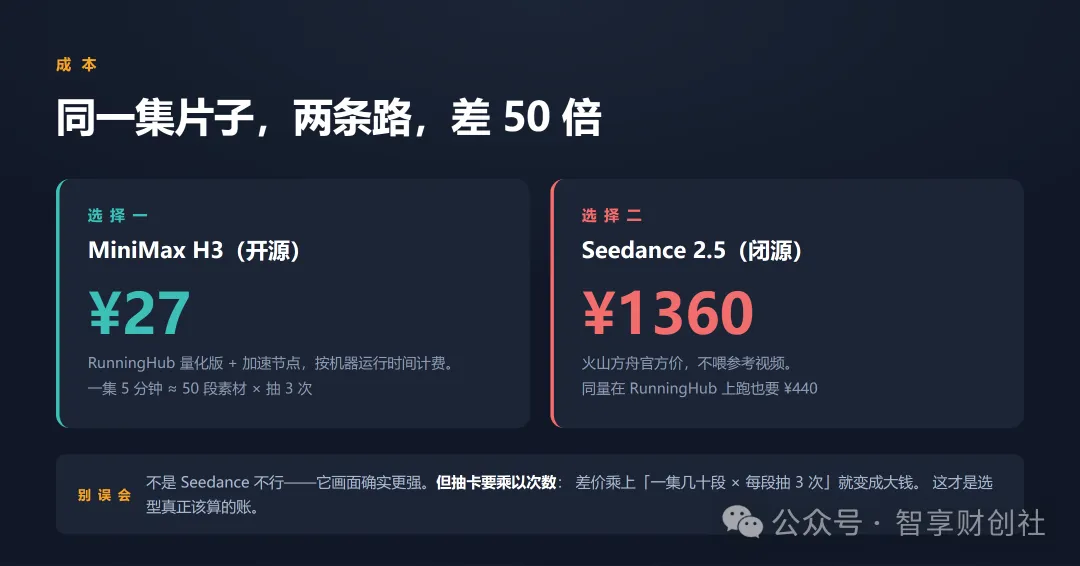
同一集片子,两条路,差 50 倍
这里有个反直觉的结论,很多人是反着来的——
越靠前的环节越便宜,改动成本越低。
前期改一个字不要钱,视频阶段改一次就是抽一次卡的钱,后期改完已经成片了只能重导。
所以「先跑起来再说」在 AI 短剧里是错的。跑起来的那一步,恰恰是最贵的那一步。
1. 前期:剧本、分镜、资产图
这一段只花文字和图片的钱。它的产出是三样东西:一份剧本、一张分镜表、一堆资产图(角色、场景、道具)。
剧本有个特殊要求:只写镜头拍得到的东西。
AI 视频模型看不懂「他心里很难过」,它只看得懂「他低下头,手指攥紧了衣角」。所以给 AI 用的剧本跟给读者看的小说不一样——心理活动必须变成动作、表情,或者明确的内心独白。
另一个容易忽略的点是声音要标清楚类型:当面说的、心里想的、人不在画面里但声音还在的,在剧本里就分开写。这三种如果混着写,AI 会让角色张着嘴把心里话念出来。
篇幅上,一集 5 分钟,台词总量 750 到 1000 字就够(每 10 个字约 2 秒)。开头 3 秒必须出冲突,结尾停在悬念上,不要提前和解。
可直接复制 · 剧本提示词你是短剧编剧,熟悉抖音、视频号上的节奏。把下面的故事改成一集约 5 分钟的短剧剧本。
要求:
1. 开头先列出本集出场人物。
2. 每场戏开头写场景题头:场号 场景名 [内/外] [日/夜],例如:1-1 古镇书院庭院 [外] [日]。
3. 画面和动作每行用「△」开头,只写镜头拍得到的东西。不写「他心里想」,心理活动改成动作、表情,或者内心独白。
4. 台词格式:角色名:(情绪/动作)台词。心里的话写成「角色名(内心独白):」,人不在画面里、声音还在的写成「角色名(画外音):」。
5. 重要的声音写成【音效】……
6. 台词总量 750–1,000 字。开头 3 秒内出现冲突,结尾停在悬念上,不要提前和解。
7. 每句单独一行,只输出剧本,不要解释和分析。
故事:
(粘贴小说片段或你的故事梗概)
手上只有一个点子、还没故事?先让它写 3 版 300 字的故事梗概,挑一版,再用上面这段转成剧本。先选故事,再写剧本,反过来会浪费很多轮。
2. 分镜:新手可以先跳过
剧本写的是「发生了什么」,分镜写的是「观众看到什么」。新手完全可以跳过这一步直接用剧本去写视频提示词,也能出片。对白多、想控制节奏的时候再拆。
拆的时候记住四条:
- 换人说话就切。
一问一答不要一个镜头拍到底,要在说话的人和听的人之间来回切。 - 情绪变了就切。
平静到震惊、震惊到愤怒,每次变化给一个独立镜头。 - 大动作拆三步。
准备、执行、结果。一个镜头塞一整串动作,AI 很容易做乱。 - 换场景、跳时间,必须切。
中间留 1 到 2 秒转场。
时长上有两个数记牢就够了:台词每 10 个字约 2 秒,听的人的反应 1 秒左右。
3. 资产图:先「选角」,再开拍
资产图就是你的演员、片场和道具。H3 一次能喂 9 张参考图,喂进去的图越干净,每一段里的人就越像同一个人。
人物图,五条规矩:
全身、正面、白底,双手垂下,不拿东西,不做表情 一定要写鞋子,不写 AI 很容易出半身图 写清身高、体型、年龄、脸型、发型、服装,和年代对得上 成年角色约 8 头身,反派也别丑得太极端 群众演员不用单独设计
形象定下来后,再出一张角色身份板:正面、侧面、背面全身,加几个表情和姿势。视频模型拿到它,就能从各个角度认出这个人。
别用真人照片当参考,尤其别用明星照片。平台会拦,也有肖像权风险。用 AI 设计的形象,一次生成,长期复用。
场景图,三条规矩:画面里不能有人;和人物用同一种画风;对话戏出三张——正打、反打、再加一张看清所有人站位的大全景。反打在正打图上改就行。
道具图,两条规矩:纯白底、无人无景;写实际尺寸,比如「茶杯直径约 8 厘米,一只手能握住」。不写尺寸,道具在视频里就会忽大忽小。
开拍前花两分钟对一遍四个问题:每个主角都有身份板吗、几个角度是同一张脸吗?场景图里有没有混进人?道具写尺寸了吗?台词总量有没有超过 1000 字?
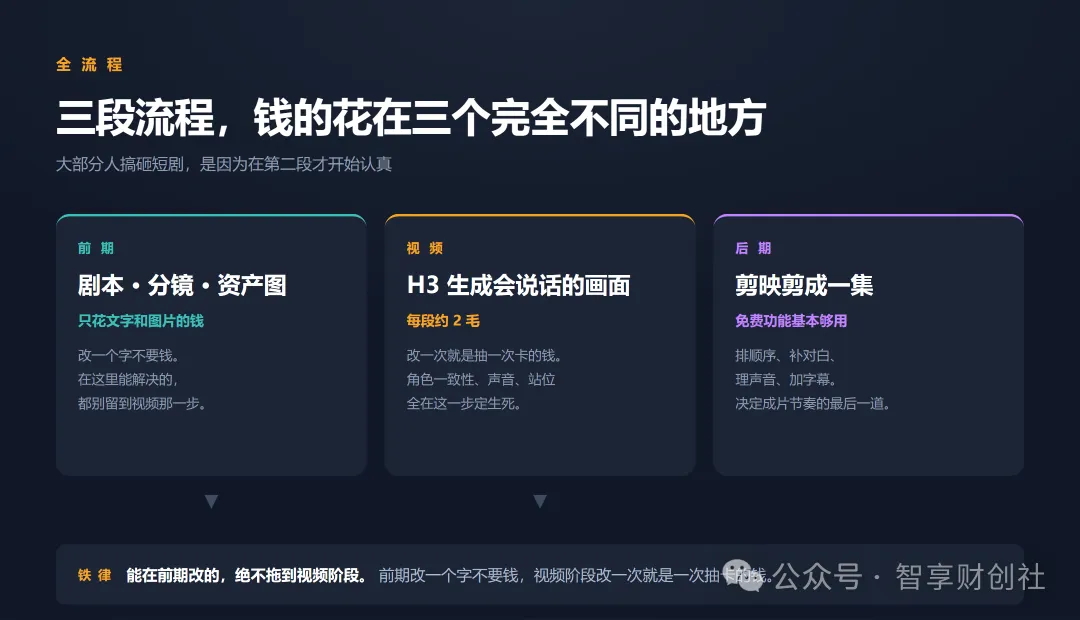
三段流程,钱的花在三个完全不同的地方
三、第一次做,先花一小时跑通 10 秒
上面讲的是完整的一集。但第一次做,别一上来就做 5 分钟。
先做一个 10 秒左右的片段:一个角色、一个场景、一句台词。跑通一次,你就知道每一步大概是什么样子,再回来做完整的一集。
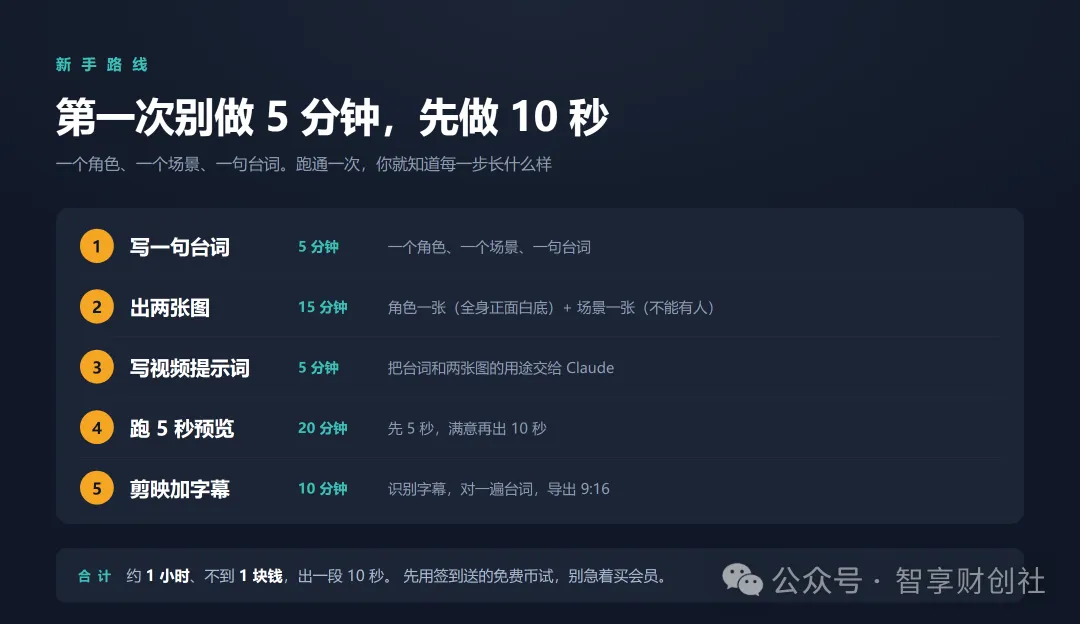
新手路线:一小时出一段 10 秒
这段大概 100 个 RH 币,不到 1 块钱。先用签到送的免费币试,别急着买会员——会员是按月自动续费的,送的币还有有效期,囤着没用反而浪费。
四、视频阶段:真正烧钱的一段
视频用的是 MiniMax 的 H3,在 RunningHub 上跑。这里得先解释两个东西:
- H3
:MiniMax 发布的视频模型,一段最长 15 秒,画面和声音(对白、音效)一次生成,而且已经开源。 - RunningHub
:一个在线跑 ComfyUI 工作流的网站。别人搭好的工作流,你上传图片、填好提示词就能用,不用买显卡、装软件。
为什么不用画面更强的 Seedance 2.5?因为抽卡要乘以次数。一集 5 分钟要几十段素材,每段还不止抽一次,单价差一点乘起来就是大钱。
同一个 10 秒镜头有三档做法,实测下来:
省钱档:只做一采,640P,约 100 RH币,一段 2 毛。练手、跑剧情用。
精细档:一采 + 超分放大,1920 宽,约 185 RH币,一段 3 毛多。发作品用。
极致档:二采,整段再精细采样一遍,1920 宽,约 795 RH币,一段 1 块 5。交付、关键镜头用。
就算一集 50 段全部做到极致档,也就多六七十块,仍然不到 Seedance 官方价的十分之一。选型真正该算的是这个账,不是单秒报价。
1. 视频提示词:一段只讲一件事
短剧和普通 AI 短片的区别是:角色要说话,剧情要一场接一场。所以提示词要比「一个人在走路」细得多。六条规则:
- 一段只讲一件事。
5 到 15 秒,只处理一个动作、一次情绪转折或一句关键台词。 - 先写站位,再写动作。
谁在左、谁在右,门在哪边,道具在谁手里。不写清楚,下一段人就会瞬移。 - 动作接上一段的结尾。
上一段已经站起来了,这一段就从站着开始。 - 台词一字不改,声音分三种写。
当面开口 / 心里的话 / 画外音。 - 镜头别一直盯着说话的人。
台词一长画面就死,中途切到听的人的反应。 - 每张参考图写清用途。
提示词里 @图片1 是羊羊的长相,比一股脑扔进去效果好。
可直接复制 · 视频提示词你是短剧导演,也是 AI 视频提示词工程师。把下面的剧本或分镜表改写成 MiniMax H3 能直接用的视频提示词。
规则:
1. 每段 5–15 秒,一段只处理一个动作、一次情绪转折或一句关键台词。不同场景、不同时间必须分段。
2. 每段开头先写【站位】:谁在左、谁在右,门在哪边,摄影机在哪一侧,关键道具在谁手里、朝哪个方向。
3. 动作接上一段的结尾,不重复上一段已经做完的动作。
4. 台词一字不改。声音分三种写:某某说:「」/ 某某内心独白:「」/ 某某画外音:「」。每句台词写清语气。
5. 参考素材按用途点名:@图片1 = 某某的长相,@图片2 = 场景,@图片3 = 道具……有声音参考的写 @音频1 = 某某的声音。
6. 写具体的光线和镜头:景别、机位、固定还是推拉;说台词时镜头固定,不推不拉。
7. 声音只写台词和看得见原因的音效(脚步声、关门声),不要背景音乐,不要字幕。
8. 先给每个说话的角色写一句固定的声音描述(年龄、音色、语速),之后每一段原样复制这一句。5 秒的段落最多放一两句台词。
每段按这个格式输出:
【素材段落 X】(X 秒)
【参考】@图片1:…… @图片2:……
【站位】……
【画面】0–X 秒:景别,机位,画面里发生什么,人物表情和动作。
【声音】某某说:「……」(语气);音效:……
【禁止】不加剧本里没有的人,不出现现代物品,道具不换手、不消失,人物不瞬移,不改台词,不要字幕和音乐。
剧本或分镜表:
(粘贴在这里)
2. 在 RunningHub 上跑:几个省钱的习惯
注册、找工作流、上传参考图、贴提示词、改参数——这些照着做就行。有三个细节值得单独说:
① 先跑 5 秒预览,满意了再出 15 秒。这是最省钱的习惯,没有之一。
② 多个角色先一个一个单独试。每个角色单独跑一段 5 秒,确认长相对了,再把几个人放到一起出长镜头。一上来就把几个人一起跑 15 秒,失败一次白花一次钱。
③ seed 是固定的,别忘了改。工作流里 seed 固定,意味着同样的图和提示词再跑一次结果几乎一样。想「抽卡」换一版,就把 seed 改个数字;只想微调提示词,就保持不动。
3. 声音一致性:这是短剧最大的坑
短剧最大的看点是角色会开口。但如果这一段是清亮的少年音,下一段变成低沉的大叔音,观众立刻出戏。三个办法,从简单到进阶:
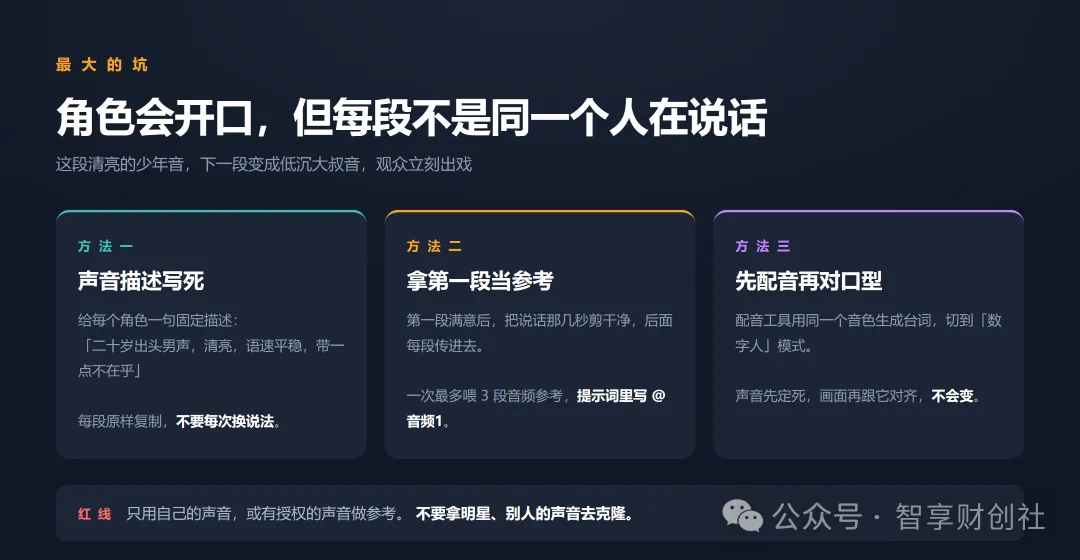
声音三法:从写死描述到先配音再对口型
另外两个提醒:一段别塞太多台词(5 秒放一两句话正好,太长容易对不上口型);只用自己的声音,或有授权的声音做参考。
4. 穿帮了别急着重抽
AI 视频一定会有穿帮:手多一根指头、道具突然变大、人走着走着换了张脸。区别只在你按什么顺序处理。
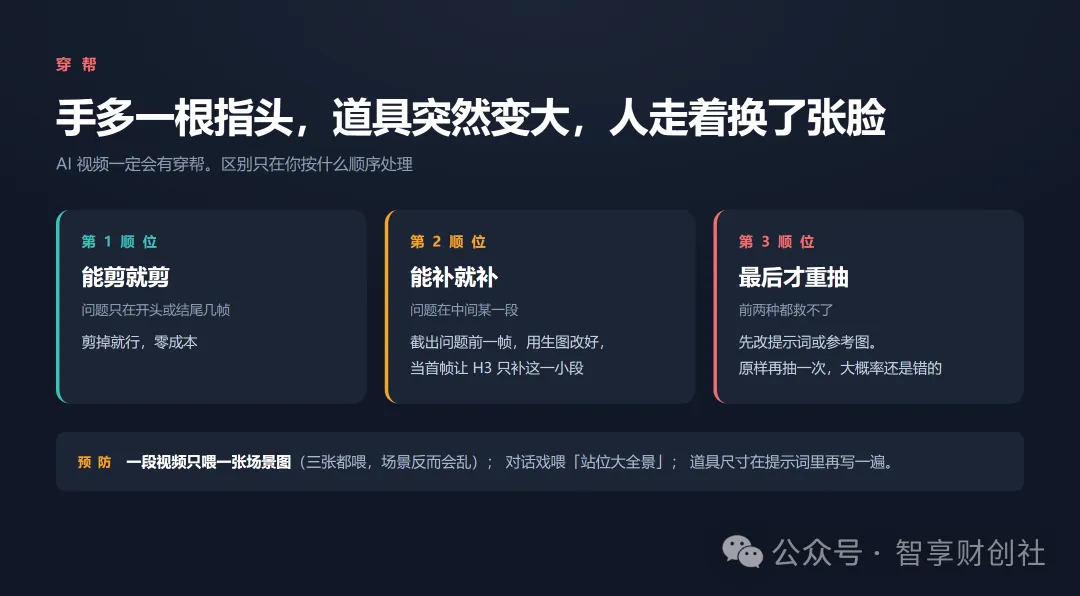
穿帮处理:能剪就剪,能补就补,最后才重抽
三条预防也记一下:一段视频只喂一张场景图(三张都喂,AI 反而不知道用哪张,场景会乱);对话戏把「站位大全景」喂进去,比写一大段文字还管用;道具尺寸在提示词里也写一遍。
五、后期:剪映四件事
素材都出来了,最后一步是用剪映把几十段片段剪成一集。常用功能免费版基本够用。后期就四件事:排顺序、补对白、理声音、加字幕。
粗剪:节奏比电影快
按剧本顺序把素材拖进时间线,每段从头到尾看一遍,头尾几帧有问题的直接剪掉(就是前面说的「能剪就剪」)。
节奏上三条:开头 3 秒放冲突,第一个画面就是最抓人的那句话;没有新信息的画面别停太久,对话之间的空白也剪紧;结尾停在悬念上,直接黑场,不要再往后拖。
补对白:声音不断,画面切到听的人
如果生成出来的一段从头到尾都对着说话的人怎么办?在剪辑里补:
把说话那段的声音单独分离出来,声音留在原位,一直不断 在上层轨道盖一段「听的人」的反应镜头,盖 1 到 2 秒 观众看到的是:前半句看着角色说,后半句切到别人的反应,声音一直是同一个人的
反应镜头从哪来?生成的时候顺手给每个主要角色多跑几段 3 到 5 秒的反应镜头,不说话只做表情。多跑 10 段也就多花 2 块钱,剪辑时却好用得多。
理声音:对白、音效、配乐分三层
音量排序很清楚:对白最大(观众必须听清)、音效其次(跟着画面走)、配乐最小(有人说话的时候在配乐上打关键帧压下去)。
常见两个问题:几段对白忽大忽小,用剪映的「响度统一」一次调平;同一个角色个别几段声音不一样,漏网的只把这几句重抽或重新配。
加字幕:自动识别,再逐句对剧本
AI 画出来的字经常是错字乱码,所以提示词里明确写了不要字幕,字幕统一在剪映里加。
用「识别字幕」自动转,再用「文稿匹配」把剧本台词粘进去自动对齐——这样错字更少。最后逐句对一遍:AI 念的台词偶尔会和剧本差一两个字,字幕要和声音一致,要么重抽这一段,要么把字幕改成它实际念的。
样式上放在画面下方三分之一,别挡脸;内心独白换个颜色或加括号,观众一眼知道是心里话。
导出前最后两件事
用手机全屏从头看一遍。对着穿帮清单检查:手指、道具、人有没有换脸、门有没有换方向。 标上「AI 生成」。2025 年 9 月 1 日起施行的《人工智能生成合成内容标识办法》第十条要求,发布 AI 生成内容要主动声明,并用平台提供的标识功能标出来。
可直接复制 · 剪辑单提示词你是短剧剪辑师。下面是这一集的剧本,和我生成好的素材清单(每段的编号、时长、内容、哪里有问题)。帮我出一份剪辑单。
要求:
1. 按剧情顺序排好素材,标出每段保留第几秒到第几秒、头尾各剪掉多少。
2. 有长台词一直对着说话人的地方,标出在第几秒盖哪一段反应镜头、盖多长,台词声音不断。
3. 列出还需要补生成的镜头:缺什么画面、多长、谁的反应。
4. 配乐分段:每段写情绪(紧张 / 轻松 / 反转)和开始、结束时间,有台词的地方标「配乐压低」。
5. 最后单独列出全部字幕,台词和剧本一字不差,每句标明是「说」「内心独白」还是「画外音」。
6. 开头 3 秒要有冲突,结尾停在悬念上;如果现在的顺序做不到,告诉我怎么调。
六、进阶:让画面从「能看」到「好看」
流程跑通以后,下一个问题一定是:怎么让画面更有电影感?三条最管用的:
1. 光要写具体,别只写「电影感」。AI 看不懂「高级感」,它看得懂四件事:光从哪边来、硬还是软、冷还是暖、亮还是暗。最简单的一招:把顺光改成侧光,脸一下子就立体了。
2. 一场戏锁一套光。同一场戏,每一段都写同样的光,方向、冷暖、时间段都不变。上一段写「午后暖光」,下一段别变成「冷白光」,不然剪在一起像两部片子。
3. 一个镜头写全六样。运镜、景别、角度、主体、运动、光影。少写一样,AI 就自己猜,猜错了就是一次抽卡的钱。
可直接复制 · 镜头提示词模板模板:(运镜),(景别),(角度),(主体:谁、什么神情),(运动:动多少);(光影:方向、软硬、冷暖、明暗);(焦段),电影质感,真实皮肤纹理,暗部有层次,面部清晰不变形。
七、9 个坑,踩一个后面全白干
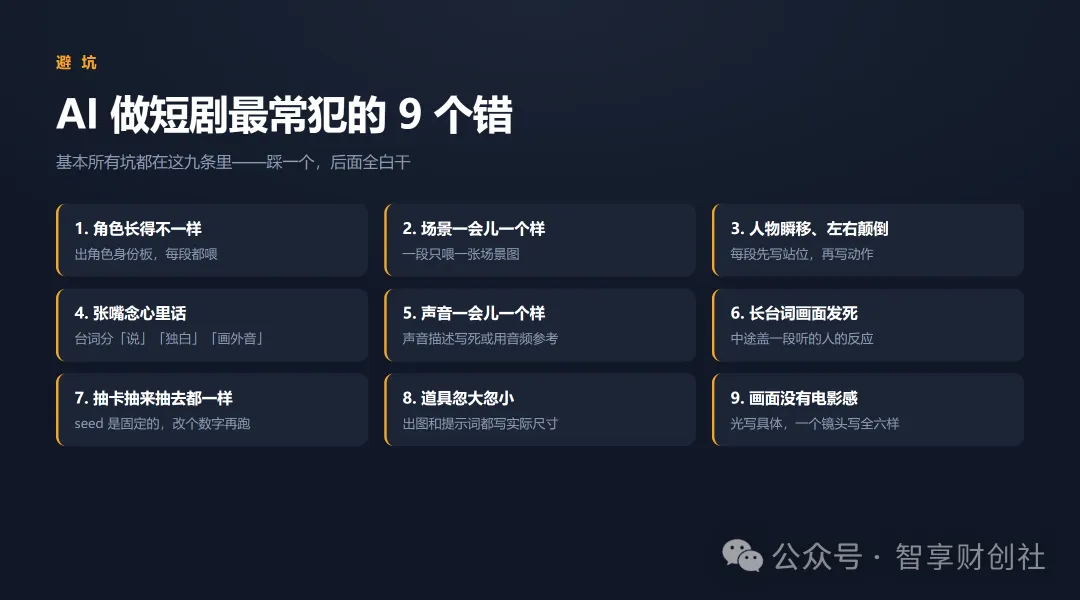
AI 做短剧最常犯的 9 个错
按「难发现」排序,我觉得最容易被忽略的是第 4 个和第 7 个:
「角色张着嘴念心里话」——这个坑隐蔽,因为它不会报错。片子看起来完全正常,只是观众莫名觉得哪里不对劲,但说不出来。根因是剧本里「说」「内心独白」「画外音」没分开标。
「抽卡抽来抽去都差不多」——这个坑费钱。工作流里 seed 是固定的,默认状态连着抽十次都是同一个结果,你还以为是自己提示词写得不好。
写在最后:这方法什么情况下不成立
这套流程我认为是目前个人做 AI 短剧最现实的路径,但有三条前提得说清楚:
① 它适合「短、单场景、对话驱动」的内容。动作戏、多人群像、快速转场的产品展示,AI 视频模型目前的水平撑不住,硬做就是拿钱买抽卡体验。
② 它出的是「能看完」,不是「能爆」。27 块钱的成本意味着你可以试错、可以一次做 10 集,这是它的真正价值。但成片能不能有流量,取决于故事和投放,跟成本没关系。
③ 前期的时间省不掉。有人以为「AI 了就不用写剧本了」——恰恰相反,前期花的每一分钟都在替你省后面几十次抽卡。这个账是反的,但它是实的。
如果只让我给一条建议:先花一小时做完那 10 秒。跑通一遍,你会知道自己卡在哪,而不是继续读教程想象自己卡在哪。

