不思悔改 我又充了7000做AI短剧
- 2026-11-18 03:11:30
上次,我劝程序员别碰AI短剧,并总结了一下:自己花了1000块,一条满意的两分多钟短片都没做好。
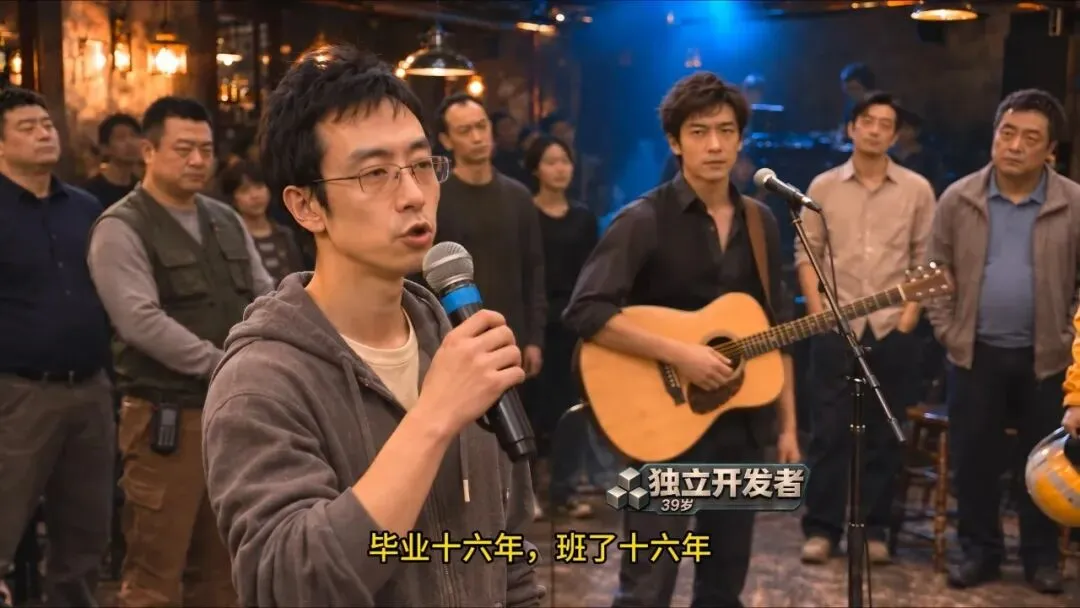
但架不住实在忍不住想折腾,这次我又充了7000,做了一条算是符合预期的MV吧。
上次的折腾写在这篇里:《建议程序员不要碰AI短剧》。
上次做的《请叫我的名字》,也放在这里。
这次把我勾回来的,是那条火出圈的《过来人》MV。人到中年,突然失业,生活过得艰难,有些话平时说不出口,看完之后,我也想表达一下自己的状态。
歌里那个程序员,学会了AI,却丢了饭碗。独立开发没下载,跨境电商压库存,量化炒股买啥跌啥,自媒体阅读个位数,折腾一圈,最后解锁铁人三项——网约车、外卖、快递。也许就是我自己。
于是,就有了这首《睡醒就要接单了》。
01◆
一天上一个当,当当不一样
这次,是LibTV给我设的陷阱。
《过来人》把制作过程和稿件都公开了,我就去LibTV上学习。打开那份画布,人物、场景、音频切片和视频节点都摆在那里,沿着连线就能看出一段视频用了哪些参考、接了哪一段歌,比只看成片容易入手多了。
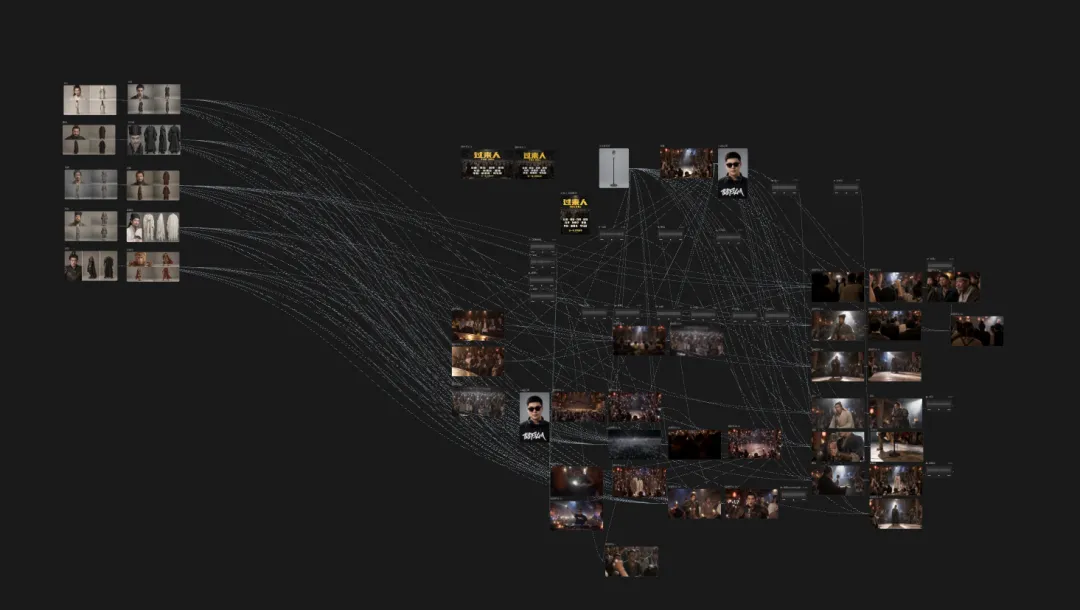
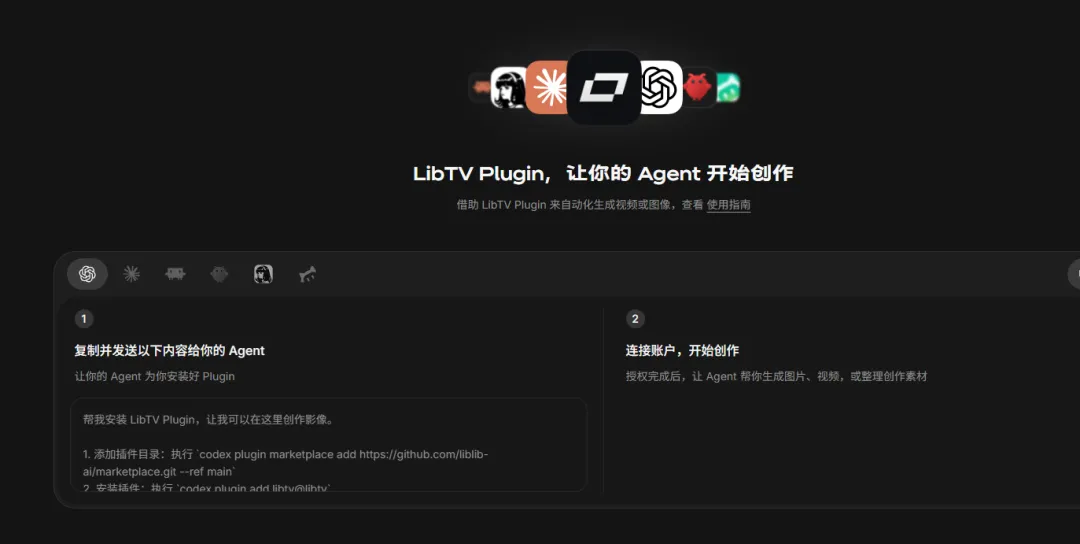
本来是去学怎么做,结果先被它支持MCP这件事勾住了。它可以接到Codex这类AI工具里,让我在对话中准备素材、上传文件、连接节点,少在几个网页之间来回复制粘贴;对一个程序员来说,这比单纯说“我们能生成视频”有吸引力多了。
接着,双十一活动页又来了:限时折扣、送会员、送积分,还有一个7天限时0积分的活动。看下来就一个感觉,现在不充,好像亏的是我,于是又把钱充进去了。
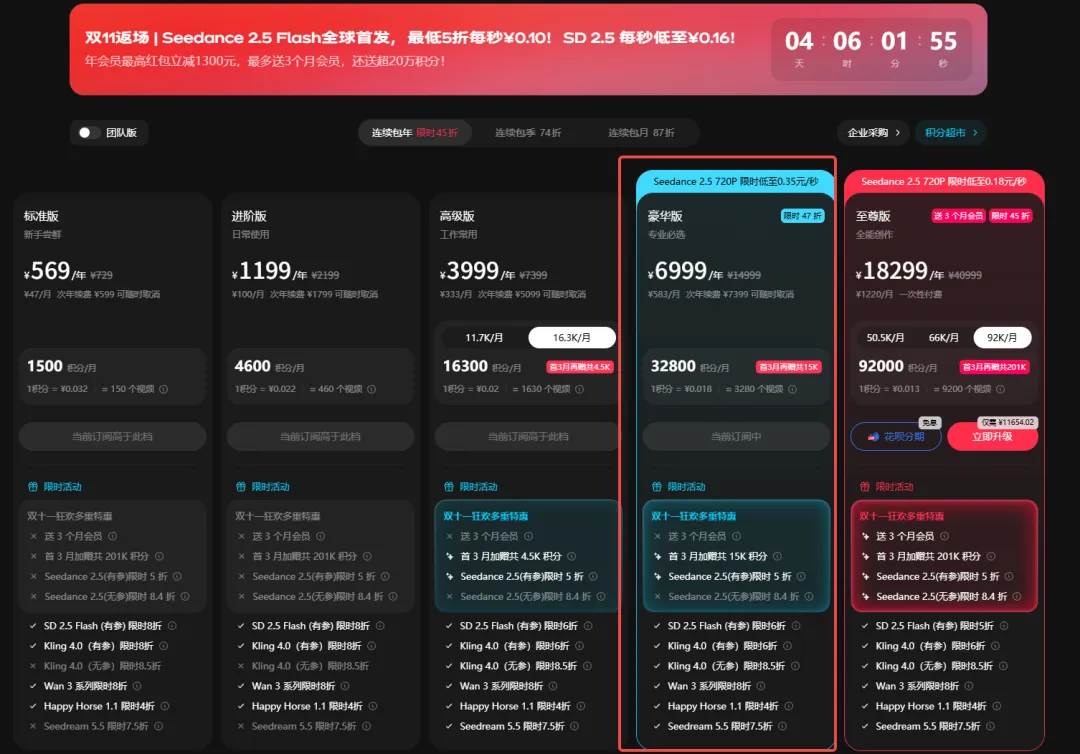
我当时想,有了这7天,总能放开手脚试一试,不用每点一次生成都先心疼一下积分。真正充完才发现,页面上很抢眼的Seedance 2.5,在模型栏里标的是“限时5折”,“0积分畅用”写在另外几款模型旁边。
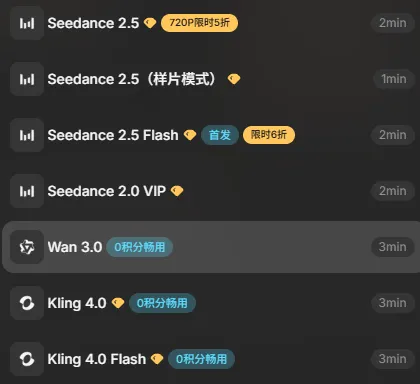
我这次用下来,这些限免模型还算不上自己心里的第一梯队,选的那套0积分配置,一条还只能做15秒以内。更难受的是排队:生成要等,发现口型不对,改完还得重新排;活动只限7天,我还得花时间看它排队。
都是套路,我还真就又充了。钱已经花了,那就继续往下做吧。
02◆
歌词先磨成能唱的,别写成工作周报
这次我想做一首自己的歌,先和GPT磨歌词。失业、独立开发、跨境电商、量化、自媒体,再到跑单,素材给得挺齐,AI也确实全写进去了,问题是唱起来像一份失业后的工作周报:句子长,押韵硬,每段都忙着交代“后来我又做了什么”。
我想要的是中年男人累了一天,坐在车里想说两句,又不知道能跟谁说;上有老、下有小,房贷车贷还得还,明早起来还得干活。起床是因为要出去接单,不是因为睡得浅,也不用安排夫妻坐在一起商量人生。
光这个感觉就来回改了很久。毕业十六年、上了十六年班,一句话带过就够了,后面得留下每次折腾的感受:独立开发看着后台没下载,跨境电商看着货卖不动,量化交易看着回测好看、实盘亏钱,自媒体则是想被人看见,又怕被人看穿。
我还删过“纸箱先涨潮”这样的句子。写着似乎有点文采,但放在这个男人嘴里,就是不像他会自己哼出来的话,最后还是这些更直接的细节留了下来:
功能改了又改,下载还是三后台静悄悄,扣费倒准点
整首歌用“接单”串起来,四段主歌分别唱四次尝试,三个副歌分别唱网约车、外卖和快递,让过去折腾过的路与眼下还得跑的单交错着出现。副歌共用“睡醒就要接单了”和“再接一单,再跑一趟”,中间换成各自的生活,听的人才容易跟着唱。
白天开车,一直在路上一条差评,心里堵得慌有些委屈,算了不去讲怕手机响,又怕它不响
到这里,词才慢慢从“把事情讲全”变成“让人听见那口气”。人物并没有翻盘,歌里也不用替他打鸡血。
03◆
Suno也是抽卡,我只能一遍遍听
歌词写完,只是有了拿去试唱的材料。我完全不懂音乐,没有一套专业的判断标准,编曲、和声该怎么评价也说不上来,只能让AI先给曲风建议,自己一遍遍听,觉得好听、能听下去,就留下来。
Suno也不是输一份词就能稳定出同一首歌。同样的歌词和风格要求,换一轮生成,旋律、唱法和整首歌的感觉都可能变,听着合适的版本得挑,想改一个地方,也得重新听其他地方有没有跟着变;做音乐这一步,同样是在抽卡,而且Suno这边也另外充了会员。
第一轮偏民谣、布鲁斯,声音疲惫,情绪是有了,可才到主歌一就已经五十多秒,甚至一分钟,后面还有那么多段没唱呢。后来换成中文旋律说唱加R&B,让主歌跟着节拍往前走,副歌留出能记住的旋律,整首歌的长度才更接近我想要的样子。
我先拿一小段主歌试,再把副歌加进去听,选到喜欢的副歌,才往完整版本扩。那次短试听里,第二条的副歌让我觉得可以,后面就沿着这个方向做完整曲;我判断它的办法仍然很朴素,就是多听几遍,看自己还愿不愿意再听。
多音字又单独折腾了一轮。“走路得绕弯”的“得”要读děi,“车贷还”“还不上”的“还”要读huán,“欠的觉没还”的“觉”又是jiào,字写对了,唱出来也可能读错。我只能把错的地方圈出来,在演唱输入里局部加拼音,再重新听,正常歌词仍保留汉字。
我本来还想把Suno也接进这套流程,账号授权却没连上,最后还是在网页里做歌、试听和下载。等开场、主歌、副歌、尾声和这些读音都听过,才把约3分15秒的音频定下来,后面的画面跟着这条定稿音乐走。
04◆
人物和图片,我们放在Codex里先做完
人物也没沿用《过来人》的角色。我先把四段主歌、三个副歌分给七位不同的人,再加一个开场驻唱,让他们各自唱到自己那一段;年龄、脸型、发际线、身形和衣装先固定下来,不然镜头一换,同一个人就可能长成另一个人。
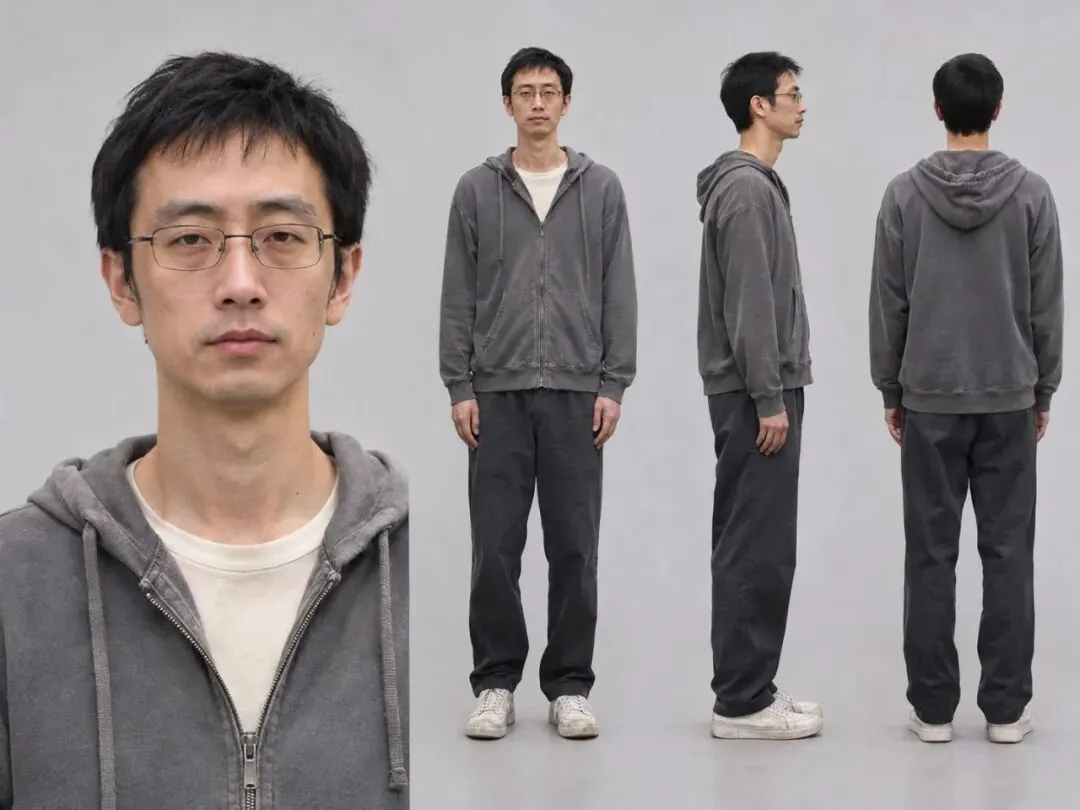
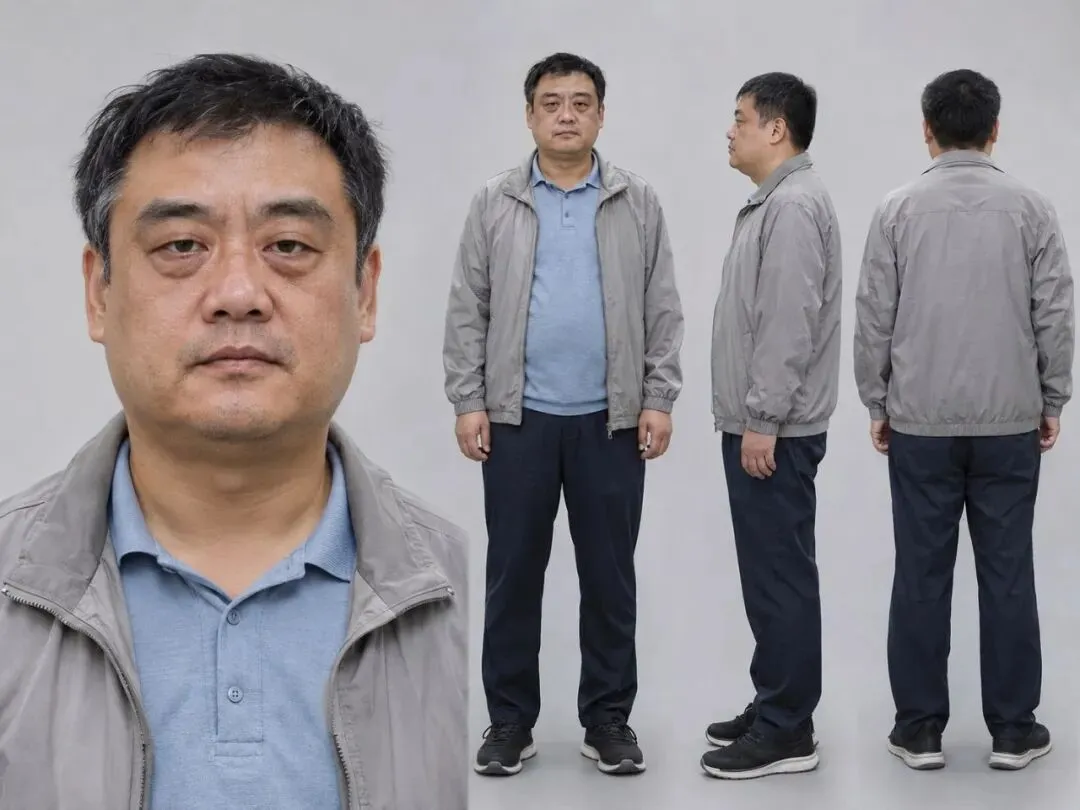
其他人也是这样,跨境卖家穿藏蓝衬衫,量化交易者穿开衫,自媒体创作者上半身收拾好、下面还是家居裤和拖鞋,骑手和快递员保留工作着装,驻唱则穿开领衬衫、马甲,背一把原声吉他,最后合成一张总参考板。
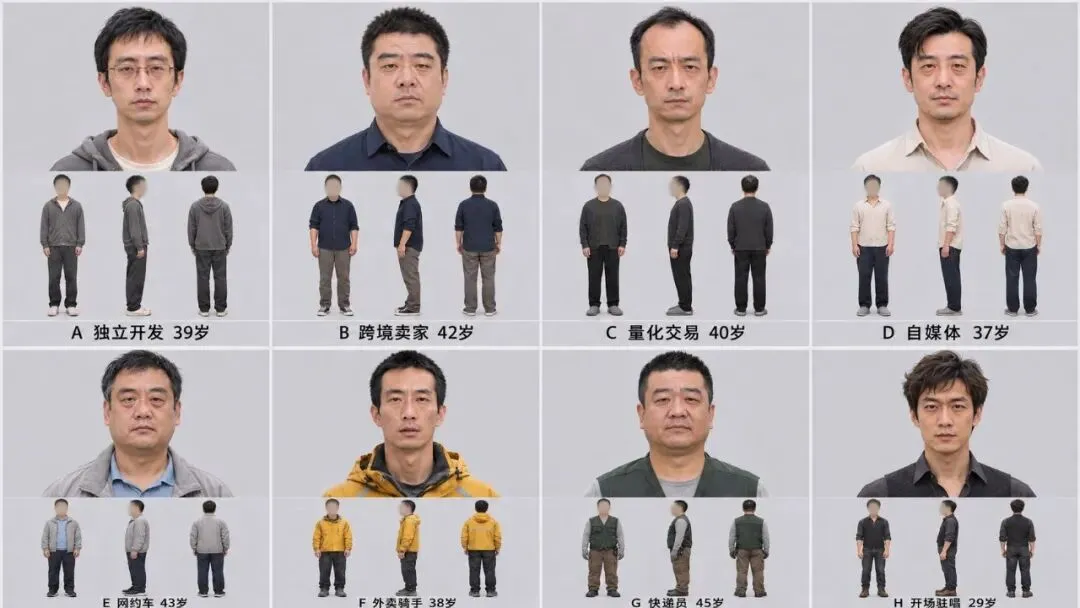
总板里,清晰大头像负责身份,小三视图负责衣服和体态,小图里的脸特意弱化,免得几种清晰度的人脸混在一起,让模型读错参考。定妆照也不只是挑一张好看的脸,后面几十个镜头,还得继续认得出这个人。
参考作品的画布里就有直接调用Lib Image生图的节点,人物、场景和视频都能在LibTV里接着做。我这次把图片制作这一段放到了Codex里,调用内置生图工具,把角色定妆、舞台、道具、关键帧都做成实际文件,再上传LibTV,连上相应音频和视频节点。
歌词、图片、音乐切片和提示词可以在Codex这边整理,Suno负责音乐,LibTV负责视频,最后还要回剪映剪辑,这条链才算真的接起来。
05◆
先把整段唱完,再考虑15秒怎么拆
画面最初也想过跟着歌词拍生活,写代码、囤货、盯盘、开车、爬楼,后来我更想要一个小现场:大家下了班,或者刚好路过,围在一块听歌,驻唱先开口,下面的人听进去了,再有人走到前面接一段。
这个场子得有灯光,但不能像大家买票坐好、等着看专业歌手表演。观众里要有骑手、快递员、普通上班族,站得不整齐也没关系,表情还得有区别,有人憋着,有人苦笑,有人只是看着前面;中间生成的图一度太整齐,大家还总闭着眼,那种感觉就得继续改。
我把舞台改成了人群围合的小空间,驻唱前面留一支固定立麦,再准备一支手麦给其他人用。木吉他、头盔、软包、手套和扫码设备也先放进道具参考,尽量让后面的镜头有东西可对照。
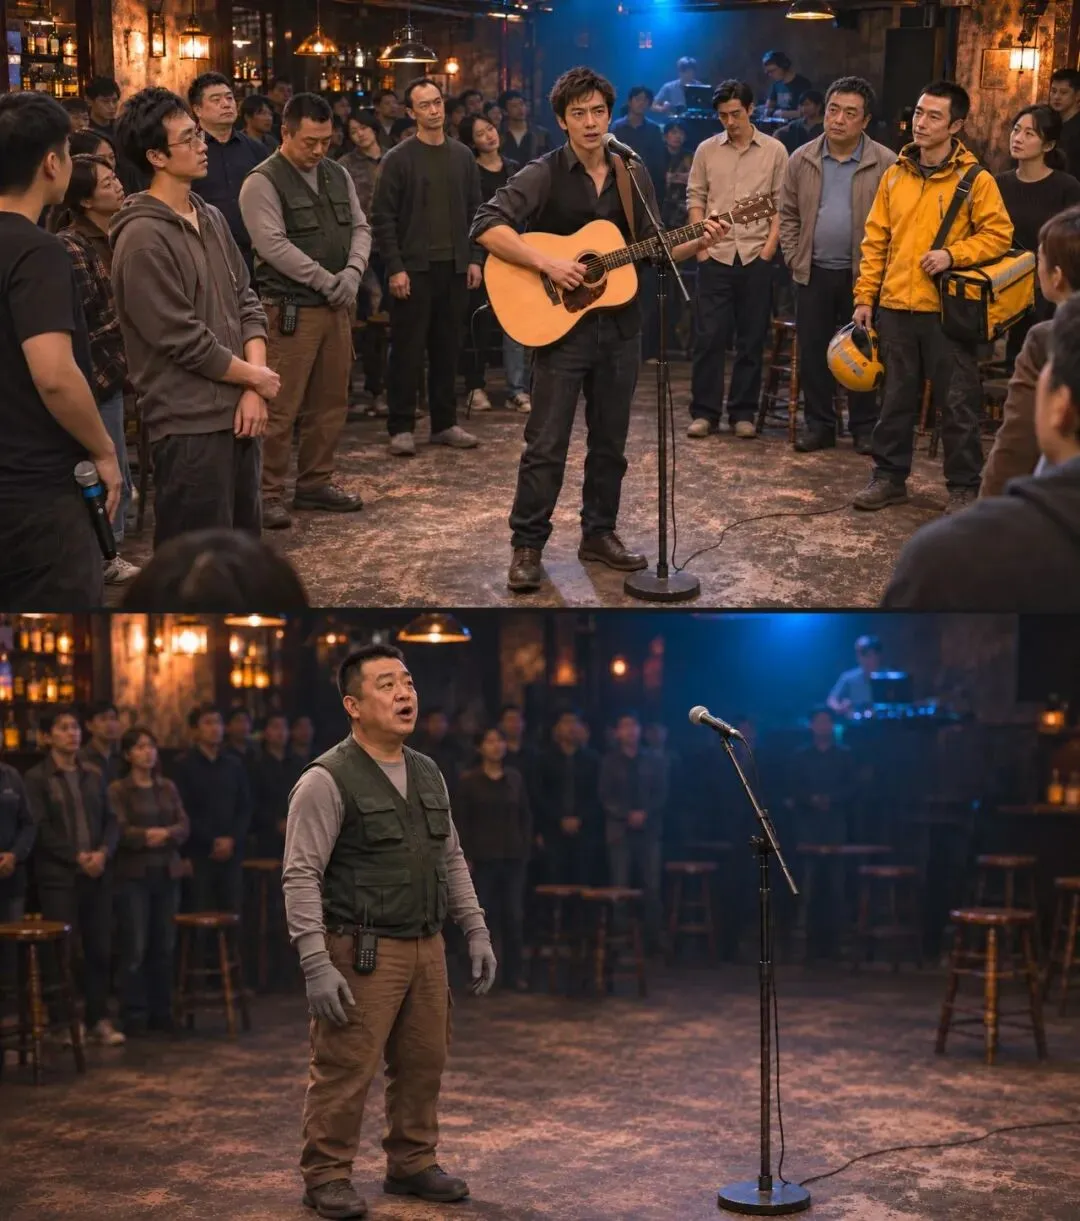
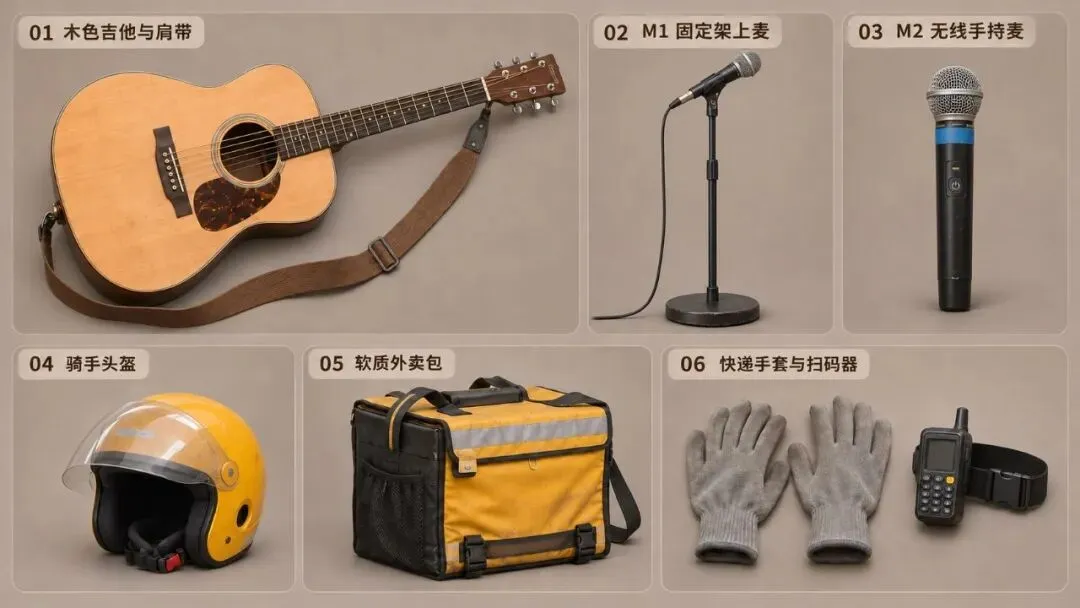
当时用的Wan 3.0、720p的0积分配置,单条最长15秒,我最初便顺手把音乐先切成短段,再给每段设计画面。结果开场只唱了一小部分,下一个人就上来交接话筒了,这一小包的任务做完了,整段歌却还没唱完。
后来才改成先按开场、主歌、副歌设计完整段落,想清楚谁在唱、镜头看谁、什么时候扫观众、唱完怎么换人,再拆成不超过15秒的执行片段。上一条结束时话筒在哪里,下一条就从那里开始,人物也不能唱着唱着自己跑到台下。
下面把各段关键帧合在一起看:开场先交代驻唱和人群,四段主歌与三个副歌轮流接唱,尾声再回到司机。这些是生成前确定的表情、机位和交接状态,段落之间要接得上,段内再拆成适合模型执行的短片段。
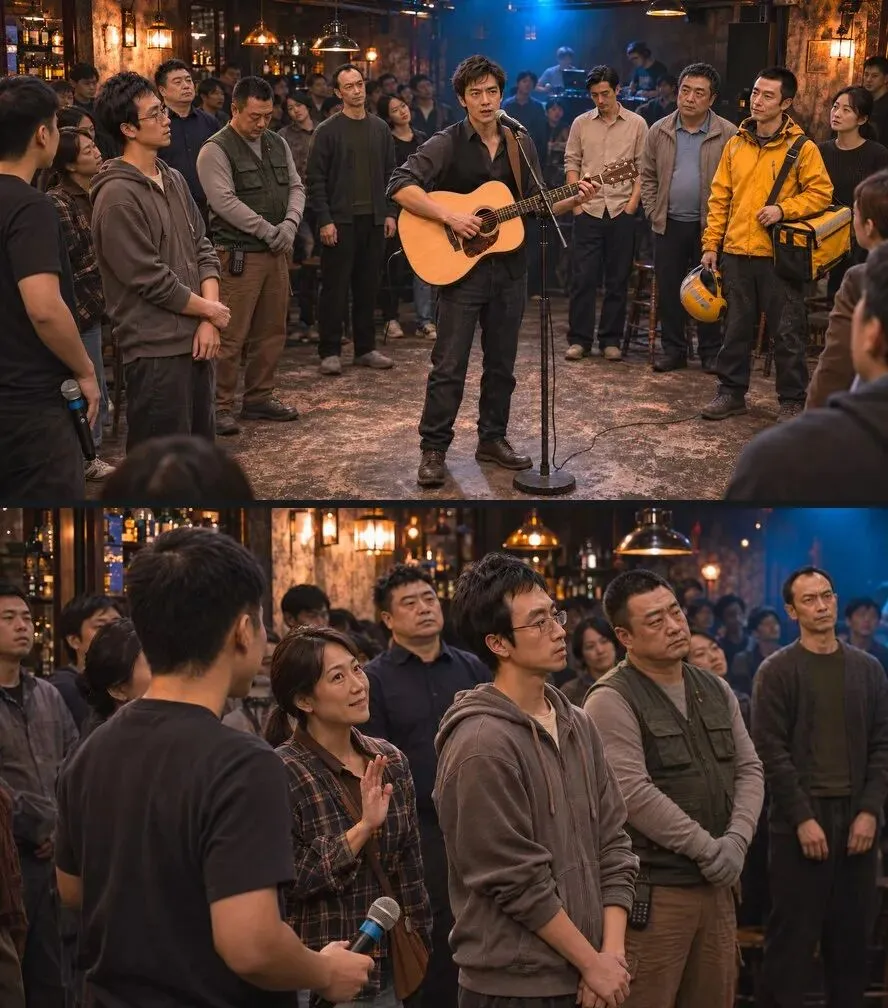
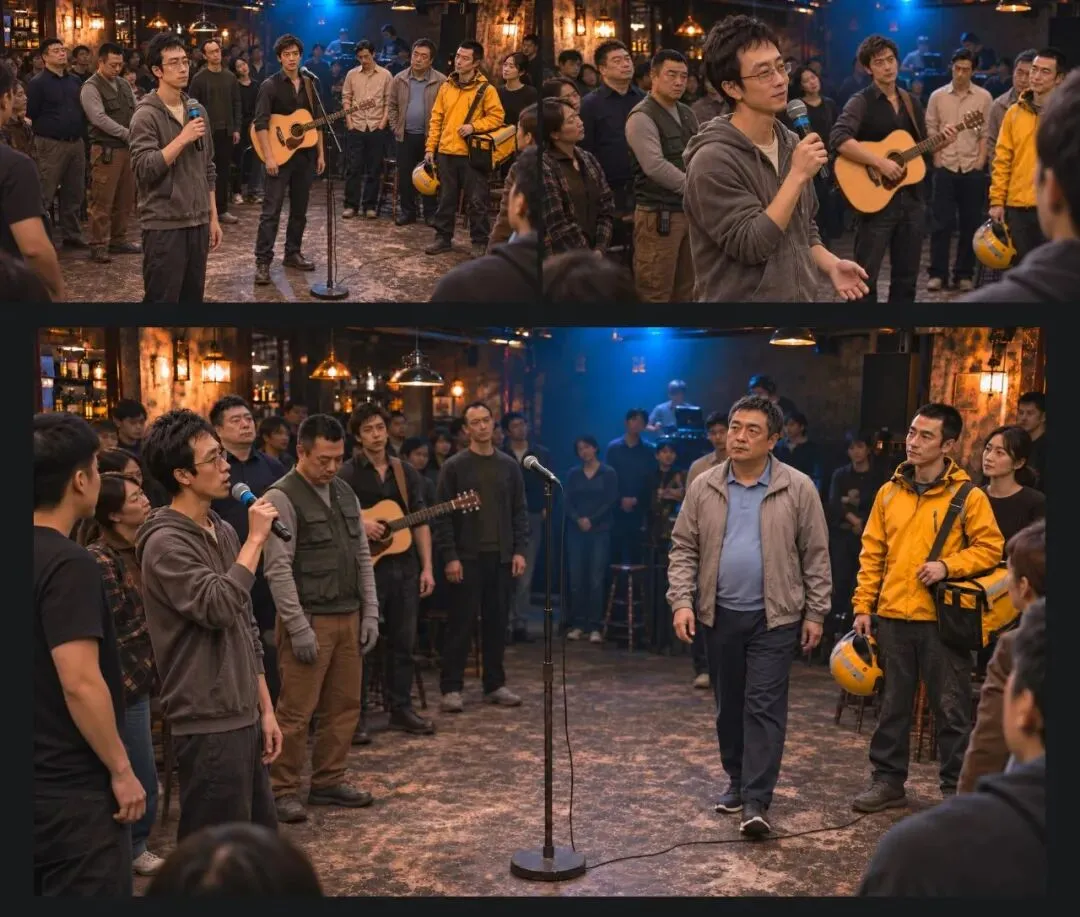
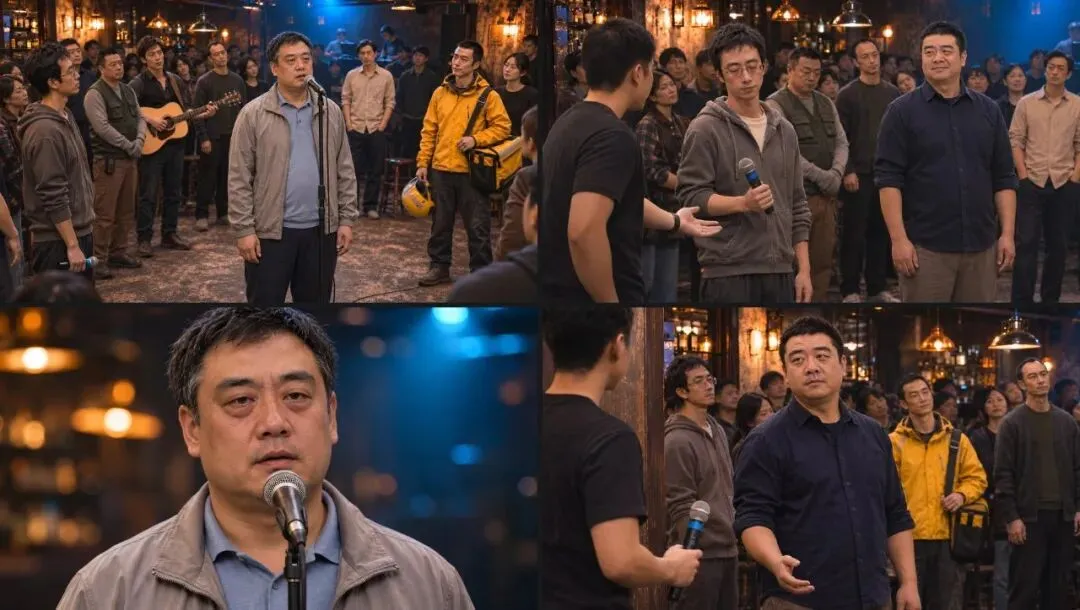
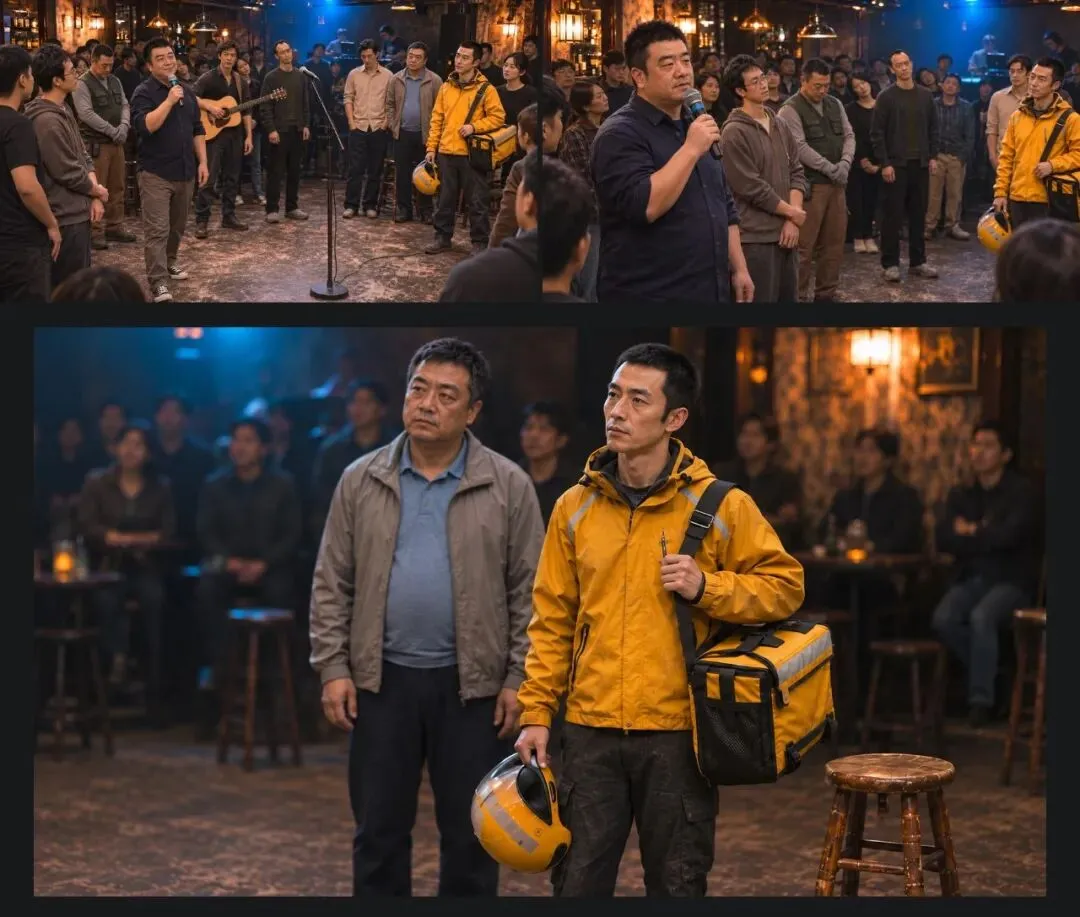
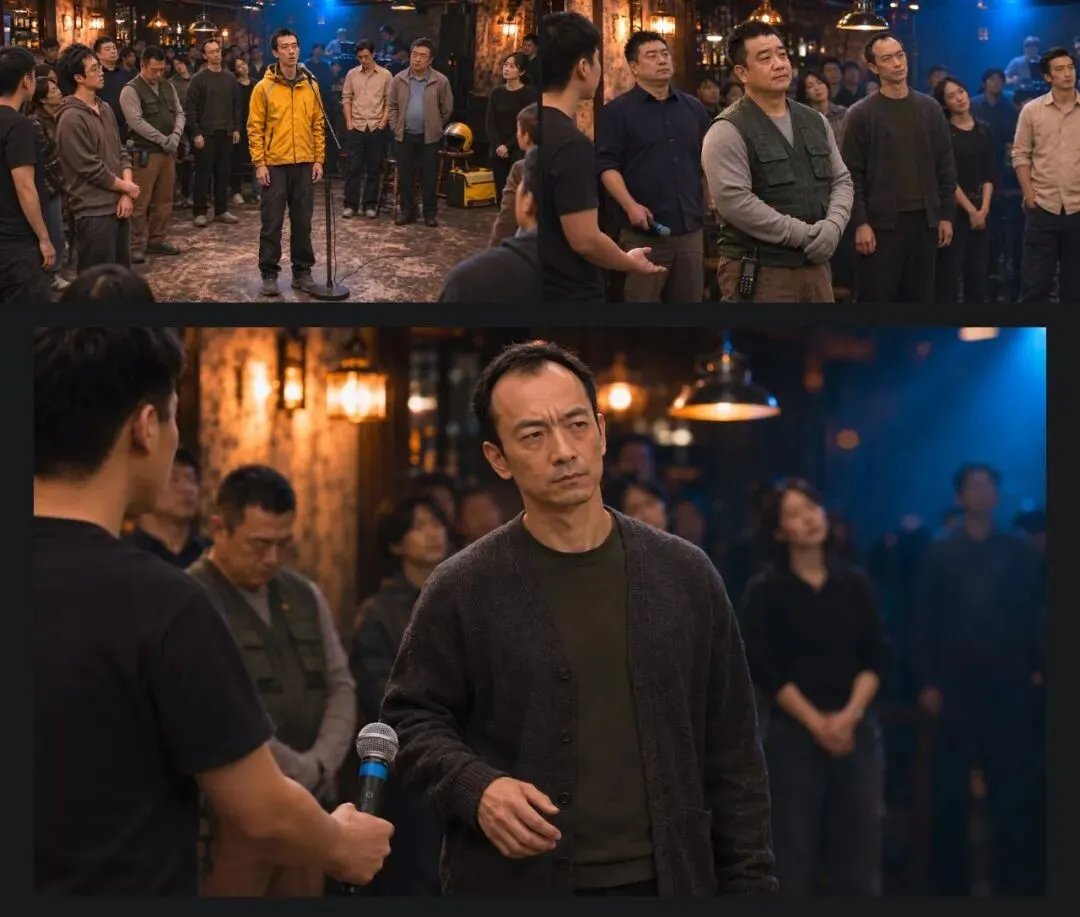
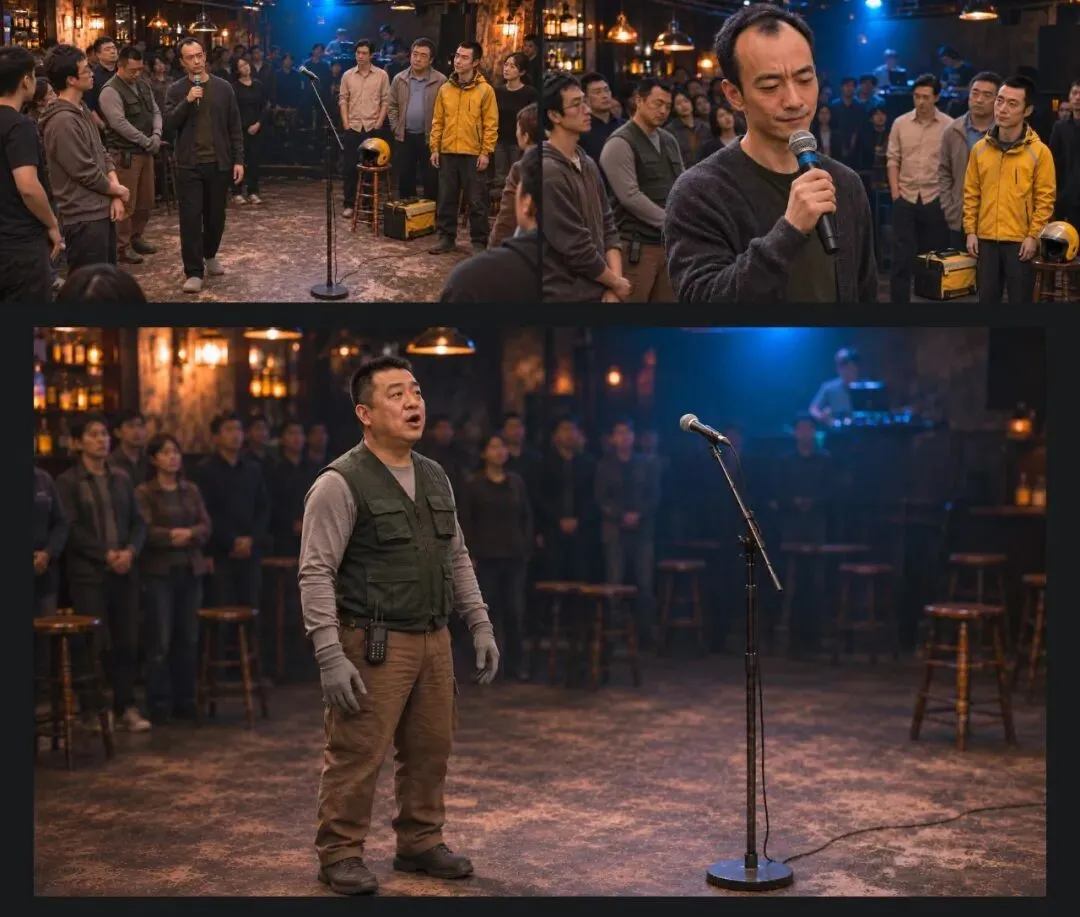
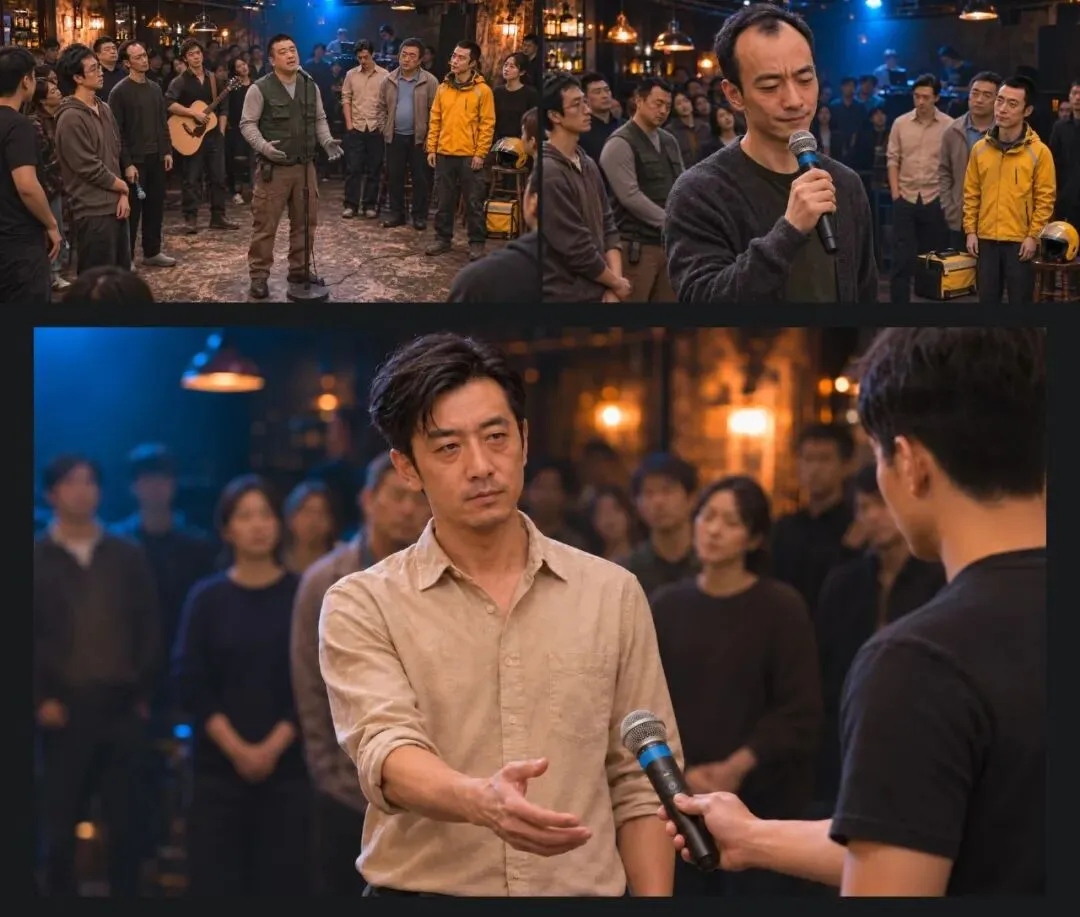
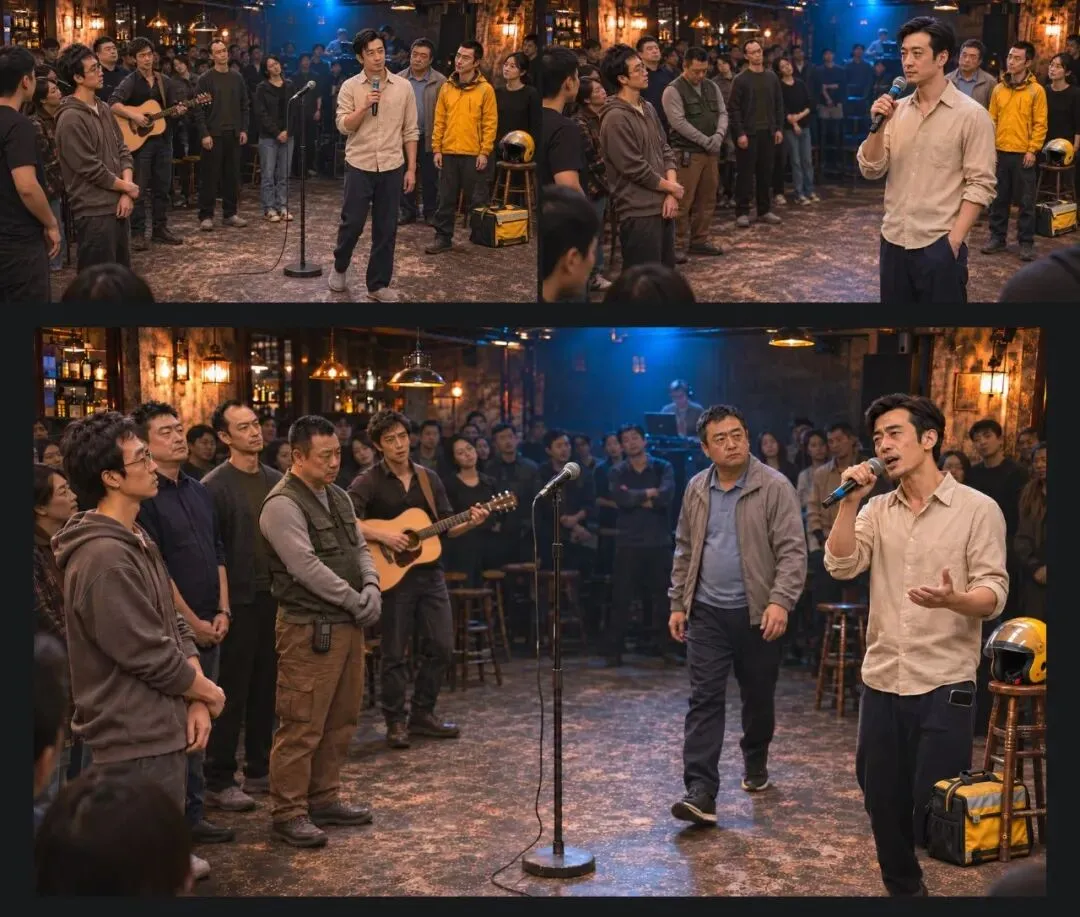
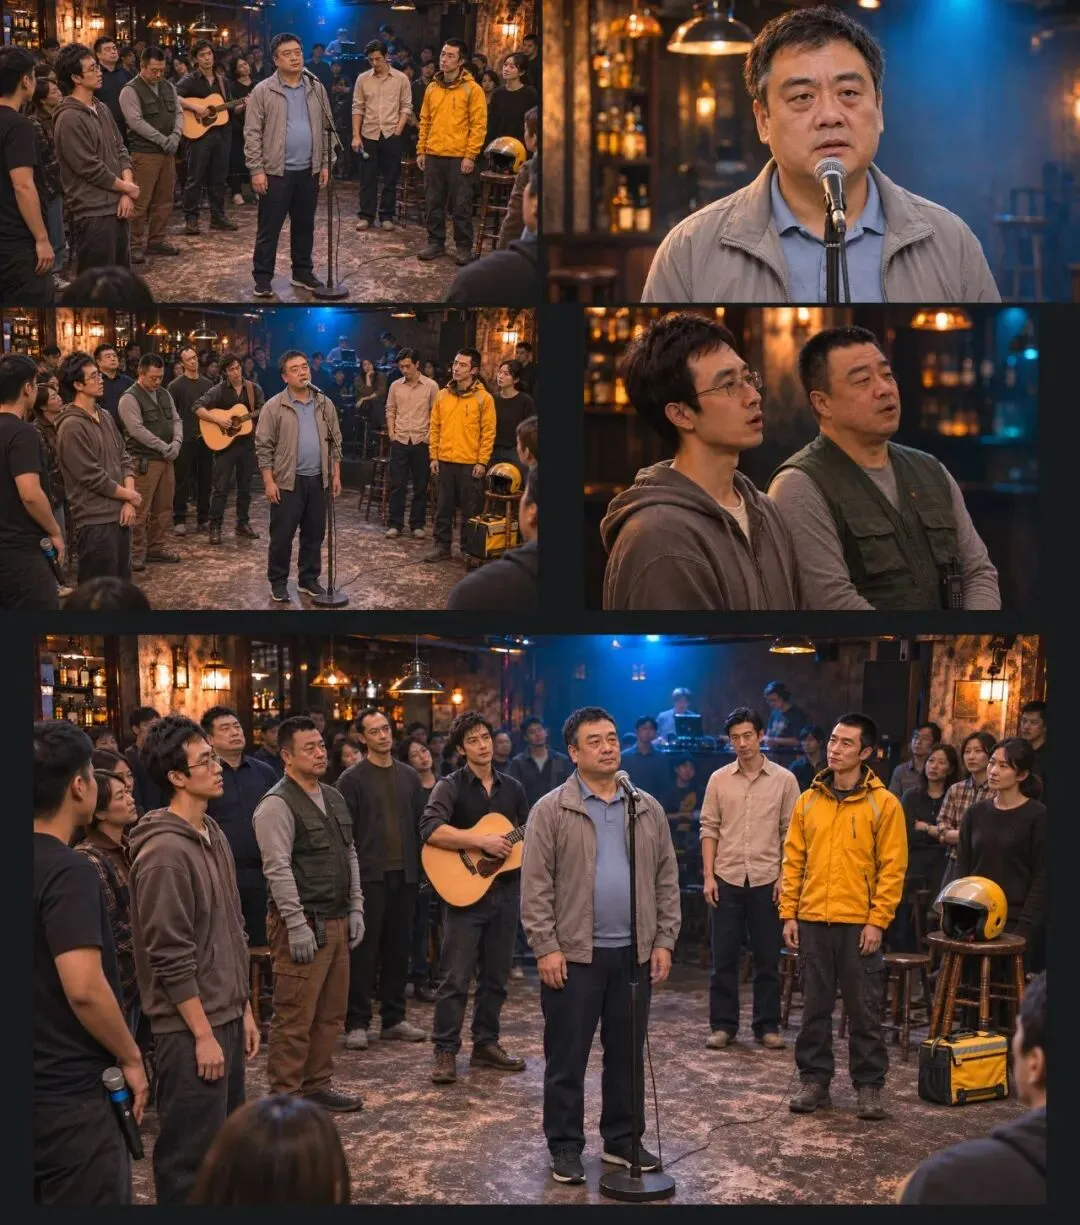
提示词也不能只写“一个中年男人在唱歌”,谁在唱、谁只是听、麦克风在哪、镜头怎么走,以及声音怎么交付,都得说清楚。以开场为例,下面节选的是其中一部分要求,实际节点还附有对应音频切片的完整歌词:
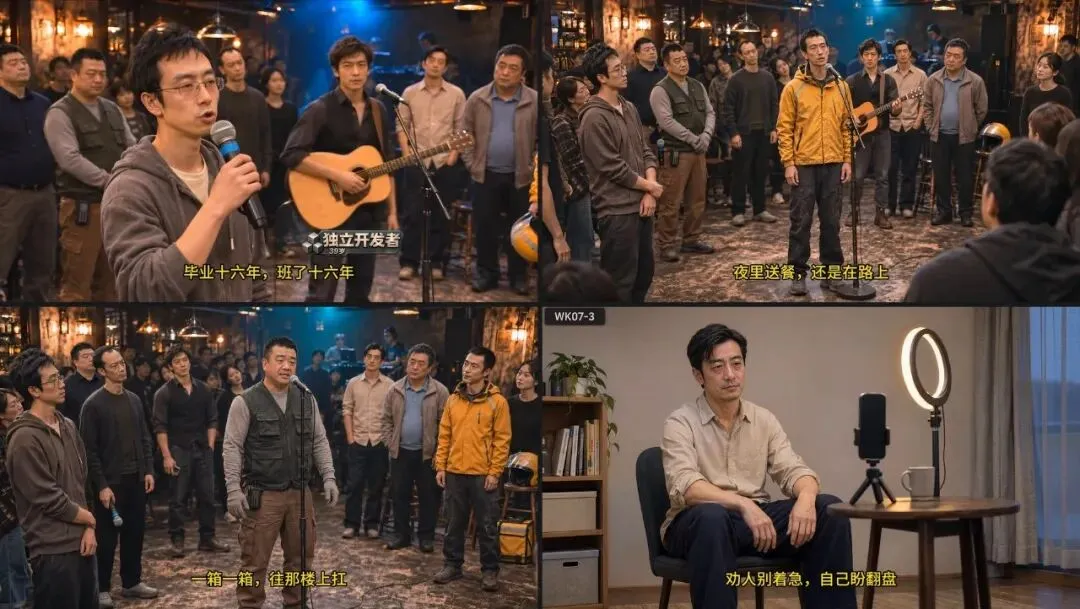
【歌词节选】 睡醒就要接单了 闹钟响了,七点半 昨晚的倦怠还没散 人还没起,月供先扣完 【表演与镜头节选】 H是这一段唯一领唱者,面向架上的固定麦M1唱, 双手留在吉他上。工作人员持另一支手麦M2, 在人群中邀请下一位;A接下手麦,完整开场结束前不抢唱。 先给眼平全景,再缓慢推近;切到人群时,H的原录音持续。 M1留在架上,工作人员松开M2后手里必须空着。 【声音与交付节选】 模型声音保持开启,输出与引用音频同步的有声MP4。 保留原曲人声、旋律和伴奏,不重唱,不新增对白或音效。 模型音轨若缺失或偏离,按同一源时间窗合入原WAV。 最终剪辑连续铺完整母带,不顺拼有重叠的切片音轨。 这些参考最终变成了片子里的画面,下面几张直接截自剪辑完成的MV:
06◆
图都挺像样,一动起来就不是那么回事了
真正看视频时,问题比定妆照丰富多了:有人唱着唱着,镜头长时间去拍下一位;一个快递员还没退场,后面又走来一个长得一样的快递员;话筒明明已经递出去了,递麦的人手里却还留着一支。
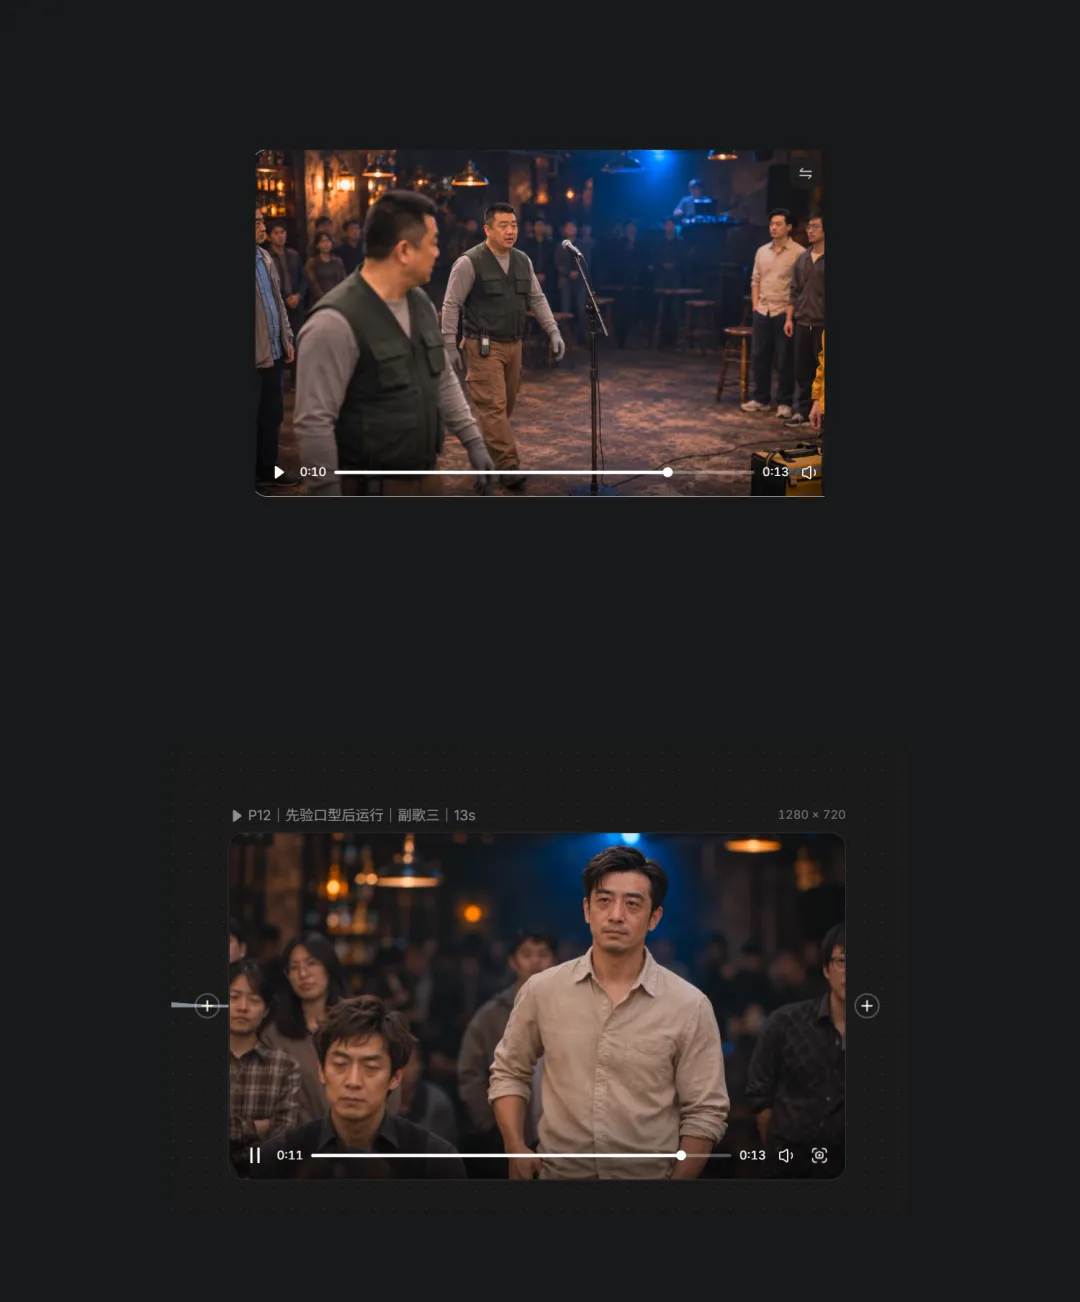
场内只安排了一支固定立麦和一支手麦,做着做着,AI倒替我把设备预算扩了。后来提示词得把动作写得很具体:开头谁拿手麦,工作人员从谁那里收回,递给谁,接过去以后,递麦的那只手就得空着,不能直接从一个人手里“变”到另一个人手里。
我还给快递员设计过摘手套的特写,想加点生活感,结果片段本来就短,手套摘了半天,演唱表情没剩多少,后面的镜头还会让手套自己长回来,最后索性取消了这个动作。细节如果接不住,越强调它,后面要补的地方反而越多。
口型也得单独试。我做测试时,只给音频,让模型自己理解在唱什么,准确度不够,后来每个视频节点都补上本段实际唱的完整歌词,再写清哪一句看正脸、哪里可以切到手或观众,不能让它自己猜字,也不能长时间拍一个没在唱的人。
声音同样要管住,前面有一条生成结果重新处理了音频,听起来已经和原曲不一致,后面就用定稿WAV切片作节奏和口型依据,终剪再回到原来的主音轨。歌分成很多段去生成画面,最后听到的仍得是已经选定的那首歌。
最吸引我充值的MCP也给我补了一课:我以为网页显示0积分,走MCP也会一样,真用了才知道通道不同,计费也不一样。这次是我自己搞错了,后来只让工具准备素材、参数和节点,生成留在网页上由我逐条确认、点击;资源紧张时最多只能排10个,还得隔一阵回来补,程序员拍片,等待队列还是没放过我。
07◆
唱歌之外,还得有能剪进去的生活
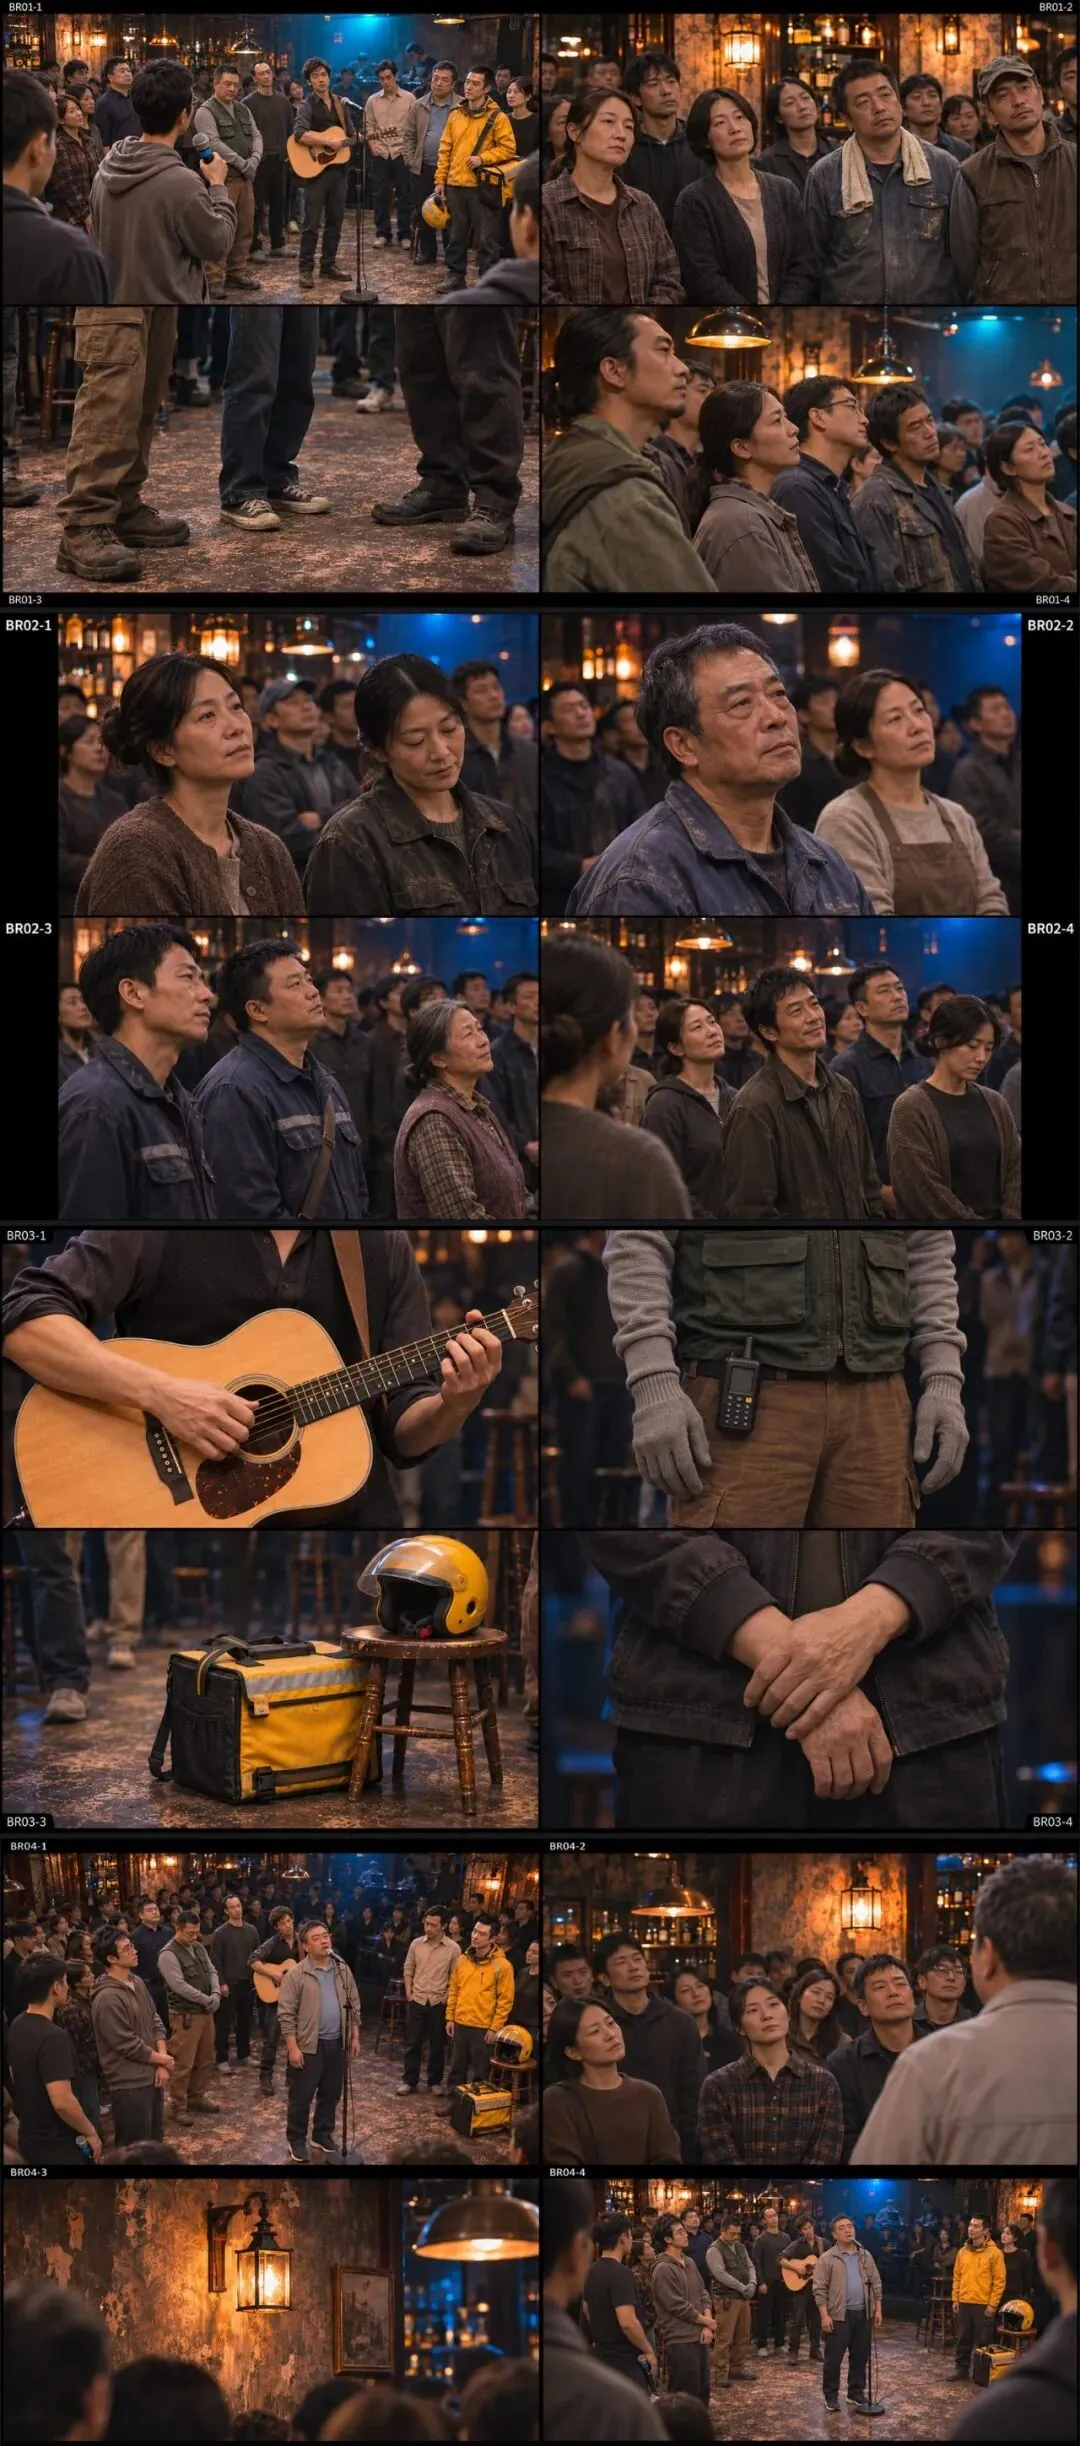
主唱镜头有了,还得给剪辑留余地。我另外准备了四组群众和环境备用镜头,每组拆成几个三四秒的小镜头:有人在人群里听,有人跟唱,也有吉他上的手、工作后疲惫的手和小场地的全景,用来让画面喘口气。
随后又给七位主角各准备了一段工作时的插镜,继续沿用原来的脸和衣服,让台上唱的那些事,在台下也有几个具体画面。它们先做成关键帧和提示词,后面再从生成结果里挑能剪的部分。
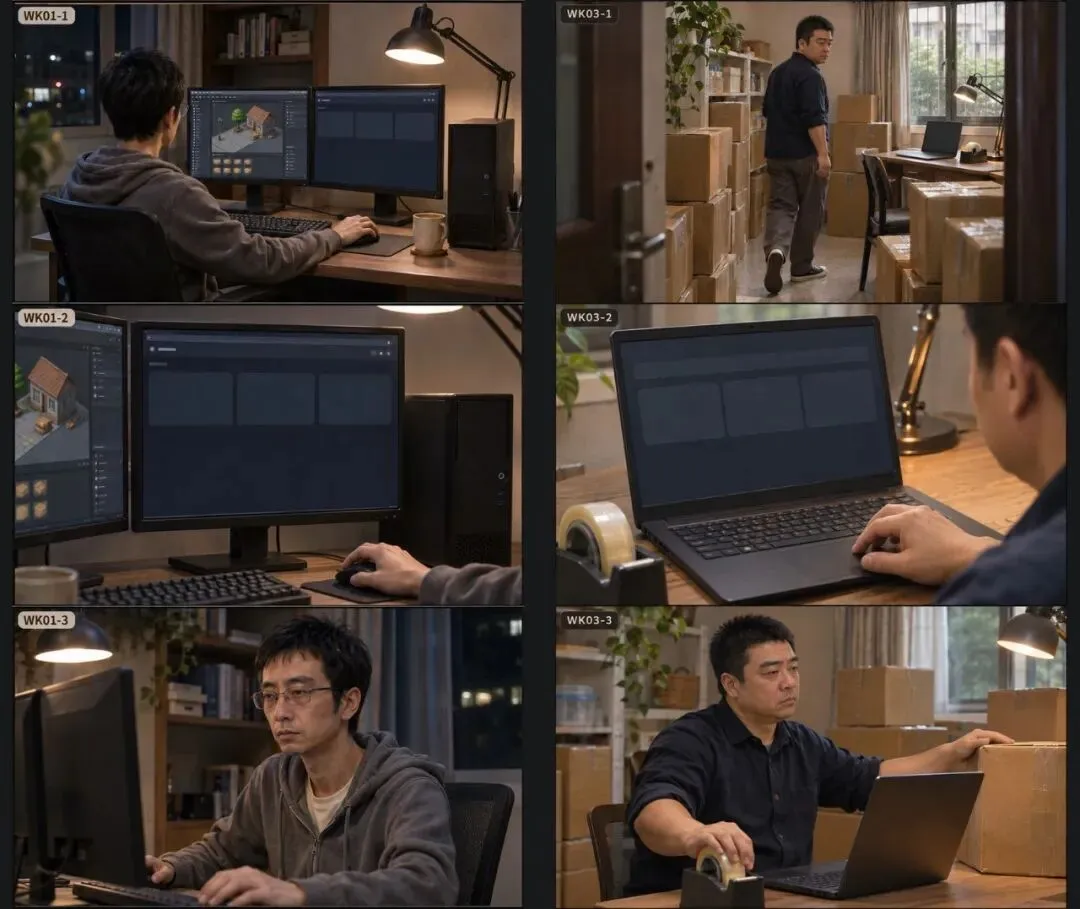
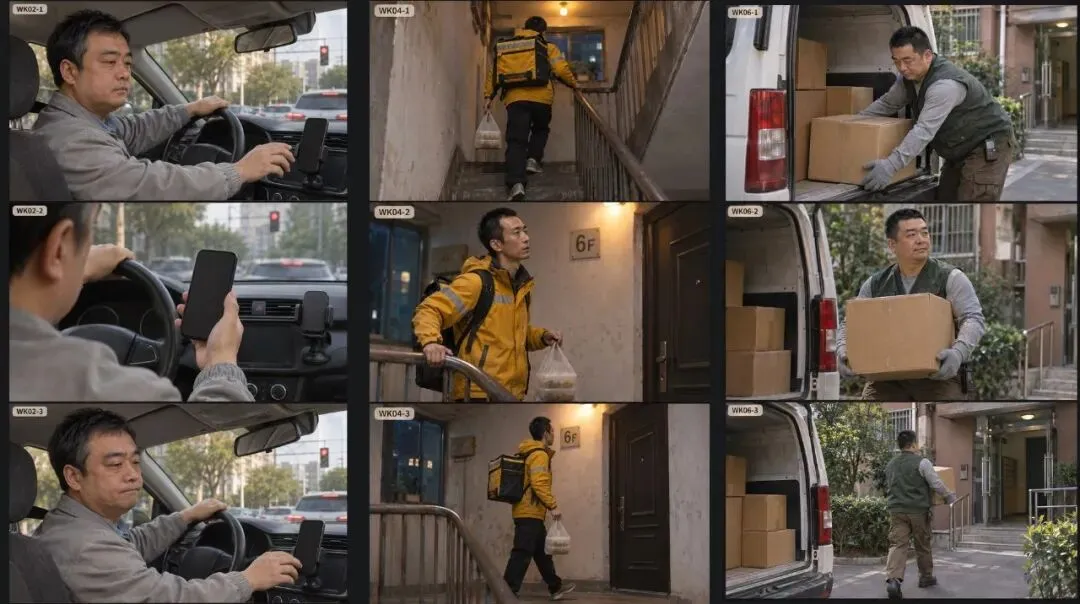
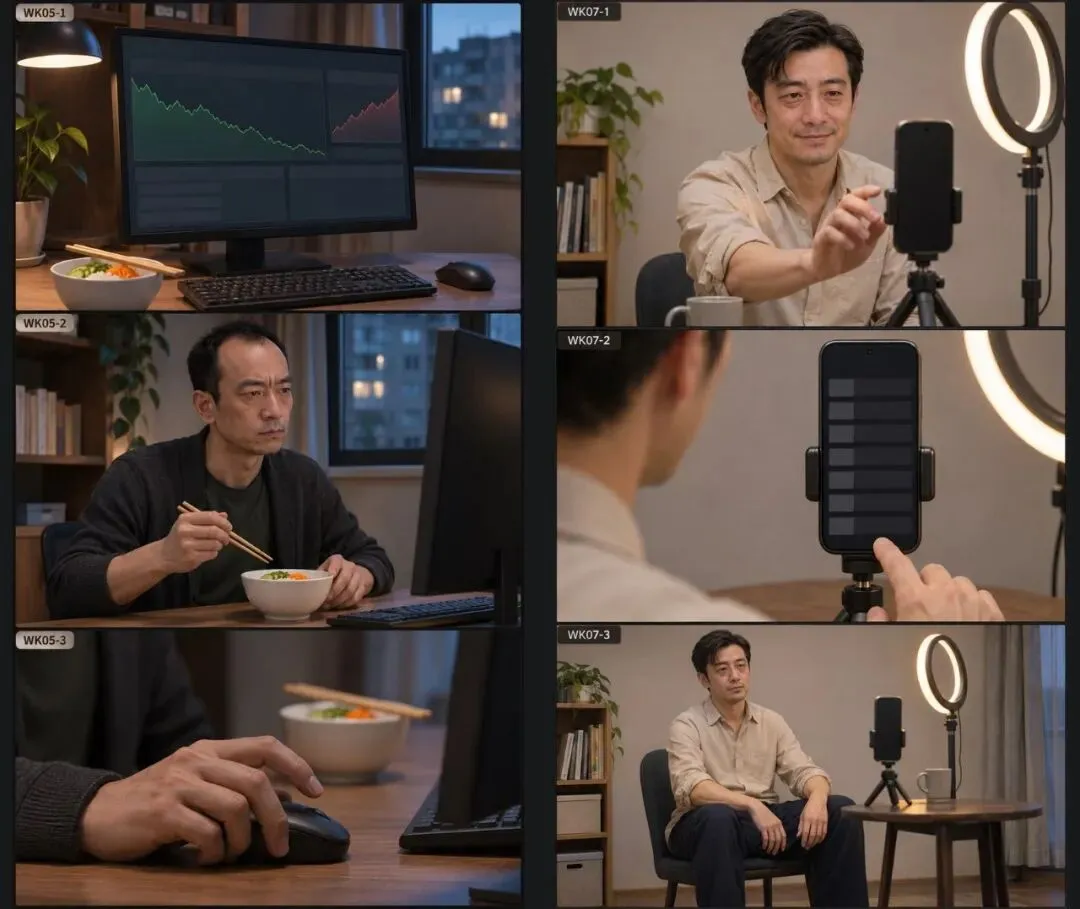
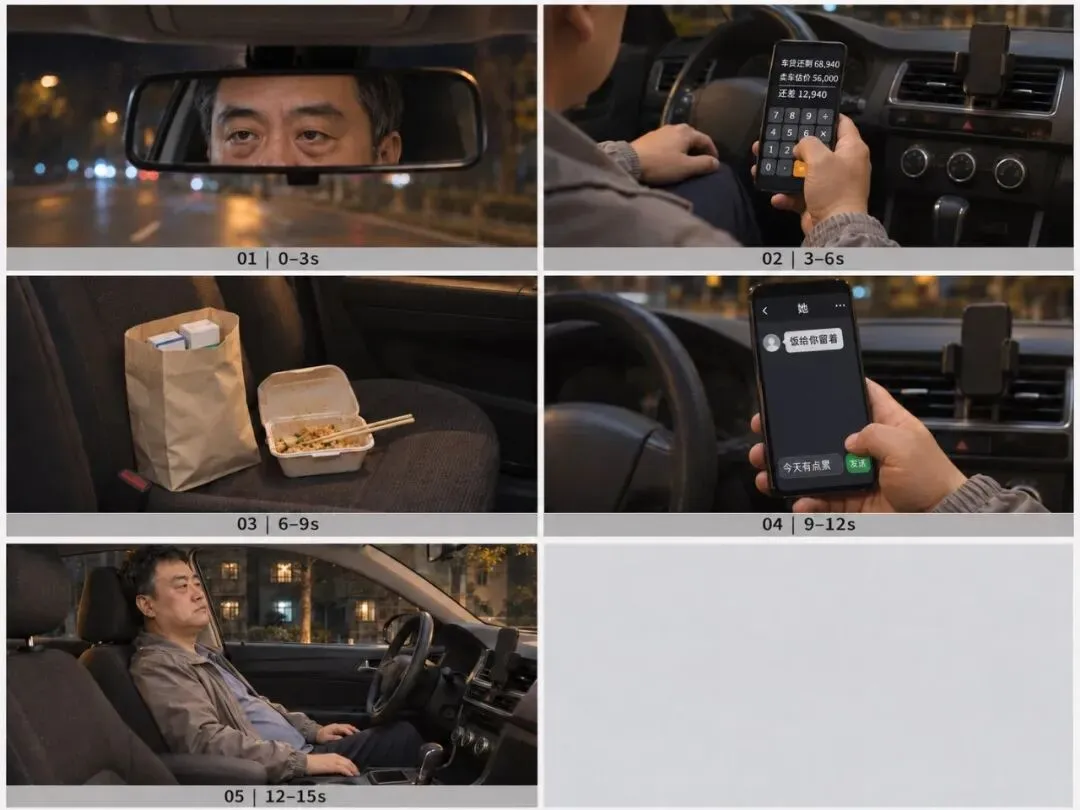
尾声里司机唱得比较多,我又补了一条15秒、分成五镜的设计:后视镜里看路、停车算卖车与还贷的差额、副驾上的药和冷饭、家人发来的消息,最后停在楼下多坐一会儿。手机里显示什么也要先做出来,比如“饭给你留着”,输入框里打了“今天有点累”却没发出去,这些小动作比再给一遍唱歌的正脸更有用。
工作插镜还暴露了一个很程序员的失误:我在参考素材里写了编号,方便管理,模型很听话,把编号也画进了视频,这轮成片里就留下了这样的画面。
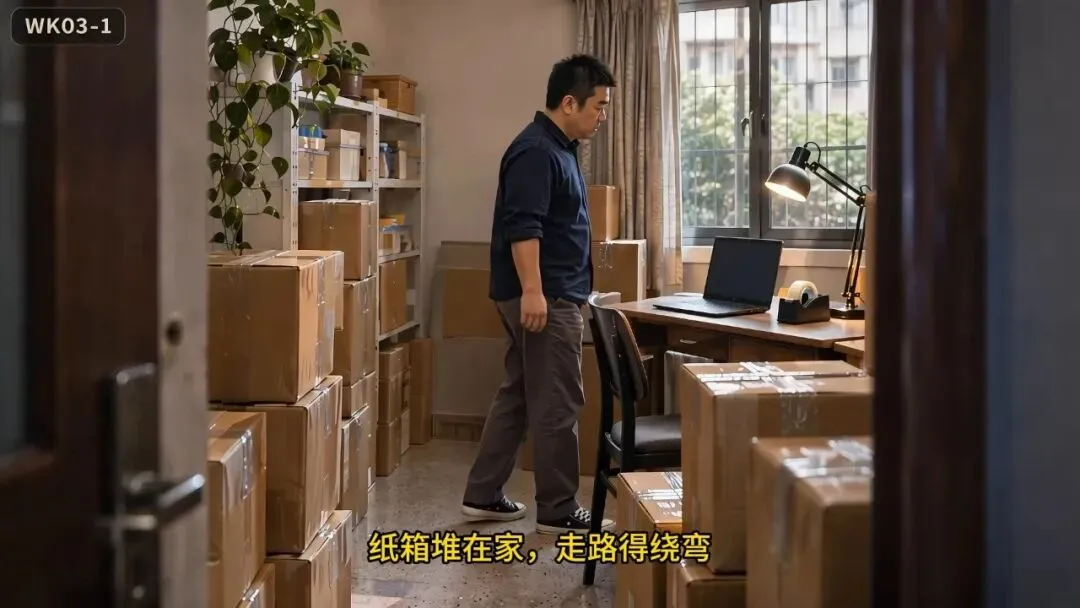
以后再做,编号就放文件名和画面外的说明区,有用的画面里别顺手写工作备注,剧情需要的手机、电脑文字也和制作标记分开处理。
到最后,片头、片尾、封面、台标、水印、字幕和人物第一次出场的身份牌也都要准备,身份牌单独做成透明PNG,放在人旁边,剪辑时再决定大小和时机,别把整张画面盖住。歌词还试过短段的逐字出现和粉末消散样片,做出样片以后,也得再看它跟整支片子的风格合不合。
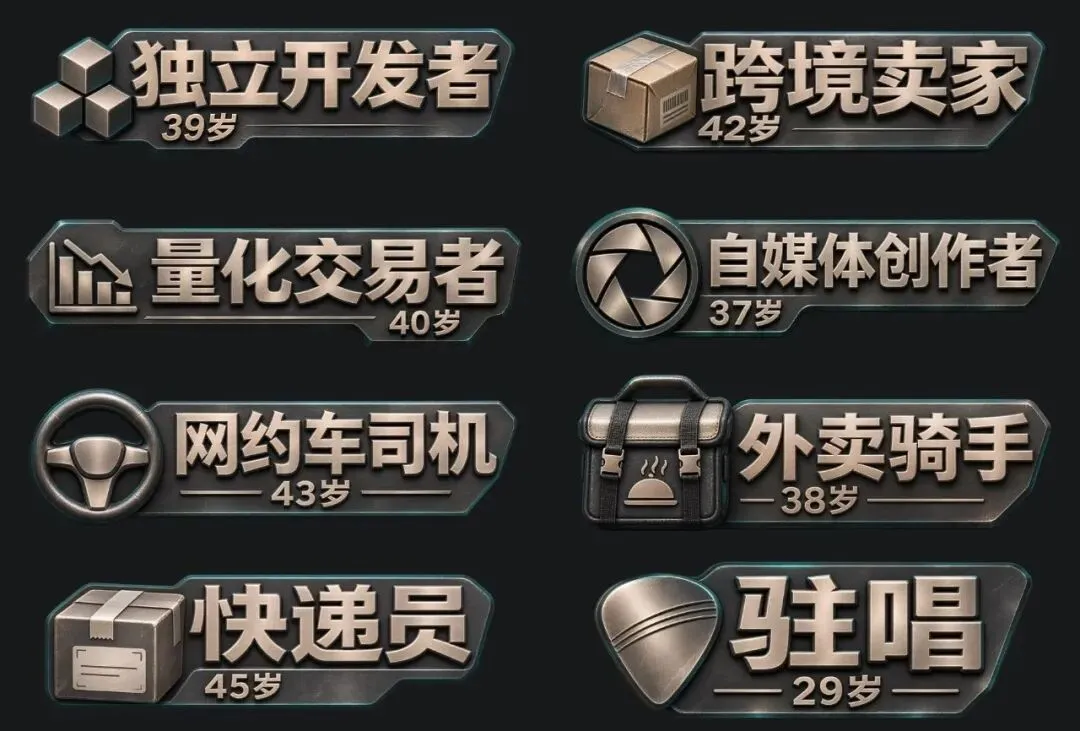
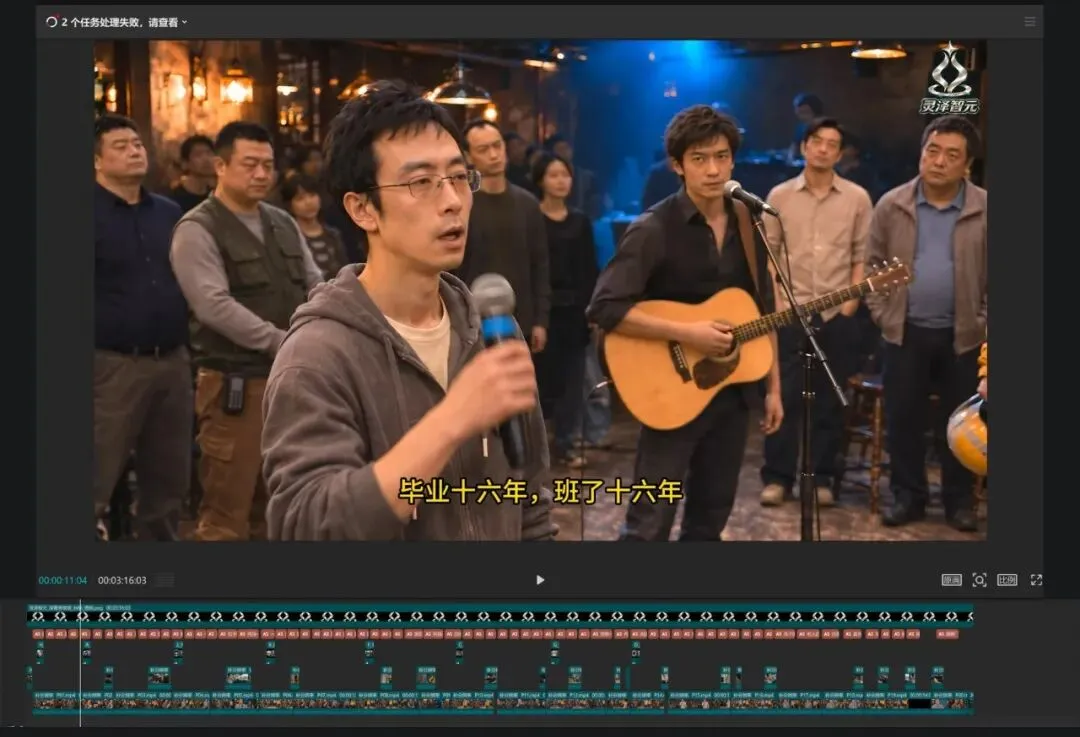
这些素材进了剪映,仍然要取舍、拼接、对口型、接换人、配音乐,一遍遍看完,才能把那些单独生成的片段收成一条完整MV。生成按钮点完的时候,离真正做完还有一段距离。
08◆
能做出来,不代表能挣钱
这首歌最后没有励志翻盘,车还停在楼下,想卖车先把贷款还上,算了又算,又想起卖了车,明天拿什么接单;上楼轻一点,别吵醒她们,明早还是七点半,睡醒就要接单了。
折腾到这里,这条MV总算符合了我的预期。我熬了几个通宵,把片子剪完发出去,再去看一眼B站当时的播放量,4。
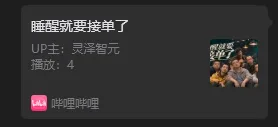
歌词里写“阅读个位数”,发布后,轮到我自己对着个位数的播放量发呆。工具可以买,视频可以一点点改,熬夜也能硬撑,可内容发出去以后,能被多少人看到,还得经过平台的分发。
这7000块充进去了,片子也做出来了,观众却不会跟着充值一起到账。上一回花了1000,没做出满意的片子,这一回又充了7000,总算做出一条自己愿意看的,能做出来,真不代表能挣钱。
延伸阅读:

