做 AI 短剧视频一个月:我删掉了整套方案,也堆了 130 行没用的提示词
- 2026-10-04 01:34:11
今年 8 月 17 号,我拉了个开源项目下来,准备魔改。
目标是做 AI 短剧。用 AI 生成角色、生成场景,一个镜头一个镜头地拼出一集剧。
一个月过去,我给这个项目写了一百三十多行规则,然后把整套方案删了。
那套东西我搭了两周,几十个提交。
先说背景:AI 做短剧,难在哪
让 AI 生成一集短剧,流程大概是这样:
先定角色长什么样,再定场景长什么样,然后一个镜头一个镜头地生成画面,最后把这些镜头合成到一起。
听起来是流水线,其实每个环节都在重新猜。
模型每次生成都是一次独立的脑补。你让它画女主角,第一次是长头发,第二个镜头换个角度,变成短发了。
不是风格变了,是换了一个人。
第一关:让同一个人,一直是同一个人
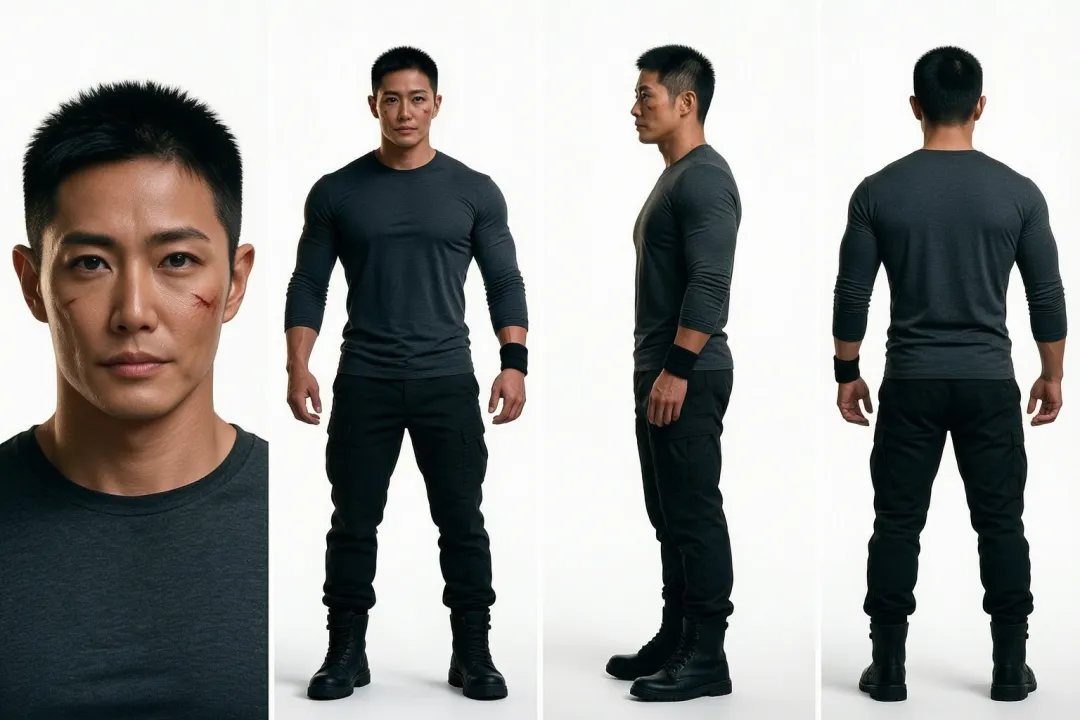
这一关我过了。思路不新鲜,就是给它一个参照系,别让它自己猜。
角色建立的时候先定一张初始设定图,之后所有衍生图,三视图也好变体也好,都必须以这张图为基准。
有个细节挺关键。参考的时候我在提示词里写死了一句:
「只参考这张图的长相,绝不参考里面的任何物品和构图。」
为什么非要强调「不参考构图」?因为参考图是会泄漏的。你让它参考一张站姿照,它下次可能把人摆回原来的位置。你以为你在传长相,其实你在传构图。
还有一条是引用必须稳定。同一个角色,同一场戏,从第一个镜头到最后一个镜头,必须引用同一个资产 ID。不能让模型每次重新描述一遍她长什么样。描述一次,就飘一次。
第二关:让同一个房间,一直是同一个房间
场景一致性翻车的方式更隐蔽。墙的位置飘了,门开的方向反了,左边的东西跑到右边了。
我一开始的做法是,先画一张平面示意图当「宪法」,再让每个机位都去参考它。
结果漂移更严重。
后来我才想明白为什么。平面图是符号,照片是实景,这是跨模态脑补。模型看着一张户型图去脑补一个真实房间里该有什么,它脑补得越自由,飘得越远。
这是我踩的第一个大坑:用错模态的参考图,是漂移的最大放大器。
宪法图后来换成了自南向北的平视实景,就是人站在房间南边朝北看过去的样子,1.5 米人眼高度,镜头水平,空场无人。这才有了一个真实、唯一、可复用的空间基准。
配套的还有两条硬规矩。
一、参考图只给一张。我试过一次给多张方位图,结果几张图互相打架。主流的视频模型,多图参考的语义是「锁定主体」,它不做空间几何推理。你给它五张图,它不会在脑子里拼出一个 3D 房间,只会把五张图搅在一起。
二、用罗盘方位,不用前后左右。因为「左边」是个相对概念,你站北边看和站南边看,左边是反的。所以我把全部方位统一成了绝对方向:自北向南、自南向北、自西向东。
还编了一句口诀防镜像:
自北向南,左东右西;自南向北,左西右东。
看着像小学生地理,但这句话救了我无数次。
不过我得说实话,这套方案不是终点。它是现阶段的最优解,不是最优方案。
本质上还是「一张 2D 图加一堆文字约束」在硬撑一个 3D 空间。真正干净的做法是把场景建成真正的 3D 模型。有了三维几何,机位、朝向、左右关系全都是算出来的,不需要查表,不需要自检,也不需要一百三十行规则。
这是我下一步要做的方向。现在这套,是在 3D 还没落地的阶段能撑住业务的版本。
然后是最贵的一课:我删掉了整套 3×3 母版方案
场景一致性最狠的一招,我一开始想的是:一次生成一张 3×3 的九宫格环绕母版图,把房间的八个方位一次画全,之后所有机位都从这张图上裁格子去精修。
思路很漂亮,一次成型,天然共享同一套几何。
我搭完了,一堆提交,跑起来了。
然后真机反馈打了脸。时序不可靠,用户期望也对不上。最后我把整套母版基础设施回退撤销了。
但这一退,退出了整个项目最重要的一句话:
模型没法在多次独立生成之间,保持同一个空间的记忆。
你写多少文字规则,都对抗不过它的视觉先验。
我在这一关上,规则堆到了一百三十多行。转盘机位、左右缘查表、镜像自检、正交反打取证、墙面内容清单,还是不收敛。
不是规则不够多,是方向错了。
想通之后:减少自由度,而不是增加约束
真正管用的三个转折,全是「少让模型发挥」:
一次成型。别让它分八次画一个房间。后来的环绕视频方案就是这个思路:一段 360° 环绕拍下来,首帧接尾帧,帧与帧天然共享同一条几何轨迹。 单张匹配参考。别给一堆图互相打架,一个机位只给一张最匹配的方位图。 能算的别让它猜。查表这种事交给代码算好,直接喂给它。缺了关键参考图就直接报错,不许它降级硬编。
这个月我最大的收获不是学会了怎么写提示词,是学会了什么时候不该写提示词。
还有一关,是「位置」
前两关解决的是「长得一样」和「房子一样」。第三关更刁:同一场戏里,人不能瞬移。
观众可以原谅画风差一点,但两个人本来面对面说话,切个镜头都看向同一侧了,一眼就出戏。
我原来的做法很外行,直接写「人物在画面左边」。
后来才改对,给每个角色规划世界坐标站位。
具体就是:这个镜头开始,他站在办公桌南侧朝北;镜头结束,他走到了窗边。上一个镜头的结束位置,必须等于下一个镜头的开始位置。对不上,就是瞬移。
而且这个字段在保存时是硬校验的。有角色的镜头没填站位,直接拒绝保存,并且指名是哪个镜头,打回去重写。
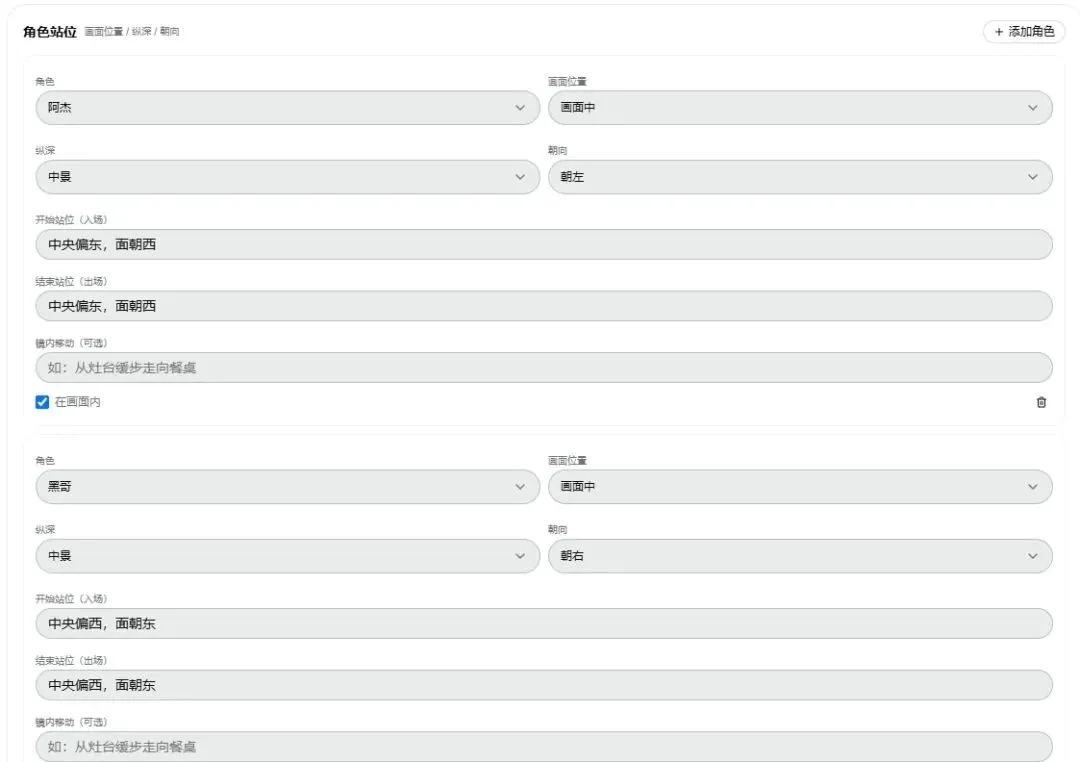
我特别喜欢这个设计,因为它逼着模型返工,而不是让它偷偷糊过去。
画面左右的位置也统一查那张罗盘表。切到反打机位,左右必须互换。不换就是越轴,两个人本来面对面说话,切个镜头都看向同一侧了,观众看着别扭,但说不上哪不对。
最后是接头:同一个场景里,上一个镜头的最后一帧,就是下一个镜头的第一帧。
注意,这条只在同一个场景内成立。一旦换场景就不继承了,因为环境都换了,硬接反而会出错。时间跳跃、主体切换、或者需要一个全新交代镜头的时候,也一样不继承。
而且它必须严格按顺序一个一个生成,不能并行。因为第二个镜头的开头,得等第一个镜头的结尾先出来。
这一个月,我到底学到了什么
我以前做了十几年电商系统。那套东西复杂度不比这低,但它有个好处,状态是明确的。订单走到哪一步,数据库里写得清清楚楚,出错了能查、能补、能回滚。
AI 生成不是这样。它每一步都「差不多对」,你得自己去揪出哪一步是真的对。
这一个月最大的三个体会:
第一,文字规则对抗不过视觉先验。我堆了一百三十多行,输给了一张图。该给图的时候别写小作文。
第二,减少自由度比增加约束有用。与其告诉它不要这样不要那样,不如直接把它的选择砍掉。
第三,一次失败的方案也是资产。那套 3×3 母版我删掉了,但正是它让我想明白「一次成型」才是对的路,后面的方案全是从这个结论长出来的。
项目还在改。现在写实景宪法图、罗盘方位、站位链、尾帧继承这一套都在跑,但还有一堆债没还。生成的画面好不好,目前只能靠人眼看,没有自动验收;侧视角和正视角之间还是会偶尔对不上;再往上,就是把整个场景换成 3D 模型那条路。
这条路还长。做 AI 短剧这一趟,我不是做完了来教你,我是踩到了来告诉你这坑长什么样。

