AI短剧已经不假了,但你还是觉得哪里不对:差在这112毫秒
- 2026-11-19 16:15:21
本文数据引自行业公开报告、券商研究、平台公开信息及公开技术测试数据。人脑感知阈值与技术精度数据为特定测试条件下的结果,不同测试方法可能存在差异,仅用于说明量级关系。本文不构成投资建议。
刷到AI短剧的时候,你大概有过这种体验。
画面很精致,人物很像人,你甚至能看出来它是AI做的——但你说不出哪里不对。
说不出不对,是因为破绽不在那些大地方。
一、那个让人说不出的别扭,来自哪
先看一组对比。
今年上半年,AI仿真人剧的表现是这样的:抖音端 AI 仿真人剧剧目数占比突破 60%,百强榜占比从2025年的 7% 升至2026年5月的 89%。AI短剧用户规模从2025年底的 1.2 亿跃至 6 亿以上。
从数据看,"AI味"已经不是致命伤了。
但技术上的真相更微妙。
有个说法很准:当前 AI 角色的五官已经相当精致,真正暴露"伪人感"的往往是眼神、口型、微表情和动作节奏——脸在笑,眼神却波澜不惊;嘴在动,面部肌肉却总慢半拍。
单看某一帧,没问题。连着看三十秒,浑身不对劲。
这就是恐怖谷效应。1970年,日本机器人学者森政弘提出这个概念:当一个非人对象越来越接近真人、却又没能真正达到自然状态时,人的亲近感会突然转成反感。
而动态表现会进一步放大这种落差。静态图不走形,一动起来就露馅。
有个数据挺有意思:某平台 AI 短剧 AI 演员方桃子出道30天吸粉40万,60秒广告报价25.8万元,贵过不少千万粉丝的真人网红。
数据在涨,但那种"说不上来的别扭"从来没消失。
二、一条能测量的线:80 毫秒
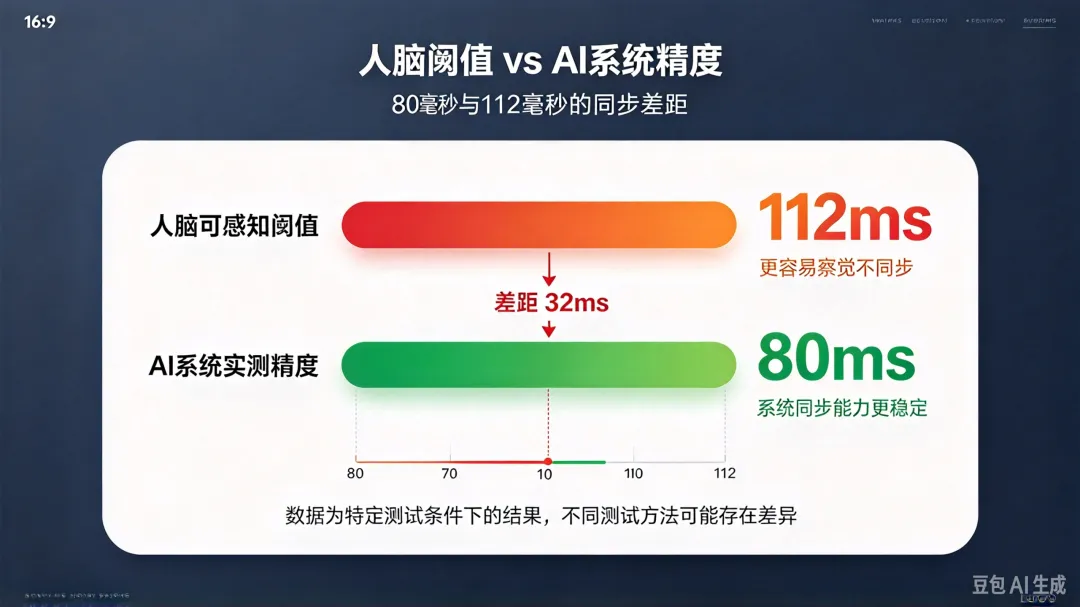
这是全文最硬的一个数据。
有测试数据显示,人脑检测出音画不同步的阈值大约是 80 毫秒——不到十分之一秒。
而 2026 年主流 AI 视频系统的口型精度,大约是 ±112 毫秒。
80 和 112,差距不到一眨眼。
但这条线正好卡在"你意识不到,却能感觉到"的位置上。
所以你会有那种说不清的别扭:知道哪里不对,但指不出来。
这解释了一个长期困惑:为什么观众说不出AI剧哪里假,却就是不追。
原因不在剧情,也不在画质,而在你的听觉阈值被反复轻轻戳着。
三、更要紧的是:AI的做法从根上就错了
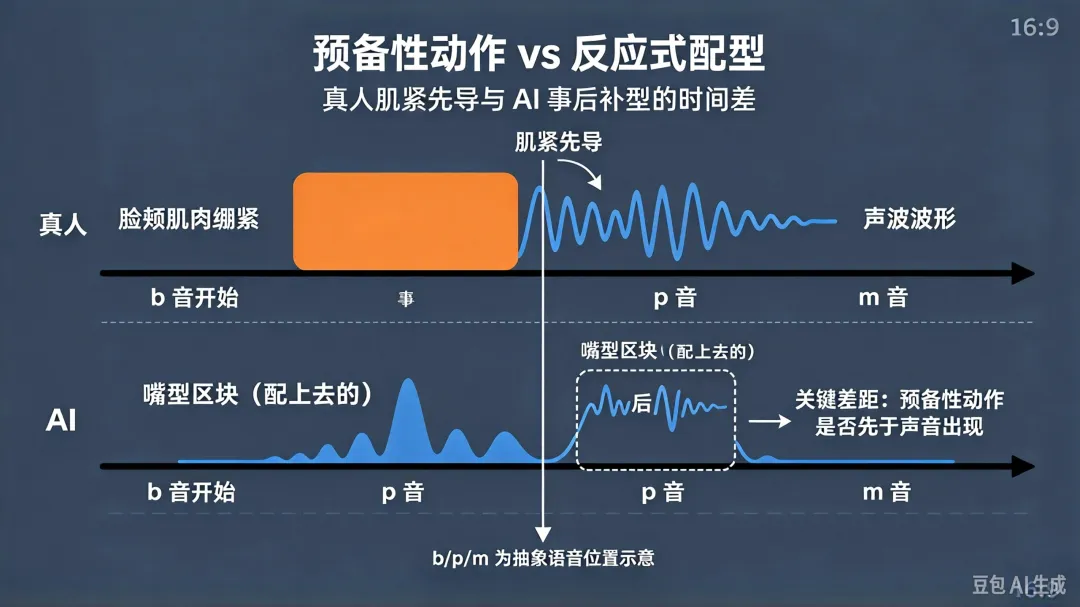
关于为什么偏偏是"嘴"这个部位最先暴露,有个被低估的解释。
真人说话是预备性的:发"oo"这个音之前,嘴唇已经开始收圆了;发 p、b 这类爆破音之前,脸颊肌肉已经先绷紧了。
嘴不是跟着声音动,是抢在声音前面就位。
而 AI 是反应式的:先有声音,再去摆嘴型。
这一点差别,决定了它永远是"配"上去的,不是长在脸上的。
所以严格说,AI现在的问题不是"精度不够",而是"时序错了"。
精度可以靠算力堆,但时序逻辑要重建。这不是量的问题,是质的问题。
还有个心理学现象必须提,因为它解释了为什么这种错误格外难受。
1976年,心理学家麦格克和麦克唐纳做了个著名实验:让受试者看一段视频,画面里的人嘴型在发"ga",但放出来的声音是"ba"。
结果绝大多数人报告自己听到的是——"da"。一个既不是画面、也不是声音的第三种音。把条件反过来,也有约一半人听到了混合音。
这就是麦格克效应。它说明一件事:大脑在处理语言时,会把嘴型和声音强行合并成一个东西。
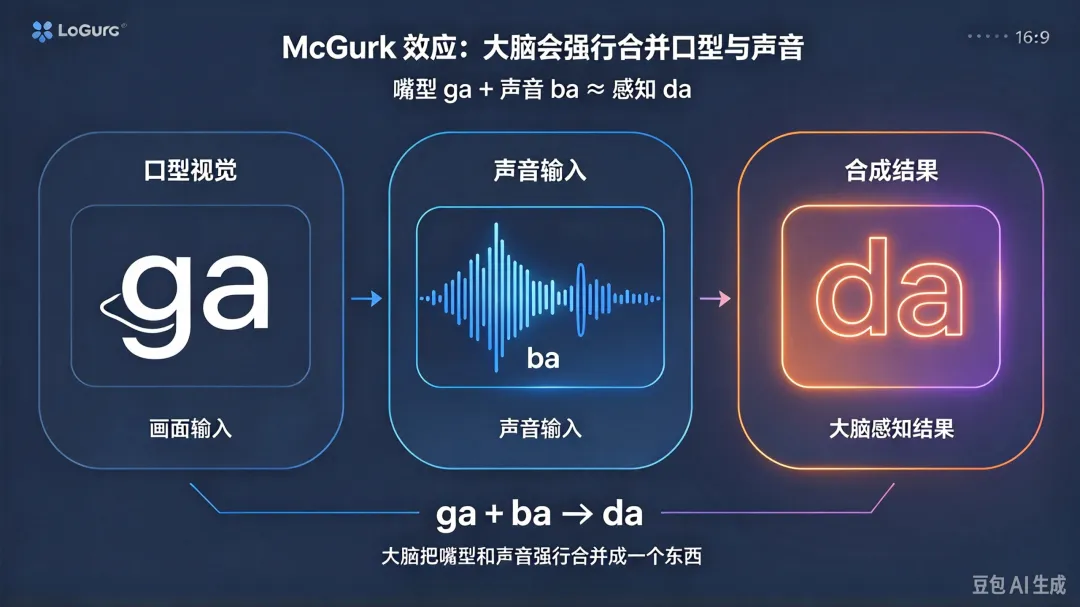
哪一边对不上,它不会"分别相信两边",而是自己捏一个新答案出来。
而且这个效应极顽固——你事先知道原理,照样会被骗。
所以指望观众"看久了就习惯了",恐怕指望不上。
四、95% 的一致性,救不了30集
第二个硬指标,方向正好相反。
据2026年行业报告,当前 AI 角色一致性技术已达到 95% 水平,基本满足工业化需求。
听起来已经很好了。但有个问题被点得很准:剩下那 5% 的漂移,在 30 集量级下会被放大。
第1集和第30集并排看,面部细节、发色、服饰纹理的微小差异,会被客户一眼抓住。
这里有个实操层面的判断值得记:如果客户验收时只拉单集看,大概率看不出来。所以正确的验收方式应该是拉第1、10、20、30集并排对比,而不是只看单集。
还有个更隐蔽的坑:如果每集都用同一张参考图且不更新,漂移速度会加快。
目前主流做法是每若干集重置1次角色参考图。这个动作看着不起眼,但它直接决定30集商单能不能过验收。
所以关于角色一致性,准确的表述是:这条线已经从"碰运气"挪到了"可控"。
行业公认的事实是:没有任何模型完全解决了跨镜头漂移,只是漂移概率高低之别,生产端仍要工程手段兜底。
这句话很诚实,也很重要。它意味着模型厂商已经把接力棒交到了制作方手里。
五、真正没被解决的,是眼睛
前两个指标都是可量化的。但仿真人最难的那道门,恰恰没有数字。
有个观察我觉得比任何数据都准:脸部特写已经过关了,眼睛还没有。
创作者追求的微观表演方向是"眼神有戏"——眼动轨迹、微表情、咬字口型都能被表演驱动工具映射到一张AI脸上。但即使这样,画面上的人物眼神仍然是静止的。
更有意思的是观众的一句评价:"他们笑起来眼睛没动。"
这一句把问题点透了。
微表情是那种持续几分之一秒的、常常无意识的肌肉运动,它承载的情绪信息比例远超它的时长。经典的 Ekman 面部动作编码系统就是干这个的。
后来的实验也验证了:当这些转瞬即逝的信号缺失或机械重复时,观众会认为表演的真诚度、可信度、情感反应都更差。
大脑天生就是用来注意这种缺失的。
而微表情恰好落在既有框架里、又最难被规则化——它不是"笑"或者"不笑"这种二元状态,而是眼周肌肉的细微收缩、瞳孔的轻微变化、注意力转移的时机。
让AI稳定复现"眼周肌肉的细微收缩",目前仍然很难。
还有一个反直觉但有说服力的观察:有分析指出,在 AI 生成的画面里,有意保留细微不完美感的素材,留存和分享表现反而优于纯精致输出。
也就是说,太完美,本身就是一种假。
六、拆开看AI仿真人的四道门槛
综合起来,AI仿真人剧现在是这样一副体检表。
四项的顺序很重要:越往后越是硬骨头。前三项都能用工程手段换算成参数,第四项不行——微表情是连续量,不是布尔量。
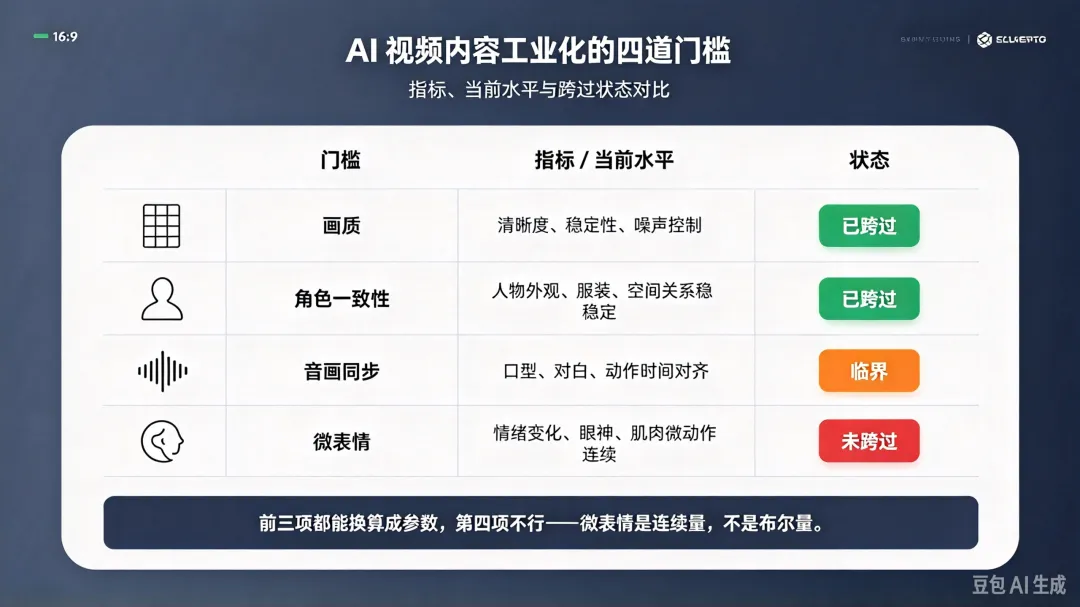
你可以把"嘴角上扬多少度"写成参数,但你没法把"眼周肌肉的细微收缩"写成参数。
这也解释了为什么仿真人剧在漫剧百强榜里占比一路涨到89%,但真正被反复讨论的、让观众觉得"还是有点假"的,始终是眼神和口型。
七、这场竞争的下半场,壁垒在哪里
数据上,AI仿真人剧已经赢了。
AI短剧总播放量达 1300 亿,其中 AI 仿真人剧占 750 亿,超过2025年全年的总和。AI短剧用户从 1.2 亿涨到 6 亿以上,渗透率已经接近行业天花板 30% 的四分之三。
但 AI 仿真人剧也有一条硬约束:当前场景下,短剧行业单用户付费转化率落在 0.8%–1.2% 区间。
所以技术上刚刚跨过恐怖谷,经济上还没跨过付费墙。
这中间的差距要靠什么补?
第一项,可能是IP和剧本。AI把制作成本打下来了,但内容供给端仍高度同质化,差异化必须从故事来。
第二项,可能是把瑕疵当成风格。既然纯精致反而显假,那么有意识地保留一些不完美——轻微的呼吸感、不那么标准的构图、一点点手持晃动的味道——可能反而成为辨识度。
第三项,可能是那些还没被解决的技术指标。当所有人都做到60%的仿真人,做到61%就没意义了;但当所有人都做到60%而你做到了70%,那就是壁垒。
而70%在哪里?很可能就在那两个数字上:80 毫秒,和眼周肌肉的细微收缩。
八、写在最后
AI仿真人剧的故事,本质上是一个"看得太快"的故事。
从 7% 到 89%,从 1.2 亿到 6 亿,技术跑得比用户认知快太多。
结果就是那个最尴尬的处境:观众已经接受它是AI了,但还没接受它是"好的AI"。
不过换个角度,这未必是坏事。
因为观众愿意点开一部AI短剧,本身就说明AI仿真人已经跨过了那道"要不要看"的门槛。而"好不好看"这个问题,恰恰是创作侧还能竞争的地方。
所以真正的机会不在于把AI做得更像人——那条路越走越贵,且终点并不存在。
而在于用AI做出真人才做不出的东西。
你觉得AI仿真人剧现在最明显的破绽在哪?是口型、眼神,还是那种"太完美"的塑料感?评论区聊聊,如果你做过AI短剧的技术或制作,欢迎说点真实的坑。
数据来源:券商研究报告、平台公开信息、行业公开报道及公开技术测试数据。人脑感知阈值与系统精度数据为特定测试条件下的结果,不同测试方法可能存在差异,仅用于说明量级关系。本文不构成投资建议。

