S+级真人AI短剧全流程制作步骤,提示词分享,请自取(第二十一期)
- 2026-11-14 08:22:32
S+级真人AI短剧与普通AI视频的核心区别,不在于用了多贵的模型,而在于是否把“抽卡式生成”升级为可管理、可复现、可返修的工业化流程。以下按从立项到出片的完整链路拆解,关键环节附可直接改用的提示词模板。
先定调:S+级的门槛在哪里
平台侧的S+级审核,已经细化到画面衔接、人物形象、表情变化、音画同步四个视觉维度。一部片子因为“人物换镜变脸”被打回,损失的不只是时间,更是平台保底和推荐权重。因此,全流程的每一个决策,都要以“可锁定、可判废、可批量”为前置约束。
第一阶段:立项与剧本工程化
动作要点
不要上来就问“用可灵还是即梦”。先回答三个问题:受众与平台(男频/女频、18—24还是25—34、抖音还是小程序)、题材与一句话卖点(重生复仇/霸总虐恋/悬疑反转,用一句话锁死方向)、质量档位(S+/S/A,直接决定后续资产投入和判废容忍度)。
剧本不能写成“演员读的剧本”,必须写成面向机器生产的工程化剧本。至少包含:人物可视化标签、场景标准化参数、镜头可拆解信息、情绪标签、生成可行性标注。
可复用提示词:短剧剧本工程化
请帮我把以下想法扩写为一部10集、每集3分钟以内的竖屏短剧工程化剧本。想法:[一句话梗概]硬性要求:1. 每集结尾必须有强钩子;平均每30秒一个小反转或情绪钩子。2. 人物设定极致反差,主角前期被压制、后期反击,反派表面温和实则狠辣。3. 台词口语化、短句为主,避免大段说教。4. 输出格式:每场戏包含 场景ID / 地点 / 出场角色(含情绪标签和动作节拍)/ 对白 / 镜头类型 / 预估时长 / BGM风格 / 音效标注。5. 每个角色附带“可视化外貌标签”:年龄+肤色质感+面部关键特征+发型发色+固定服装+体型气质。6. 标注每一场中“不适合AI生成的动作”(如复杂肢体交缠、快速多人调度),以便提前规避。这个提示词的关键在于第6条:提前标注AI不擅长的动作,比生成失败后再返修便宜得多。
第二阶段:资产锁定——S+级最不能省的一步
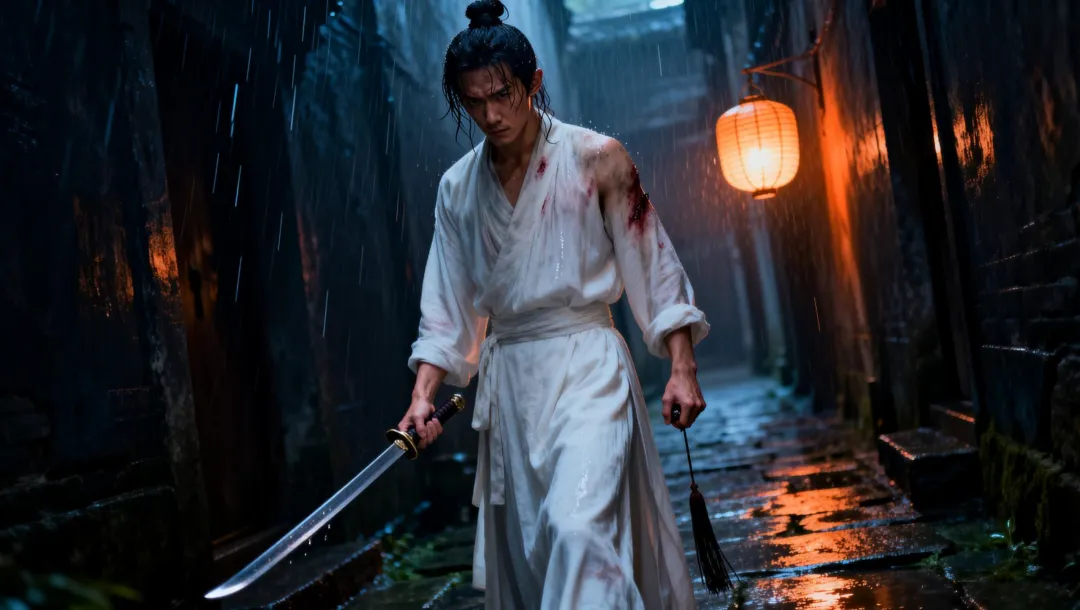
人物变脸、服装漂移、风格不统一,本质上都是资产管理问题,不是提示词问题。
定妆资产规范
每个主要角色在开拍前必须产出并锁定以下资产:
| 资产类型 | 规格要求 | 用途 |
|---|---|---|
| 大头照 | 只含头部,纯色背景,正面 | 面部特征的最终锚点 |
| 全身照 | 自然站立,双臂下垂,正面朝镜头 | 体型、服装、比例的基准 |
| 稳定文字标签 | 2—3个不可变的静态特征(如“左眼角小痣”“齐耳黑色短发”“深绿色长风衣”) | 每次提示词中重复写入,防止漂移 |
合规注意:火山方舟和即梦官方均明确,Seedance 2.0/2.5 系列不支持直接上传含真人人脸的参考图/视频。实操路径是:先用文字把人脸“写”出来生成定妆图,定稿后不再改动,后续所有镜头挂这套定妆图作为参考。
可复用提示词:真人定妆照生成
为以下角色生成高清真人定妆照,纯白背景,正面、侧面、半身特写三张。角色文字定义:[年龄/种族] + [肤色质感,如“白皙、带自然毛孔质感”] + [面部关键特征,如“鹅蛋脸、左眼角一颗小痣”] + [眼神质感] + [发型发色,精确到长度和刘海] + [固定服装,一场戏只锁一套] + [体型与站姿]画质要求:8K超高清,真人实拍质感,电影级柔光,皮肤保留毛孔纹理,无AI磨皮感,无畸形手指。负面约束:禁止过度打光,禁止滤镜感,禁止改变面部骨骼结构。定稿后,这套图就是全剧该角色的唯一视觉基准。后续任何镜头出现“不像”,直接判废重跑,不修。
场景与道具资产
场景同样需要“空镜基准图”:全景、中景、特写各一张,锁定空间结构和光线基调。道具(手机、戒指、武器、信件)需要单独出图并记录文字标签,防止在相邻镜头中凭空出现、换手或消失。
第三阶段:分镜提示词——从“描述”升级为“可执行镜头指令”
普通提示词写“她伤心地站在雨里”。S+级分镜提示词需要写成一组可拍、可控、可返修的镜头指令:站位关系、动作幅度、情绪触发点、运镜边界、时长,全部明确。
可灵/即梦通用五段式结构
业界已验证的稳定结构为:主体 + 动作 + 环境 + 光影与氛围 + 镜头运动。
[CHARACTER: 角色标签][主体定义:固定标签重复][动作:单一动作,写死幅度和方向][环境:场景空镜标签 + 时间/天气][光影:光源方向 + 色温 + 质感][镜头:景别 + 运镜方式 + 时长][负面约束:禁止项]示例(雨夜便利店,男主) :
[CHARACTER: 陆川] 三十二岁中国男性,皮肤偏冷白、有自然纹理,下颌线清晰,眼神沉郁,短寸黑发,深灰色连帽冲锋衣,身形偏瘦但肩背挺直。9:16竖屏,中景。陆川推开便利店玻璃门,雨水顺着门框滴落。他停在门口,目光扫向货架尽头,右手将湿透的帽檐向下压了压。便利店内部冷白荧光灯,门外雨夜街道为深蓝冷调,光线从右上方打入,面部左侧保留自然阴影。固定镜头,轻微手持呼吸感,时长4秒。禁止:面部磨皮、过度暖光、人物走出画幅。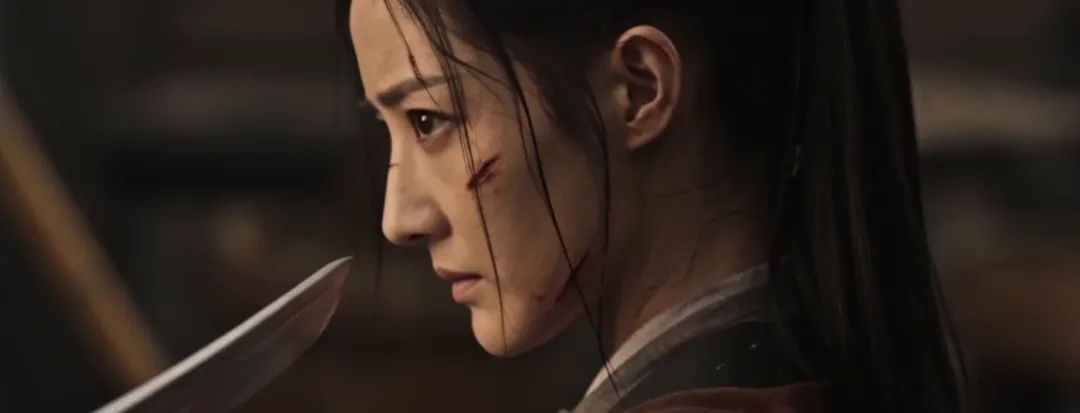
人物视觉统一的“四要素锁”
如果模型仍然出现漂移,在每段提示词最前面强制加上四要素锁:
hairstyle: [精确到长度/颜色/刘海/纹理]skin: [明度/冷暖/毛孔质感]accessory: [每镜必现的标志性配饰]outfit: [本场锁定的一套服装]表演与微表情:S+与普通片的分水岭
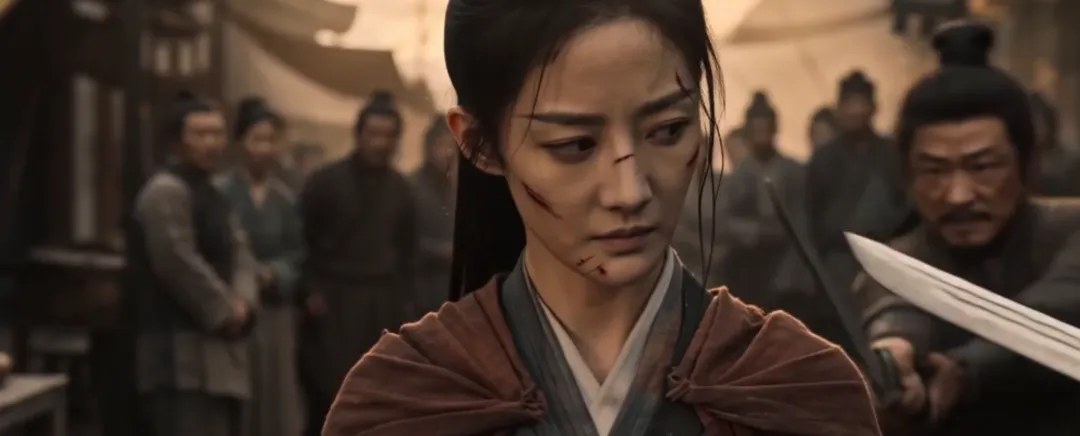
“表情太假”的根源是把抽象情绪词直接丢给模型。S+级需要把情绪拆成时间轴上的生理信号:眼神、眼睑、眉部、面颊、鼻翼、嘴唇、下颌、呼吸、吞咽。
可复用模板:克制微笑(0—1.5秒)
0—0.3秒:眼神先变柔,眼轮匝肌轻微收紧,嘴角保持静止。0.3—0.8秒:颧大肌带动嘴角向耳侧上提约2毫米,闭嘴浅笑,不露齿。0.8—1.5秒:保持笑意,眼神稳定注视对方,每3—4秒一次缓慢眨眼。禁止:嘴角先于眼神动作、露齿、挑眉、面部肌肉过度拉扯。这套写法可以直接写入图生视频的 motion prompt 或首帧表情引导中。对于S+级项目,建议每个情绪节拍单独出一段3—5秒素材,而不是让模型在一次生成中完成复杂情绪转折。
第四阶段:生成、配音与口型对齐
生成策略
逐镜生成,单段控制在3—5秒,以定妆图和场景空镜作为首帧参考。双人同框时,开启高 input fidelity(如 input_fidelity=high)防止串脸。固定 seed 和采样器,每次只改表情和动作,不改角色描述——这是可复现性的底线。
配音与口型
配音分两条路:TTS 批量生成 + 后期口型对齐,或生成时直接携带原生音频。如果使用外部 TTS(如 edge-tts、FishAudio、CosyVoice),按镜号命名音频文件,装配时逐镜对位;口型同步可使用支持 lip sync 的工具(如 SoundView、万兴剧厂等)在后期统一处理。S+级审核中“音画同步”是明确维度,口型偏差超过可感知阈值即构成硬伤。
第五阶段:判废与QC——S+级不可妥协的关卡
出片后不凭“感觉”决定是否通过,而是按判废表逐项核查:
| 判废项 | 判定标准 | 处置 |
|---|---|---|
| 脸 | 与定妆图的面部骨骼/关键特征(痣、疤、眼型)不一致 | 直接判废,重跑 |
| 服装 | 与本场锁定服装不同色、不同款、多出/缺少配饰 | 直接判废,重跑 |
| 人数 | 同框人数错误,或背景人群抢主体 | 裁切/重跑 |
| 动作 | 动作幅度明显超出提示词约束,或出现肢体畸变 | 判废或局部重跑 |
| 口型 | 与配音对不上,或口型幅度明显失真 | 后期 lip sync 修复或重跑 |
| 衔接 | 相邻镜头站位跳变、道具消失/换手、光线方向矛盾 | 按连镜规则返修 |
这套判废逻辑来自一线生产实践:只返工“车祸级”问题,不为“不够完美”反复抽卡。追求完美是最贵的返修策略。
全流程速查
| 阶段 | 核心产出 | S+级不可省 |
|---|---|---|
| 立项 | 受众/平台/档位/一句话卖点 | 档位决定后续判废容忍度 |
| 剧本工程化 | 可视化标签 + 结构化分场 + 生成可行性标注 | 前置规避AI不擅长的动作 |
| 资产锁定 | 大头照 + 全身照 + 2—3个文字标签 + 场景空镜 | 全剧唯一视觉基准,定稿不改 |
| 分镜提示词 | 五段式结构 + 四要素锁 + 微表情时间轴 | 可执行、可判废、可局部返修 |
| 生成 | 3—5秒/镜,seed固定,首帧参考 | 不追求一次完美,追求可复现 |
| 配音/口型 | 分角色TTS + 逐镜对齐 | 音画同步是审核硬维度 |
| 判废/QC | 脸/服装/人数/动作/口型/衔接六项 | 按表判废,不凭感觉 |
S+级的“S”,本质上不在某一个提示词写得有多华丽,而在于从第一张定妆图到最后一帧口型,每一环都有锁定机制和判废标准。把这套流程跑通一次,后面的每一集都是在同一套资产和规则上做增量,而不是重新抽卡。

