AI短剧刷屏了,一句话就能拍出好故事吗?
- 2026-11-16 00:13:06
输入一句“戴蓝围巾的橘猫走过雨夜街道”,屏幕上便出现湿漉漉的石板路、暖黄色的灯光和一只迈着小步的猫。几秒钟的画面,已经很有电影的味道。
但如果再提几个要求呢?让它走过路灯后还是同一只猫,围巾颜色不变;让它跳上台阶时,四肢和落点都合理;再接一个近景,让观众看懂它为什么停下来。
漂亮的镜头有了,能不能把故事讲明白,还得另说。
一、AI短剧热起来,靠的只是画面更漂亮吗?
今年以来,AI短剧、漫剧和创意短视频持续受到关注。10月14日,新华社发布了讨论AI短剧热潮的视频报道[1];DataEye发布的2026年9月抖音端AI剧漫剧百强榜中,AI仿真人剧占57席,上月为38席[2]。这里的“百强”有平台和统计口径的限制。不过,这个榜单也让人看到,AI生成的内容正进入人们日常刷到的视频里。
热度之外,画面本身也值得看一眼。下面这张《斩仙台AI真人版》剧照,来自今年1月的报道:人物面部、金属铠甲和光影已有仿真人影像的质感[3]。但只看一张剧照,还不知道人物动起来、表情变起来是否自然,这得放到连续的视频里看。
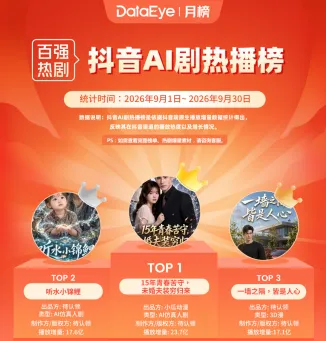
(a)DataEye“2026年9月抖音AI剧热播榜”前三名节选(图片来自网络)
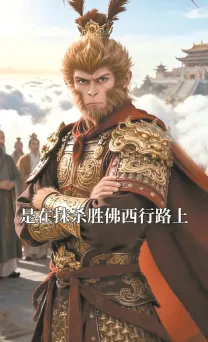
(b)《斩仙台AI真人版》剧照(图片来自网络)
图1 AI短剧的爆火
这种热度并不难理解。过去,一个古装奇幻场景可能需要置景、服装和特效;现在,创作者可以先把构想转成画面,试出大致风格。对短视频而言,一次出人意料的视觉变化,就可能成为吸引人停留的理由。
不过,“AI短剧”背后并没有一套统一的做法。有的用AI生成主要镜头,有的主要采用生成图片、局部动画和剪辑。要是以为“输入整本小说,自动输出一部剧”就是全部过程,就忽略了背后大量的创作劳动。
短视频和短剧,对生成能力的要求也不完全相同。一个几秒钟的奇观镜头,可以靠新鲜感抓住注意力;一个持续展开的故事,则需要角色稳定、空间清楚、情节接得上。让观众停下来多看一眼,和让观众追到下一集,还是两回事。
二、一段文字,怎样变成连续画面?
理解AI视频,可以先把“训练”和“生成”分开。
训练时,模型从大量视频及其文字描述中学习:什么样的外形对应“橘猫”,怎样的姿态变化对应“行走”,雨夜的光线和地面反射通常如何呈现。对于许多扩散或流匹配路线的模型,学习过程还包括从加入噪声的表示中,预测怎样逐步恢复视频结构[4][5]。
生成时,模型接收新的描述,从随机噪声出发,反复更新内部表示,逐渐形成符合要求的内容。你可以把它想象成:一团杂乱的“雪花”,慢慢显露出猫、街道,以及猫向前走的动作。这只是便于理解的比喻,实际计算往往发生在视频的压缩表示中。
为什么同一句话,多生成几次,猫的样子、走路速度和街道细节都可能不一样?因为生成过程带有随机性,文字又只规定了部分条件,剩下的细节有不止一种合理的呈现方式。创作者还得从这些结果里,挑出符合自己想法的那一版。
为什么要压缩?因为视频的信息量太大了。10秒、每秒24帧,就有240幅画面。许多模型先把画面和时间信息编码成更紧凑的表示,在其中完成生成,再通过解码器还原成可观看的视频。CogVideoX等公开研究就采用了对空间和时间进行压缩的设计[6]。
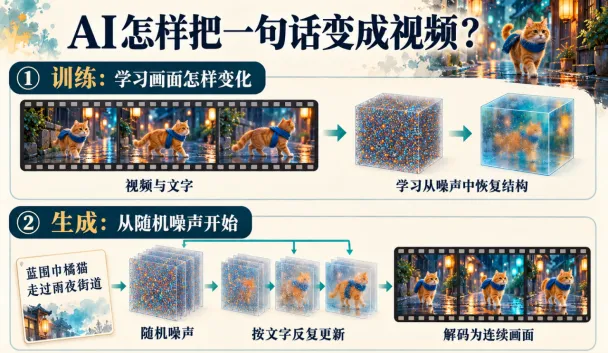
图2 AI视频生成的简化流程
关键还在于“时间”。如果每张图都各画各的,橘猫可能一会儿胖、一会儿瘦,围巾也可能忽然换色。视频模型需要在生成过程中联系不同位置、不同时间的信息,协调主体、动作和镜头变化。Wan采用的时空注意力机制,就是把这些信息联系起来的一种办法[5]。
一幅图只需交代某一刻,视频还得把前后的变化接起来。
三、画面很真,为什么还是会“穿帮”?
第一道关,是身份一致。猫转过身、被路灯挡住再出现,仍应保持原来的毛色、体形和围巾。到了短剧里,这就变成演员换了角度和场景,观众还能认出是同一个人。
第二道关,是动作连贯。抬脚、迈步、落地是一段连续过程。单帧看起来正常,并不能保证连起来就自然;镜头一运动,还要同时处理背景透视、遮挡和人物位置。
第三道关,是物理与因果。手推了一下球,球该向哪里滚?物体被桌面挡住后,位置是否还接得上?模型可以学到很多运动模式,但画面再逼真,也不代表每次生成都能符合这些约束。
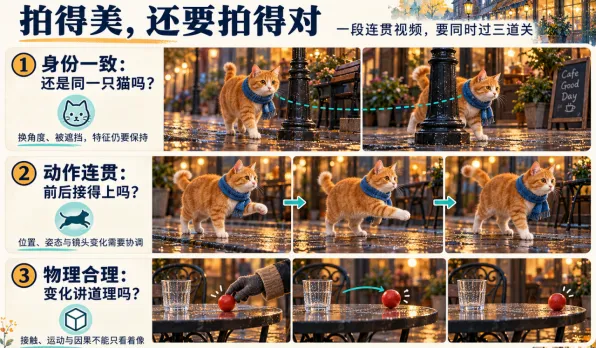
图3 连续视频需要同时满足的三类约束
所以,评估一段AI视频,光问“好不好看”还不够。VBench-2.0将人物表现、可控性、物理和常识等纳入评测,提醒我们关注漂亮画面之下的可靠性[7]。
故事一长,需要维持的关系也就多了。一个镜头里没看出的错误,到了下一个镜头,可能就藏不住了:先前放下的杯子去了哪里?人物离开时穿的外套,回来时怎么变了?这些都得把前后镜头对起来检查。
四、让AI“听懂导演”,要多给它一些线索
要少一点不确定性,可以先给AI更具体的参考。
仅写“橘猫在街上走”,模型有很大的发挥空间;再提供角色参考图、场景图,或者规定起始画面,就能把部分外观和构图固定下来。图生视频做的就是这件事:先用图像给出条件,再生成后续的变化[5]。
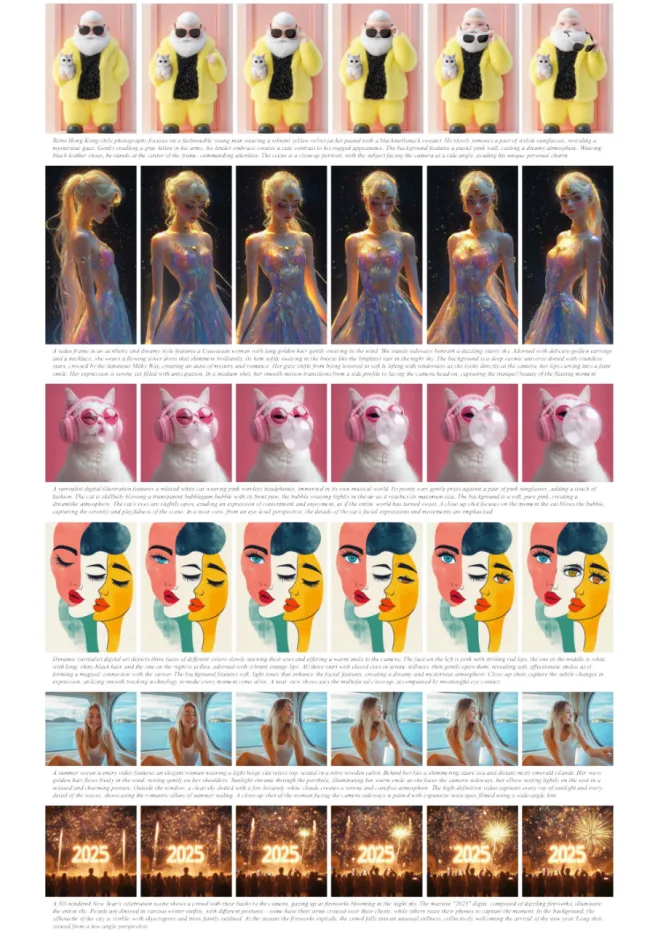
图4 Wan团队2025年技术报告中的图生视频连续帧展示
近期产品也在强化这类控制。快手官方介绍,10月15日上线的Kling 4.0支持最长30秒单次原生生成,以及多参考素材和多关键帧输入[8];字节跳动的Seedance 2.5同样强调参考控制与编辑能力[9]。这些功能回应的是创作者的同一个愿望:让镜头按自己事先的设计来生成。
但参考素材也有管不到的地方。一张角色图能约束外观,却不会自动解释整段剧情;指定首尾画面,也不能保证中间每个动作都正确。条件给得越清楚,就越有利于减少歧义。但生成之后,仍得检查。
写提示词时,不妨把它当成一份小型拍摄说明:“固定镜头,蓝围巾橘猫从画面左侧缓慢走向右侧,在窗前停下。”把主体、动作、方向和镜头交代清楚,比堆叠“震撼、电影感、超精细”更便于表达要求。一次先完成一个清楚的动作,也更容易看出问题出在哪里。
五、门槛降低了,创作者还要做什么?
真要动手做一段30秒的小故事,可以先把它拆成几个镜头:橘猫走进街道,停在窗前,抬头望向灯光。先确定角色和场景,再生成各个片段,挑选可用素材,处理衔接、声音与节奏。
创作者需要判断:哪一个眼神值得保留?什么时候切近景?停顿多久,观众才能感受到犹豫?这些选择,最终决定一组画面能否成为一个故事。
要算制作效率,这些劳动也得算进去。不能只看生成一次用了多久,还得看反复尝试、修正穿帮和完成后期花了多少工夫。这些同样是作品的真实成本。
AI视频让更多人有机会把脑海里的场景呈现出来。下一次刷到惊艳的片段,不妨多看几秒:人物前后是否一致,动作有没有来由,镜头之间是否真的传递了情绪。
那只雨夜里的橘猫为什么回头?这个问题,仍要由讲故事的人来回答。
参考资料
[1] 新华社. 财经慧说丨“不烧心”火了,今天我们聊聊AI短剧[EB/OL]. 新华网,2026-10-14[2026-10-19]. https://www.news.cn/20261014/8b47c44951cc45c7b69770a43a3f95a5/c.html.
[2]DataEye研究院. 9月AI剧漫剧百强榜:热度峰值创新高![EB/OL]. 中广互联,2026-10-12[2026-10-19]. https://www.tvoao.com/a/225290.aspx.
[3]卫中. 技术驱动+生态重构,AI真人漫剧正在起飞[EB/OL]. 新华网(转载自《文汇报》),2026-01-29[2026-10-19]. https://www1.xinhuanet.com/ent/20260129/b16bd6a58df8496e968588fcbc319e7d/c.html.
[4] HO J, SALIMANS T, GRITSENKO A, et al. Video Diffusion Models[EB/OL]. arXiv,2022-04-07[2026-10-19]. https://arxiv.org/abs/2204.03458.
[5]Team Wan. Wan: Open and Advanced Large-Scale Video Generative Models[EB/OL]. arXiv,2025-03-26[2026-10-19]. https://arxiv.org/abs/2503.20314.
[6]YANG Z, TENG J, ZHENG W, et al. CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer[EB/OL]. arXiv,2024-08-12[2026-10-19]. https://arxiv.org/abs/2408.06072.
[7]ZHENG D, HUANG Z, LIU H, et al. VBench-2.0: Advancing Video Generation Benchmark Suite for Intrinsic Faithfulness[EB/OL]. arXiv,2025-03-27[2026-10-19]. https://arxiv.org/abs/2503.21755.
[8] Kuaishou Technology. Kling AI Officially Launches Next-Generation Kling 4.0, Raising the Bar for Professional-Grade Video Models[EB/OL]. Kuaishou Technology,2026-10-17[2026-10-19]. https://ir.kuaishou.com/news-releases/news-release-details/kling-ai-officially-launches-next-generation-kling-40-raising.
[9] ByteDance Seed. One-take Creation, Flexible Referencing: Introducing Seedance 2.5[EB/OL]. ByteDance Seed,2026-07-31[2026-10-19]. https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5.
蔡远江,重庆大学无线通信技术实验室硕士生,主研智能信号与信息处理。
点个在看,你最好看!

