AI短剧角色像面瘫,因为你只写了生气
- 2026-11-14 17:59:06
最近比较忙。公司的 AI 项目压着,自己的兴趣短剧项目也开始有条不紊的进行着,周末才有空坐下。某果那边确实火。规矩立住,才不烧心。规矩要是只写在剧情上,脸上还是会穿帮。 |
公开报道里,「不烧心」从一部摊贩题材的 AI 短剧里跑出来,抖音话题播放到了几十亿。红果热播榜前十,过半数是 AI 剧,好多还带着第四季、第九季。这话好用。规矩要是只写在剧情上,脸上还是会穿帮。
今天就聊短剧这边我自己在用的一套方法。不是教你怎么追上热榜。是教你怎么让一张脸开始演戏。简单说,就是把情绪翻译成脸上能看见的零件。就像调音,你不能只写「这段要悲伤」,得告诉模型哪根弦在抖。
01画质过了,尴尬全在脸上
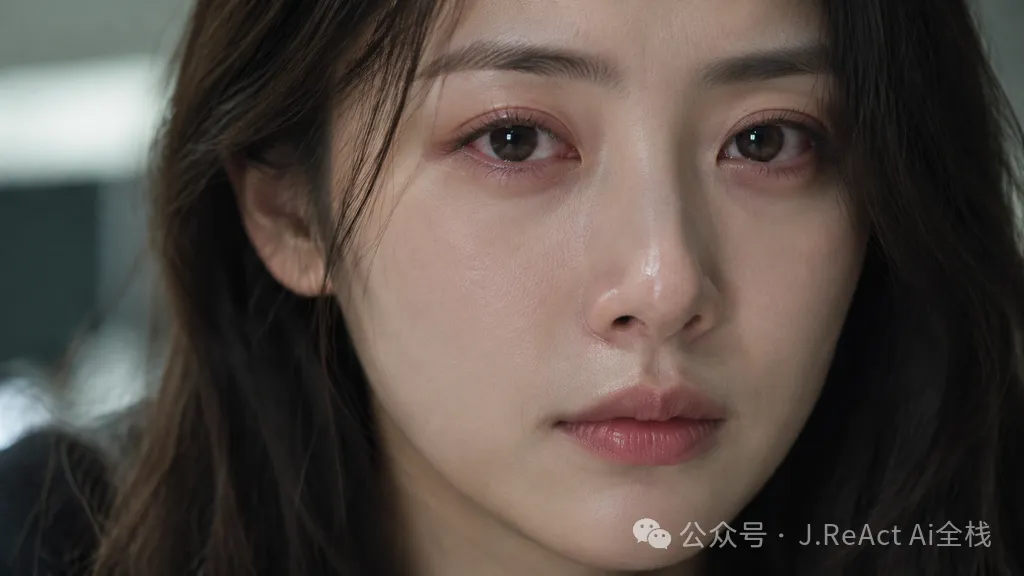
我最近集中看了一批 AI 短剧,几十部,头部团队和个人小号都有。画质这一关,早就过了。4K、电影级、超写实 3D,随便一个模型都能给你。有些片子的构图和调色,放到真人剧里也不丢人。
但问题全在脸上。人物在哭,你看着想笑。人物在发怒,像在憋喷嚏。人物在崩溃,那张脸平静得像刚做完医美。一部片子看下来,剧情我记住了,脸我一张都没记住。
意外就在这儿。我一开始也觉得是模型不行。后来对着同一句提示词改了几轮,才发现:你写「她很伤心」,模型收到的是一个标签。标签后面有无数种可能,嚎啕、默默流泪、强忍、麻木。它只能随机挑一个。训练数据里「伤心」的平均值,往往就是一张僵硬的哭脸。
这是我研究下来的第一个共性。情绪是贴上去的,不是长出来的。核心能力其实很窄。模型会改像素。它不会替你决定,这场戏到底是忍住,还是崩掉。
公开数据也能侧面说明产能已经不是瓶颈。2026 年 10 月 21 日的报道写过,上半年新上线短剧大约 22.19 万部,播放破亿的大约 1055 部。红果当天热播榜前十,6 席是 AI 剧。片子多了,脸却还是同一张平均哭脸。评测画质没有意义。评测一张特写能不能停三秒,才有意义。
02大词是标签,零件才是指令
真正卡住所有人的,是同一句话。不要只写「生气」「难过」这种大词。模型只会给你一张僵硬表情脸。
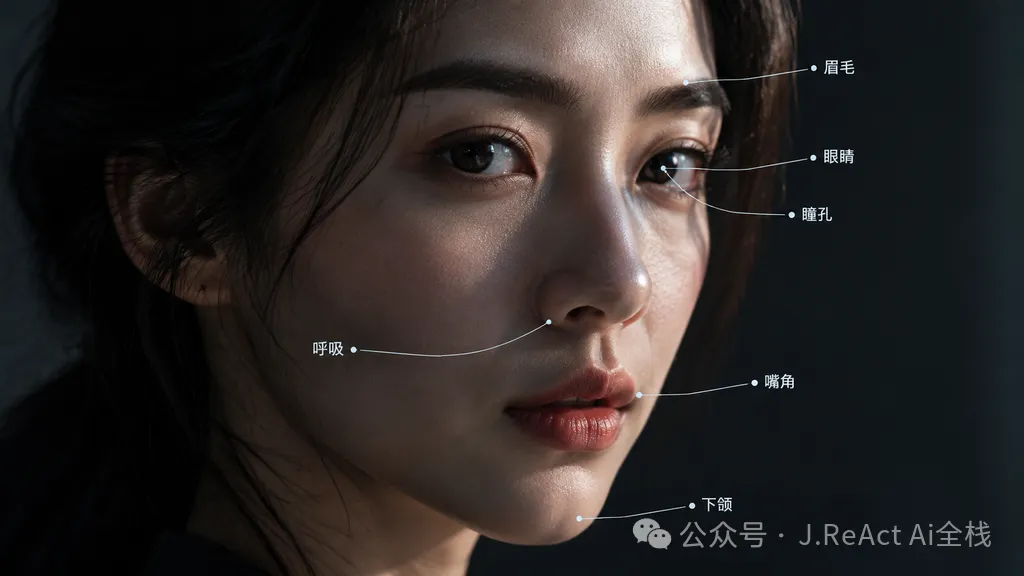
那写什么?我的结论是:把任何情绪拆成 6 个物理维度,再加 1 层光影。
眉毛看眉心、眉尾、眉峰,是锁紧、轻蹙、轻扬,还是压低。眼神看视线方向和聚焦程度,直视、垂视、游移、放空。瞳孔看放大、收紧、轻颤、高光。嘴角看抿紧、下垂、单侧挑、微勾、颤动。面部张力看下颌绷不绷、鼻翼张不张、咬唇发不发白、肩颈松不松。呼吸节奏看压住、变浅、喉头起伏、肩膀轻颤。光影氛围看暗调侧光、眼周泛红、泪光折射。
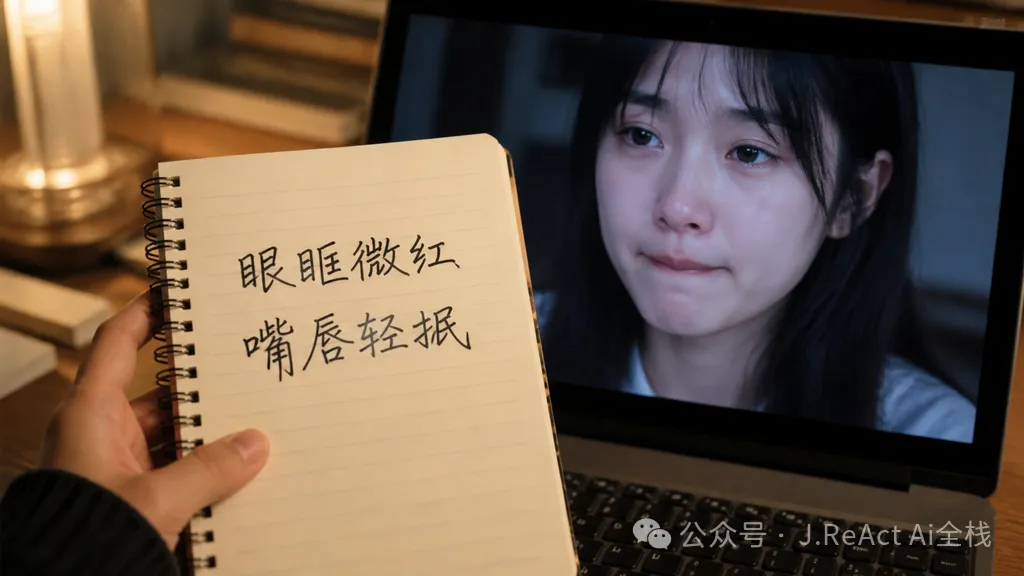
同一个「隐忍委屈」,旧写法是「她很委屈,想哭」。新写法是「眼眶微红、眼底含泪不掉、嘴唇轻抿、下颌微微绷紧、眉心轻蹙、情绪克制」。
差在哪?前者是她是什么状态。后者是她的脸此刻在发生什么。模型能吃的是后者。眼眶红了、泪没掉、嘴唇抿住了,每一个词都对应一块能看见的像素。
坦率讲,大词是给人看的标签。物理细节才是给模型的指令。公开资料里 MiniMax H3、Seedance 的写法也站在这边:只写「她感到紧张」,模型不知道往哪块肉上落。写成「内侧眉毛轻扬,双唇短暂紧闭,随后呼气放松下颌」,才有得演。
这就像给化妆师下单。你说「给我一个难过的妆」,对面只能猜。你说「眼周红一点,下唇咬白,泪先含住别掉」,对面才知道刷子往哪走。我测试了同一张基准脸,只改大词和只改零件,差得一眼能看出来。大词那张像表情贴纸。零件那张才像人还坐在场上。
03三段式,所有情绪都能套
我把这套规律收成一个固定结构。
先写表情名。再写 A:眼、眉、唇的生理细节。再写 B:张力、呼吸、微动作。最后写 C:3 到 5 个字的情绪定性词。
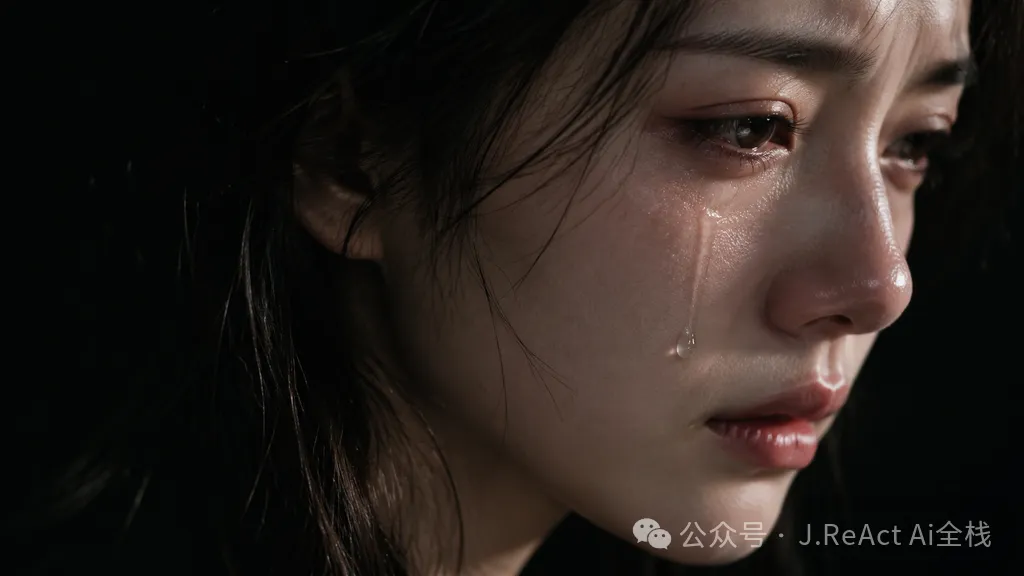
无声落泪可以写成:泪珠滑落,嘴角微垂,安静破碎。拆开看,泪珠滑落和嘴角微垂是 A。滑落这个慢动作里藏着 B。安静破碎是 C。
A 负责落地。C 负责定调。前面两个细节可能被渲染成悲伤、麻木、释然。最后这个词把它拉到你要的那个调上。安静破碎和压抑崩溃,是同一张泪脸,出来完全不一样。
怎么用很简单。也就是说,先选定这场戏要的一个表情名。再从脸上挑两处能看见的变化。再补一处呼吸或下颌。最后用四个字把味道钉死。一个镜头只套一次。不要在同一镜里又哭又怒又释然,模型会把三张脸叠在一起。相当于一次只给演员一个动作,别让他同时哭、笑、回头。
场景换了,公式不变。对话戏、哭戏、对峙戏,都是先零件,后定性。
04先抄几条能用的脸
词表我按情绪归了四组,一共 36 条(有需要后台可以私信我)。这里不把表全贴出来,先抄最常用的,实际做分镜时够用。
哭戏里,强忍泪水写成:眼眶湿润,呼吸压住,泪意不落。无声落泪写成:泪珠滑落,嘴角微垂,安静破碎。咬唇忍哭写成:下唇发白,眼底蓄泪,克制委屈。哽咽忍哭写成:喉头起伏,嘴角颤动,情绪堵住。崩溃大哭才用:张嘴痛哭,泪崩失控,情绪炸裂。喜极而泣是:含泪带笑,眼底发亮,情绪反差。抽泣是:肩膀轻颤,鼻尖泛红,情绪断续。哭完还有余韵:泪痕未干,神情放空,疲惫松弛。
冲突里,震惊错愕是瞳孔放大,嘴唇微张,停顿感。紧张不安是眼神游移,呼吸变浅,唇线绷紧。恐惧后退是眉心聚拢,鼻翼轻张,惊恐感。怒目而视是瞳孔收紧,眉压眼冷,怒意外露。不屑嘲讽是单侧挑唇,斜眼冷笑,攻击感。隐忍痛苦是眼尾泛红,下颌绷紧,压抑疼痛。质问委屈是眼眶发热,嘴角颤动,怒中带伤。茫然失措是眼神放空,嘴唇微张,失神感。
冷感里,侧瞥、轻笑、挑眉、暗爽、清冷注视,靠的都是单侧和克制。隐忍心动写成:睫毛轻颤,回眸停顿,羞涩克制。释然放松写成:肩颈松弛,唇角微扬,如释重负。思念怅然写成:目光放空,眼底湿润,余韵绵长。愧疚自责写成:目光下垂,眉心轻蹙,情绪沉闷。
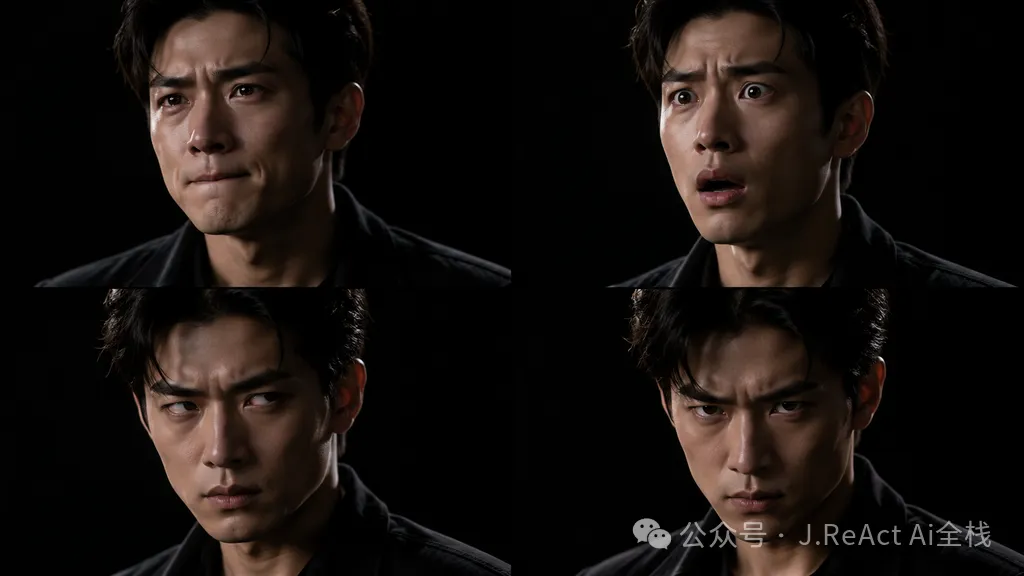
男性高张力我单独留了四条。克制愤怒:眉心锁紧,目光锐利,怒意压住。冷怒压迫:眼神低压,唇线收窄,气场逼人。爆发怒意:眼裂放大,鼻翼扩张,情绪失控。隐忍侧颜:侧脸特写,咬紧牙关,情绪压住。
这些句子短,是故意的。短才方便嵌进视频模型的时间轴。Seedance、H3 一类,一镜通常就几秒到十几秒。你塞一篇小作文,它会抓不住该动哪块肉。
我试了把崩溃大哭的词塞进近景对话,嘴一张,五官就漂。后来改成咬唇忍哭,脸还在,戏反而够。不是词越狠越好。是这场戏的镜头够不够近,零件够不够少。应用场景很具体:远景写动作,近景写零件,特写只留两处变化。混在一起,模型会两项都做一半。
05比脸更狠的,是微反馈
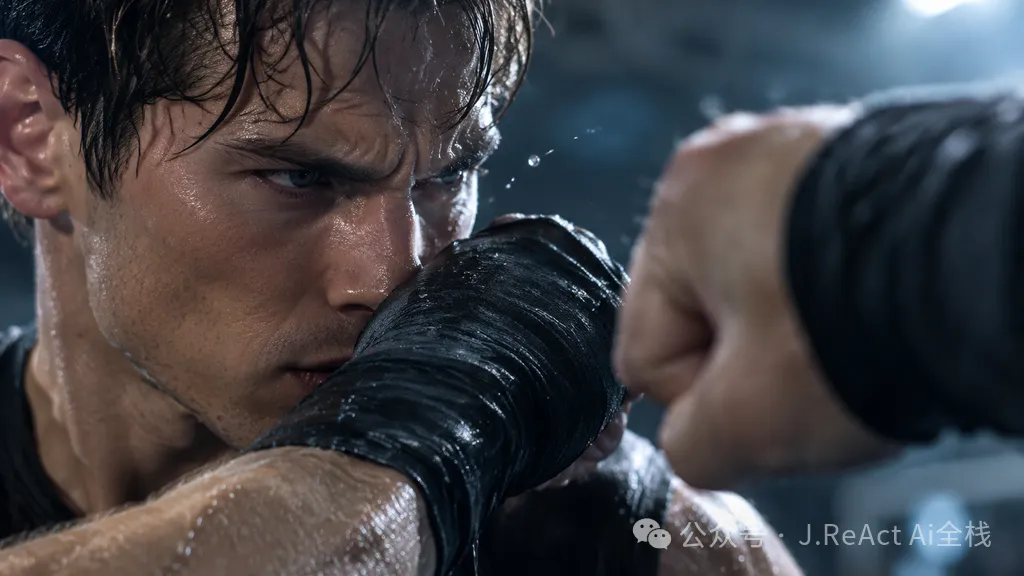
上面这套是脸的功夫。我折腾下来发现,还有一层更狠,叫微反馈,也就是身体层面的微动作。远景看不见。近景特写里杀伤力极大。
别写「他被打了」。写他身体的哪个部分、以什么方式、做了什么反应。格挡时手臂因冲击微颤,拳头停在对方眼前一寸,力量才看得见。连击中汗珠从额头或发梢甩出,速度才看得见。格挡被重击弹开,手臂向两侧甩出,才是挡不住了。重击命中,血雾从嘴角喷出,近景才有终结感。
攻方也可以拆。冷静压制:眼神如刀、面无表情、嘴角微抿。暴怒狂攻:咬牙切齿、瞳孔收缩、额头青筋。从容拆招:眼皮微抬、嘴角微扬、呼吸平稳。绝境反击:眼底寒光一闪,表情从痛苦转到坚定。
守方被重击:瞳孔骤缩、嘴角血线、眼球震颤。被连击压制:额头冷汗、呼吸急促、眉头紧锁。被化劲:眼中闪过一丝错愕,再瞬间理解对方意图。
注意最后这类。表情从痛苦到坚定,从错愕到理解。这是变化,不是状态。观众的眼睛天生追变化。这是我看那些片子的第二个共性。大部分 AI 短剧只有状态,没有变化。一个表情从头挂到尾,三秒就腻了。
公开指南里也有类似判断。一张静帧,写此刻脸上是什么。一段图生视频,写表情怎么从 A 走到 B。用途不一样,写法不能混。
06先把脸锁住,再一组组跑
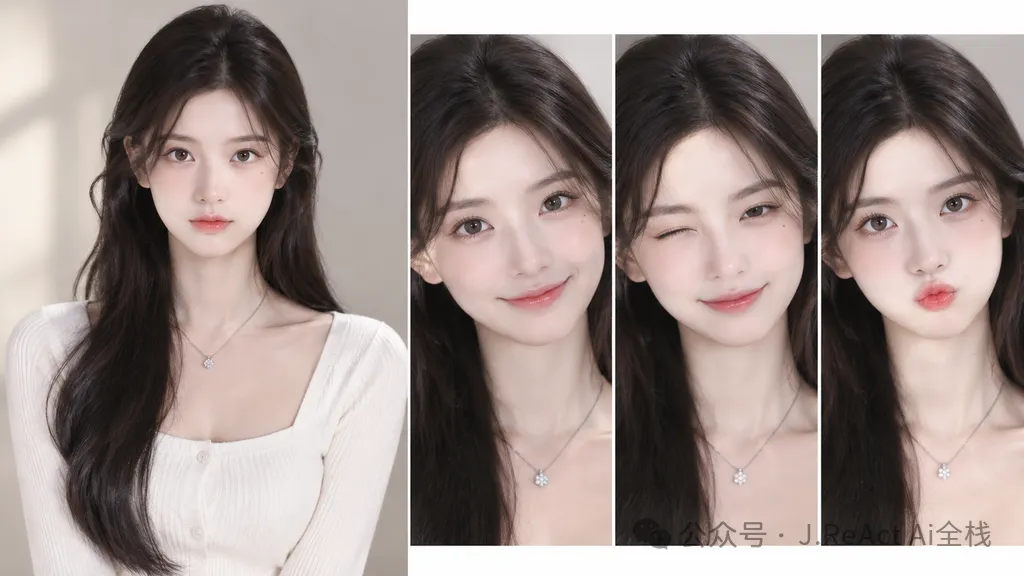
研究完之后我自己跑了一轮验证。步骤不复杂,少一步就会漂。
第一步,锁脸。先确定五官、发型、肤色、画风,生成一张基准图。定妆照尽量中性,不要一上来就哭天抢地。戏剧光会污染后面每一镜。
第二步,锁风格。光线、背景、色调、镜头焦段写死。微表情必须近,面部占画面大半。侧光比正面平光有用。平光会把眼周那一点红吃掉。
第三步,批量跑情绪。拿基准图当参考图,一组一组跑,每次只换表情提示词。不要每次重写长相。
第四步,按基础、高张力、哭戏、冷感、心动五类归档。后面做对话戏、哭戏、冲突戏,从库里调。
第五步,分镜复用。短剧不是一张图,是几百个镜头。你每次重新生成,人物的脸都会漂。锁脸加素材库,是在解决一致性。那些出问题的片子,我看下来有一半死在这儿。同一场戏,人物的脸换了三个版本。
行业里现在也把这事写成工程。先定身份,再锁参考,再扇出镜头。提示词里不再描写她长什么样,只写这一镜怎么动。我自己的感受是:表情库是表演层,定妆照是身份证。两张混用,戏会花,人也会花。
成本上也说得通。视频比图贵。先在静帧上把 36 条跑通,再送进视频模型,废镜头会少很多。免费模型也能跑静帧。贵的是一次次重抽已经进了时间轴的脸。行业里有个不算官方基准、但很多人认的经验:大约三成角色图或镜头要重跑一遍,才能把漂移压到能看。把重跑写进流程,比把一次失败当成整条线报废,便宜得多。
我自己也还在这条线上改。锁脸那张图,我至少重抽过一轮,因为第一张带了太重的侧光,后面每张都像在同一盏灯下哭。定妆照要平一点,戏里的光再狠。两件事反着来,脸会跟着灯走丢。
07还有两块,市面上没人系统做
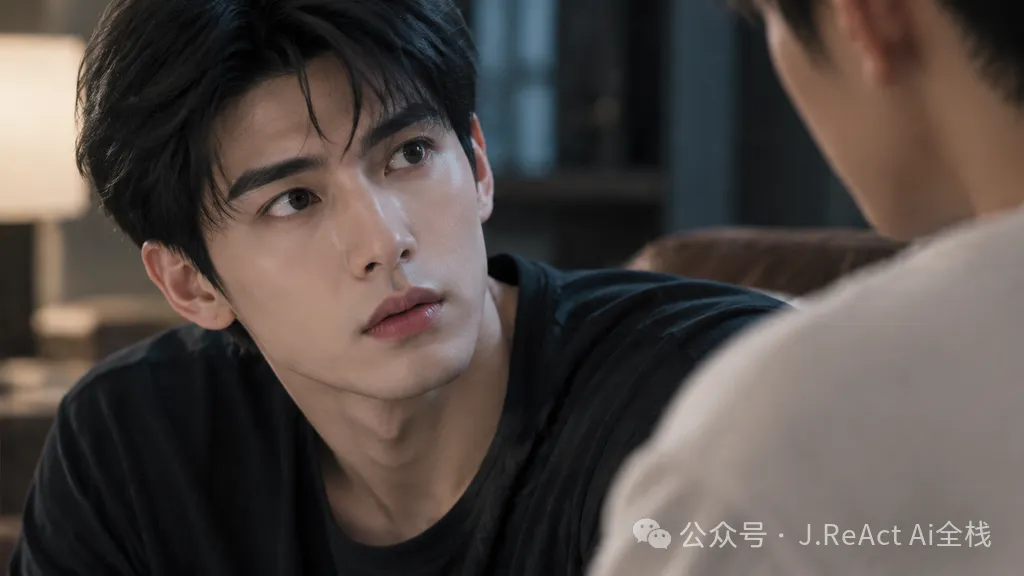
这套方法已经能解决大部分问题。我看下来,还有两块没人系统做。
一块是动作微表情。现在所有人都在做脸的静止状态。真正的表演是动态的。走路时的一个回头,坐下时的一个停顿,递东西时手指的犹豫,转身前肩膀先动的那一下。这些才是短剧里有戏的地方。这部分几乎没有成体系的提示词库。你想想看,真人演员递杯子都会停半拍。模型只会「把杯子递出去」。差的就是那半拍。
另一块是对话反应镜头。短剧里大半镜头不是说话的人,是听的人。听的时候眼睛往哪飘,嘴角压不压,呼吸有没有变,决定这场戏成不成。同样,没人做成库。我担心的用法是:只给说话的人特写,听的人整场面瘫。观众会觉得这场对话是配音,不是两个人在场上。
局限也很清楚。词表解决的是单镜可读。它不保证换镜头不换脸,也不保证口型跟得上。动态微表情和听的人,还得靠你自己补时间轴。谁先把这两块做成库,谁就拿到下一波。我现在也只是把脸和微反馈立住(hhh),后面两块还在摸。
08你不是导演,也可以先改三个词
普通人转发一条 AI 短剧,实际只用得到三问。这张脸在演戏吗。隔着手机,眼眶和嘴角还认得出变化吗。同一场戏,人还是同一个人吗。三问不过,就当草稿。
对做片子的人,影响更硬。以前我会把「模型出图了」当成这场戏成立。现在成立的标准改成:记事本上的情绪词,和脸上正在发生的零件,是同一份。少发一张面瘫特写,评论区就少一排「这谁啊」。意义不在炫技。是让看的人少猜一次「她到底气没气」。
英文模板可以直接抄。给 gpt-image、Seedream、Nano Banana 都能用。骨架是特写、侧光、黑底,再把你的三段式塞进去。中文情绪词现在够用。你不会写英文,就把「眼眶湿润,呼吸压住,泪意不落」直接贴进去。
Close-up portrait, ultra-realistic 3D CG render, cinematic low-key side lighting, pure black background, cool desaturated grade, subtle red flush around the eyes, wet tear highlights on the lower lash line. Expression: 眼眶湿润,呼吸压住,泪意不落. Micro-details: trembling lower lip, jaw slightly clenched, shallow breathing, gaze fixed. No watermark, no text.回到最开始。为什么你的 AI 角色像面瘫?因为你在跟模型说结果,模型需要的是过程。伤心是结果。眼眶红了、泪没掉、嘴唇抿住了,是过程。愤怒是结果。眉心锁紧、下颌绷紧、呼吸压住,是过程。
AI 不懂情绪。AI 只懂像素。你得把情绪翻译成像素。这句话想明白了,片子里的每一张脸,才会开始演戏。
规矩立住,才不烧心。脸上的规矩,也一样。
感谢你的时间。点赞、关注、转发 随便来一个,都是对我继续写下去的支持 🙂,需要推送提醒,星标 ⭐ 一下就好。下篇我们继续聊

