AI短剧制作有新工具了!这个开源项目把剧本、分镜和视频生成串了起来
- 2026-11-18 23:23:39
如果你用 AI 拼过短剧,这几个画面大概率不陌生:
第 3 个镜头,主角还是圆脸;第 8 个镜头,变成了尖下巴。剧本手动拆成 20 段,拆了一下午。生成的素材散在几个文件夹里,哪个镜头用了哪张图,早就对不上。
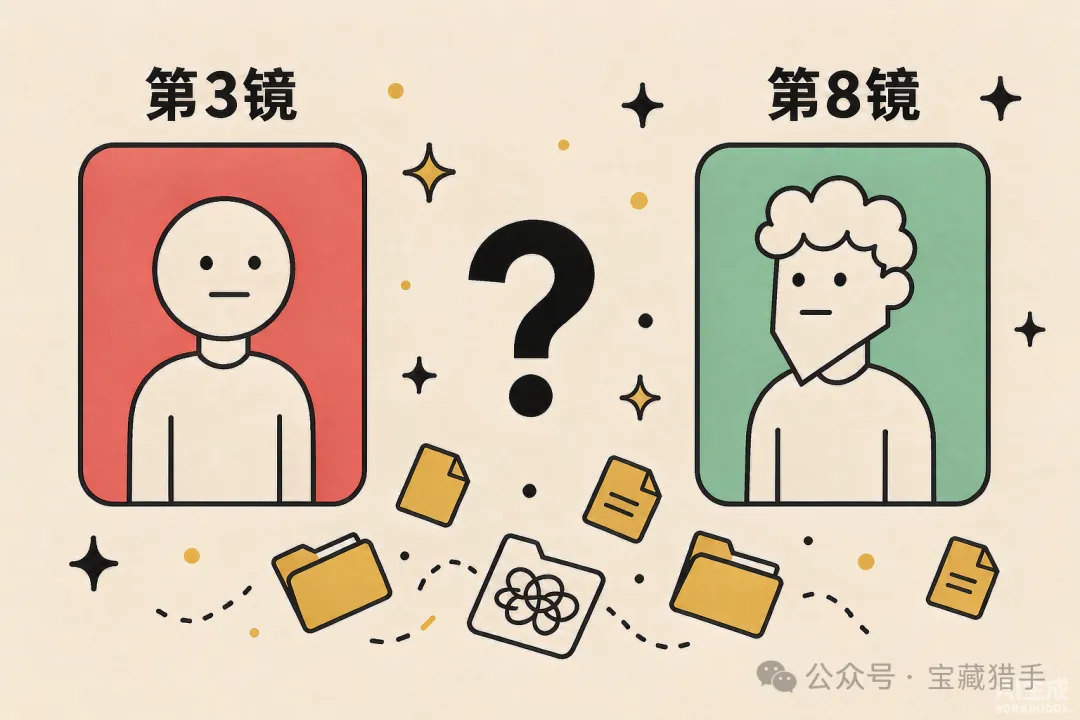
一、门槛变了:单点生成已普及,难的是组织
生成一张图、一段视频,今天确实不算难事。
真正耗时间的是「生成之前」和「生成之后」:剧本怎么拆成镜头,角色怎么保证不换脸,素材怎么复用,几十个生成任务怎么追进度。工具能力越强,组织成本反而越高——这是 AI 短剧从「玩一条」到「做一部」的真实分水岭。
今天聊的开源项目 Jellyfish,瞄准的就是这一段。
二、Jellyfish 是什么
Jellyfish 是 Forget-C 开发的开源项目,Apache-2.0 协议,定位是「AI 短剧端到端生产工作台」。从剧本输入,到结构化分镜、一致性管理、镜头准备、视频生成和导出,整条流程它都想管起来。
项目地址:https://github.com/Forget-C/Jellyfish
几个部署层面的关键信息:
• 前后端分离架构,官方提供 Docker Compose 一键部署方案,前端跑在 7788 端口,后端 8000 端口,配套 MySQL、Redis 和 RustFS 存储 • 仓库带中文文档,部署配置和环境变量示例都给了 • 后端用 Python(uv 管理),前端 pnpm,接口走 OpenAPI 契约
一句话理解:它把短剧制作的流程装进了一个工作台,而不是又一个「AI 视频生成器」。生成能力可以接你自己的模型渠道,它负责的是流程。
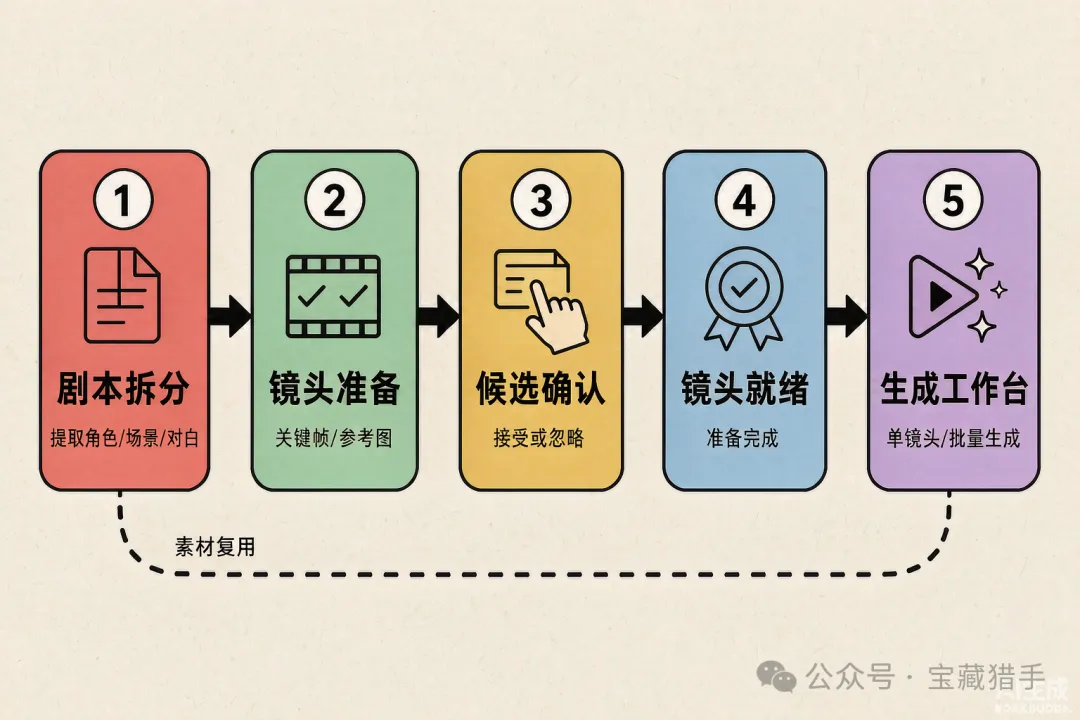
它的主线工作流是这样的:
三、它具体解决哪些麻烦
1. 剧本自动拆分镜,顺手做结构化提取
把章节剧本拆成镜头,顺手提取角色、场景、道具、服装和对白;剧本优化、简化、一致性检查,也带着做了。
2. 角色、场景、道具、服装统一管理,镜头级复用
系统维护一套共享实体库,角色/演员、场景、道具、服装可以在不同镜头之间关联、复用,重名时还会提醒你先用已有的。
它是「管理机制」,不能保证 AI 生成结果百分之百一致。但它把「每次生成都从头描述角色」这个最大的穿帮根源,变成了「有库可查、有资产可挂」。对连续剧情的项目,这是质变。
3. 「镜头就绪制」工作流
主线流程设计得清楚:剧本拆分 → 镜头准备 → 候选确认 → 镜头就绪 → 生成。系统明确区分「这个镜头准备好了」和「这个镜头正在生成」,没准备好的镜头不让你浪费算力。这个「确认流」是它和普通生成器最大的区别——把生产流程当流程管,不当对话框管。
4. 统一任务中心
文本、图片、视频生成,走的是同一套异步任务系统:状态、进度、耗时一目了然,能取消,还能从任务记录直接跳回对应的项目、章节、镜头。
批量生产时这是刚需。生成 30 条视频的等待时间里,你需要知道哪条卡住了、哪条失败了,而不是翻聊天记录。
5. 多模型与提示词管理
多个模型供应商可以接,默认模型按类别设,提示词模板和生成文件也统一管。
它试图解决的是「配置层」的问题:模型渠道、提示词风格,都能在系统里沉淀下来,不用每次重来。
四、对比:零散工具流 vs 一体化工作台
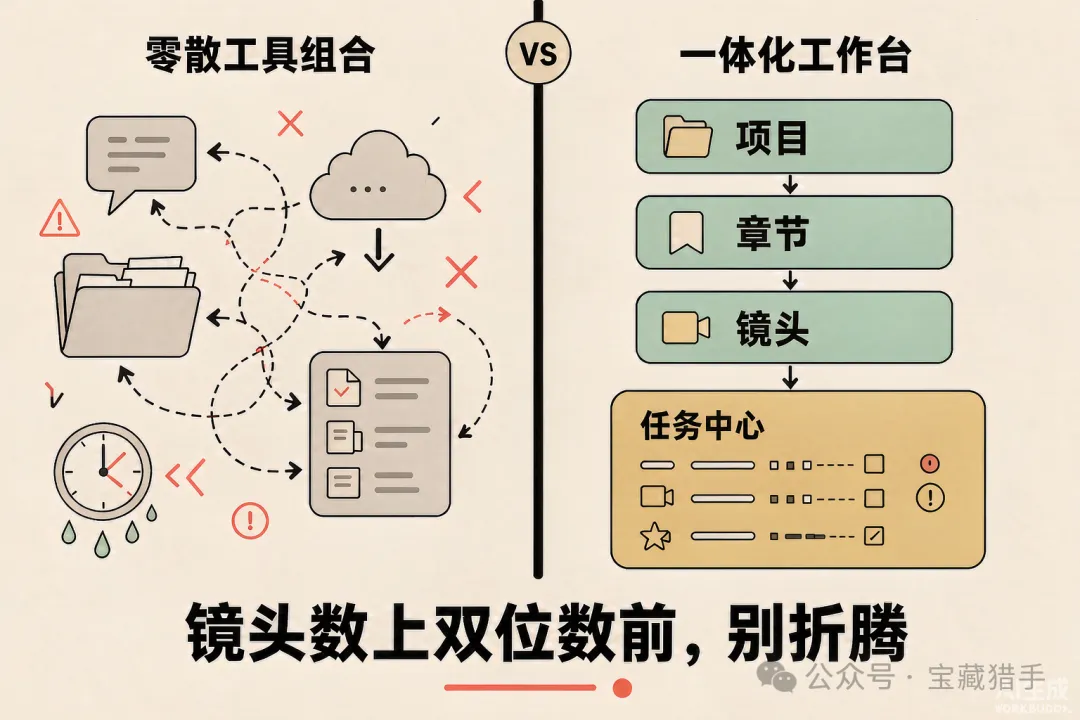
判断标准很直接:只做单条 15 秒视频,零散工具更轻,别折腾;一旦镜头数上双位数,或者要批量生产,工作台的时间优势才开始碾压。
五、适合谁,不适合谁
适合关注的三类人:
• AI 短剧创作者:正在做连续剧情,被角色穿帮和素材管理反复折磨的 • AI 视频工作室:批量生产内容,项目管理、素材复用、任务追踪比单条效果更重要的 • 开发者:想研究 AI 内容生产系统怎么搭的——前后端分离加 OpenAPI 契约,代码结构值得读
劝退名单:
• 不想碰部署的人:Docker Compose 起步,背后是一整套服务(MySQL、Redis、RustFS),不是双击安装包 • 零 API 预算的人:生成环节仍然走模型 API,费用按使用量算,它不是「免费无限生成」工具 • 追求开箱即用的人:请先读官方中文文档,再决定要不要投入一个周末
六、最后
AI 视频生成能力还会继续变强,单次生成会越来越不是门槛。
把大量生成结果组织成一部稳定完成的作品,会是下一个真问题。Jellyfish 不见得是终极答案,不过它把这个问题认认真真摆到了台面上。就冲这个,值得放进观察名单。

