短剧教程第五篇:AI短剧完整制作流程复盘——从剧本到成片,一次把流程跑通
- 2026-11-18 12:36:25
六步拆解完整制作流程,每个环节都附上可直接使用的提示词和实操思路。
你好,我是佳佳。
前面四篇,我们陆续聊过角色面板、16视图、分镜脚本、场景一致性,还有武打动作拆解。
这几个环节单独拿出来看,其实都不算太难。只要熟悉工具,跟着提示词操作,基本都能做出想要的效果。
如果你一路跟着做下来,手里应该已经有了一套比较完整的素材:
人物不容易变脸:通过角色面板和16视图,固定人物的外貌、服装和整体形象。
场景不容易穿帮:利用场景锚点,让不同镜头里的环境和道具尽量保持一致。
动作更有连贯性:通过动作拆解故事板,把人物的动作和镜头节奏提前规划好。
但最近有不少朋友跟我说了一个挺真实的问题:
“佳佳,单独做每个环节我都能跟着完成,可真要从头做一部完整的 AI 短剧,还是不知道该从哪里开始,前后怎么衔接。”
其实我刚开始做的时候,也经常卡在流程衔接上:剧本写好了,不知道怎么做角色;角色做好了,分镜又接不上;到了视频生成,人物和画面还容易跑偏。
后来才发现,难点不在工具,而在于没有一套完整 的制作流程。
六步制作流程总览
整套流程的核心思路:
先把人物定下来,再固定场景;先规划好镜头,再生成视频。不要每到一个环节才临时想下一步怎么做。
前面的素材准备得越充分,后面的生成和剪辑就越省事。这样才算真正把 AI 漫剧制作流程跑通。
第一步:从剧本提取人物形象,生成角色面板
输入:
你写好的剧本(哪怕现在只有人物设定、剧情片段,甚至只是一个大概的人设草稿也可以)
操作:
把你的剧本内容丢给DeepSeek / Kimi,让它先帮你把角色信息整理出来。
这一步的目标,不是立刻出图,而是先把人物的外貌、穿搭、气质这些核心信息提炼清楚,方便后面继续做角色定妆和16视图。
可直接复制的提示词
请根据以下剧本内容,提取主要角色的人物形象信息,并整理成一份可直接用于AI生图的角色面板。
剧本内容:
[粘贴你的剧本]
输出要求:
外貌特征:
脸型、肤色、眼睛(颜色/形状)、鼻子、嘴唇、发型(颜色/长度/卷直/刘海)、身高体型、标志性特征(如泪痣、雀斑、伤疤、纹身等)
服装风格:日常穿搭风格,尽量写清楚款式、颜色、材质和配饰
气质神态:整体给人的感觉、人物气场、常见表情、说话或看人的状态
年龄和身份标签:年龄区间、职业/身份、人物关键词标签
输出格式:
按照以上分类逐项输出,每项都要具体,不要只写笼统词。最后请整理出一段完整的“角色描述汇总”,要求语言流畅、细节完整,可直接复制用于AI生图。
输出示例(部分):
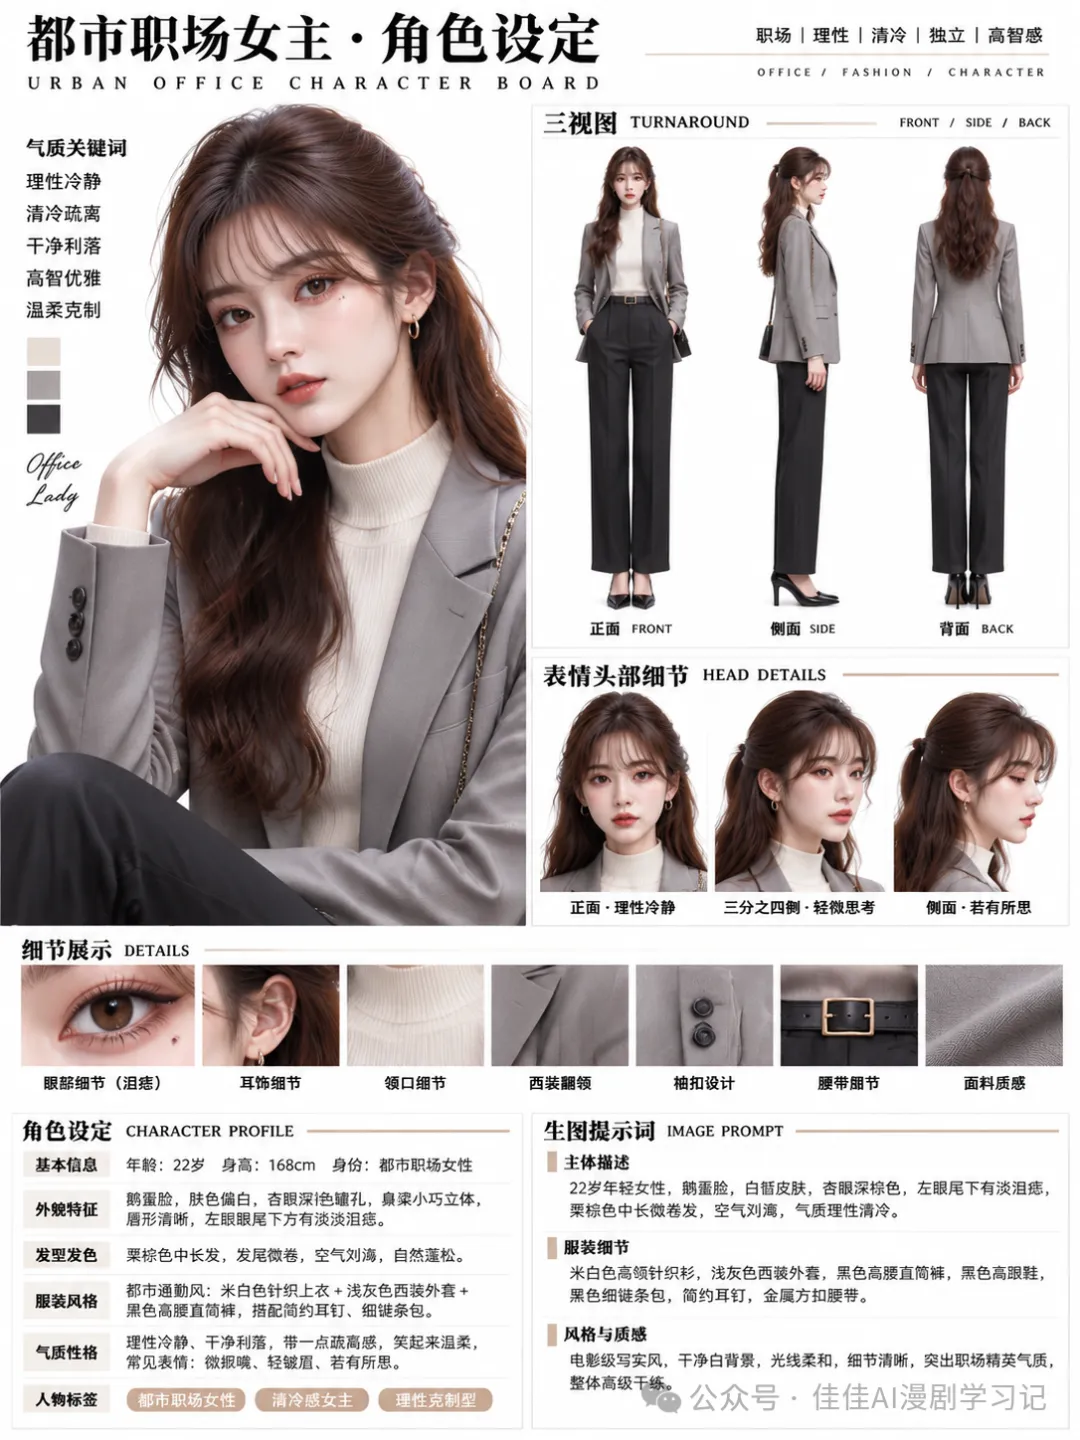
角色描述汇总:
22岁年轻女性,鹅蛋脸,肤色偏白,杏眼,深棕色瞳孔,鼻梁小巧立体,嘴唇偏薄,唇形清晰。栗棕色中长发,发尾微卷,空气刘海,整体发型自然蓬松。身形高挑偏瘦,气质干净利落,左眼眼尾下方有一颗很淡的泪痣。穿搭以都市通勤风为主,常穿米白色针织上衣、浅灰色西装外套、黑色高腰直筒裤,搭配简约耳钉和细链条包。整体气质理性冷静,带一点疏离感,但笑起来会显得很温柔,常见表情是微抿嘴、轻皱眉、若有所思。身份标签为:都市职场女性、清冷感女主、理性克制型人物。
第二步:根据角色面板生成定妆照
输入:第一步整理好的角色面板,尤其是最后生成的「角色描述汇总」。
操作:把角色描述复制到 GPT Image 2、通义万相或即梦 AI 中,让工具根据人物设定生成 4~8 张正面全身照,再从中挑选一张最符合预期的,作为后续制作的标准定妆照。
这一步不用急着追求复杂的动作和场景,先把人物的脸、发型、服装和整体气质确定下来。
可直接复制的提示词
针对 GPT Image 2:
根据以下人物设定,生成一张高质量的角色定妆照。
角色描述:[粘贴第一步整理好的角色描述汇总]
画面要求:
人物正面全身站姿,完整展示头部、身体和鞋子。
人物自然站立,双手放松,表情自然,目视镜头。
严格按照角色描述还原五官、脸型、发型、发色、服装和配饰。
背景使用纯浅灰色,采用柔和影棚布光。
画面清晰,人物细节完整,服装材质真实。
整体采用电影级柔光写实风格,避免过度磨皮和塑料质感。
不要额外添加设定中没有的眼镜、帽子或饰品。
画幅:竖版2:3。
针对通义万相 / 即梦 AI:
[粘贴角色描述汇总]
生成一张人物正面全身定妆照,保持人物自然站姿,表情平静,正视镜头。纯浅灰色背景,柔和影棚光线,高清写实质感,完整展示人物服装和鞋子,竖版2:3。
关键注意事项
多生成几张再挑选:建议一次生成4~8张,重点对比五官、发型和服装,选出最满意的一张。
确定标准定妆照:选定之后就不要频繁更换,后续16视图、故事板和视频生成都以它作为人物参考。
细节不满意就局部调整:比如发型、服装颜色不对,优先使用图生图或局部编辑修正,不要每次都重新生成整张图。
文件统一命名:建议保存为「角色名称_定妆照.png」,后续找参考图会方便很多。
这一环节最重要的是:先选定一张满意的定妆照。 后面所有人物视图和镜头画面,都尽量围绕这张图展开,避免角色越做越不像。
第三步:根据定妆照生成16视图
输入:第二步选好的角色定妆照。
操作:把定妆照上传到 GPT Image 2,直接使用下面的提示词,让它生成同一个角色的16种视图。
可直接复制的提示词
GPT Image 2(垫图模式):
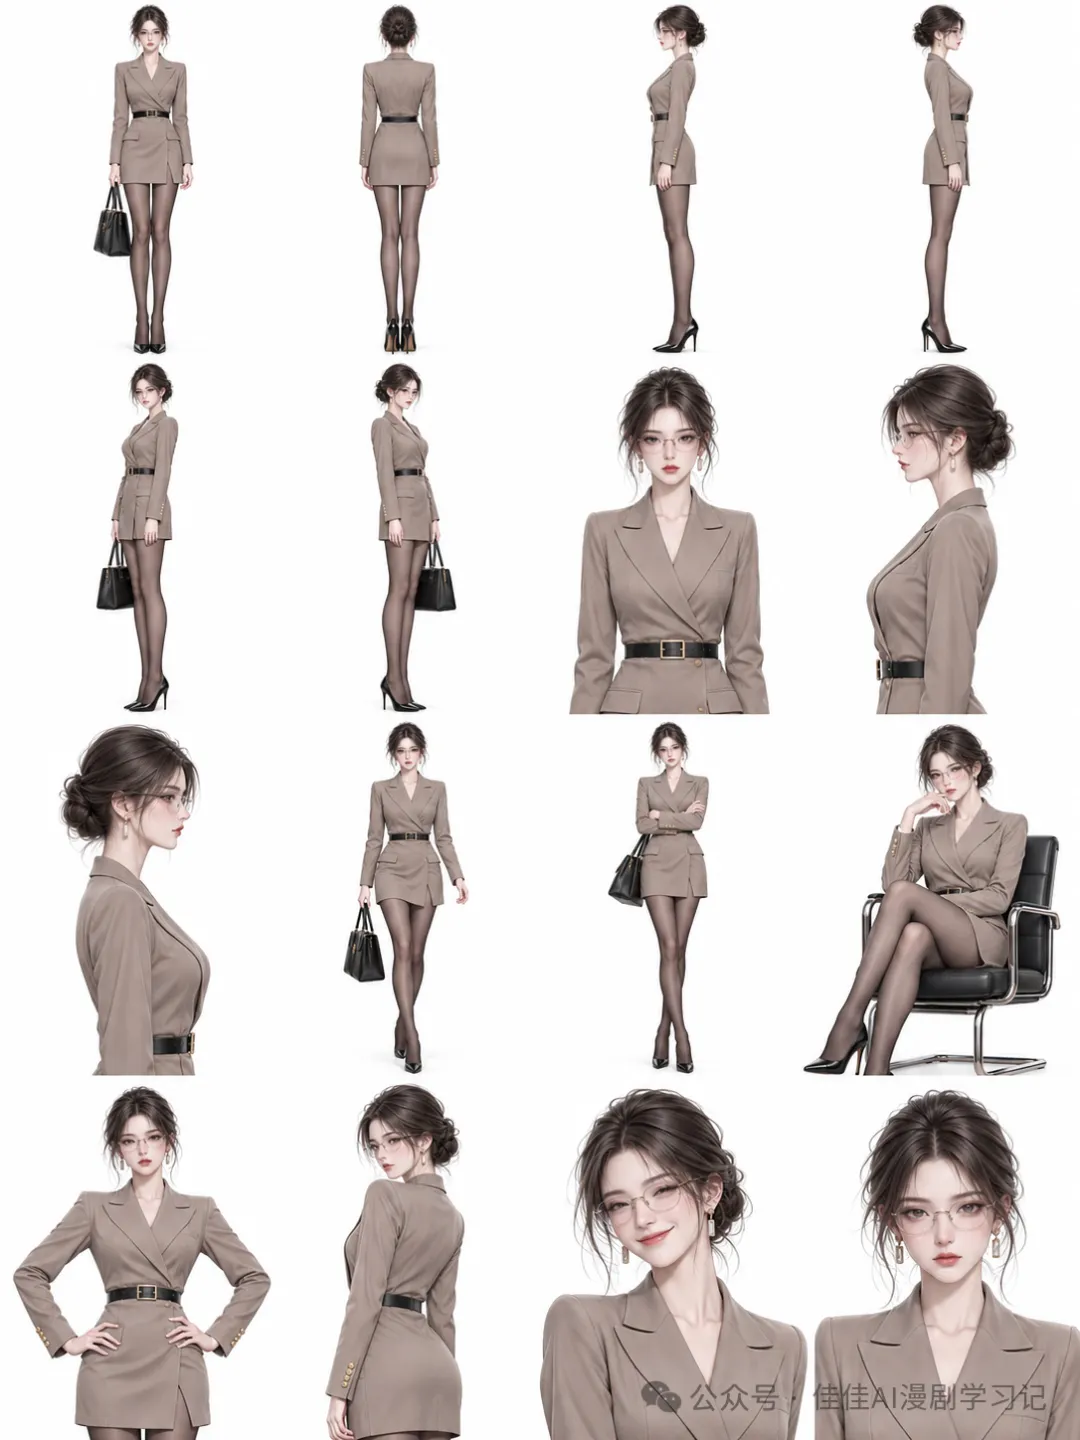
请根据上传的定妆照,生成同一个角色的16视图设定图。
视图内容:
正面全身、背面全身、左侧面、右侧面、左45°、右45°、正面半身、左侧面半身、右侧面半身、行走姿态、站立姿态、坐姿、双手叉腰、回头姿态、微笑表情、严肃表情。
画面要求:
16个视图必须是同一个人,五官、发型、发色、服装和配饰保持一致。
白色背景,16宫格整齐排列。
人物比例统一,全身视图不要裁切头部和鞋子。
表情自然,动作清晰,人物细节尽量还原定妆照。
不要水印、文字标注和多余装饰。
生成后检查
每个格子里的人物是不是同一张脸?
发型、发色有没有变化?
衣服和配饰是否保持一致?
泪痣等标志性特征有没有保留?
如果一次生成不理想:
不用反复重做整张图,可以分批生成:先做6个角度,再做5种姿态,最后补5种表情,完成后用 Canva 拼成16宫格。
第四步:根据剧本生成分镜故事板
输入:剧本全文 + 角色16视图(方便AI识别人物)。
操作:把剧本和角色参考图一起上传到 GPT Image 2,让它按照剧情生成一张12格分镜故事板。
可直接复制的提示词
请根据下面的剧本和人物参考图,帮我生成一张12格分镜故事板。
剧本内容:
[粘贴你的剧本,建议100~300字,包含人物、场景和对话]
角色参考:使用上传的16视图,人物外貌和服装保持一致。
场景设定:
[简单描述故事发生的地方,例如:深夜便利店、古风竹林、都市天台]
生成要求:
采用16:9横版画幅,12格排列。
每格对应一个独立镜头。
标注镜头类型和景别(远景、全景、中景、近景、特写)。
清楚展示人物的位置、动作、表情和周围环境。
按照剧情发展安排镜头,保证前后连贯。
采用黑白线稿分镜风格,画面简洁,重点突出人物和动作。
景别简单说明
远景:交代整个环境。
全景:展示人物全身和周围场景。
中景:主要展示人物上半身。
近景:突出人物面部和表情。
特写:突出眼睛、手部等细节。
第五步:根据分镜整理场景锚点卡和分镜图
输入:第四步生成的12格故事板。
操作:先从故事板里整理出场景的固定信息,生成场景锚点卡;再把12格分镜分别拆出来,保存成独立图片,方便后面生成视频时使用。
5.1 生成场景锚点卡
把故事板发给 DeepSeek / Kimi,让它帮你提取场景中需要固定的细节。
可直接复制的提示词:
请根据下面的故事板,整理出场景锚点卡,把每个场景的重要细节记录下来。
输出内容:
场景名称:给场景起一个容易识别的名字。
空间布局:描述门窗、桌椅、柜台等物品的位置。
固定道具:列出3~5个关键道具及摆放位置。
色彩和光线:记录场景的主色调和光源方向。
标志性细节:找出1~2个容易识别的小细节。
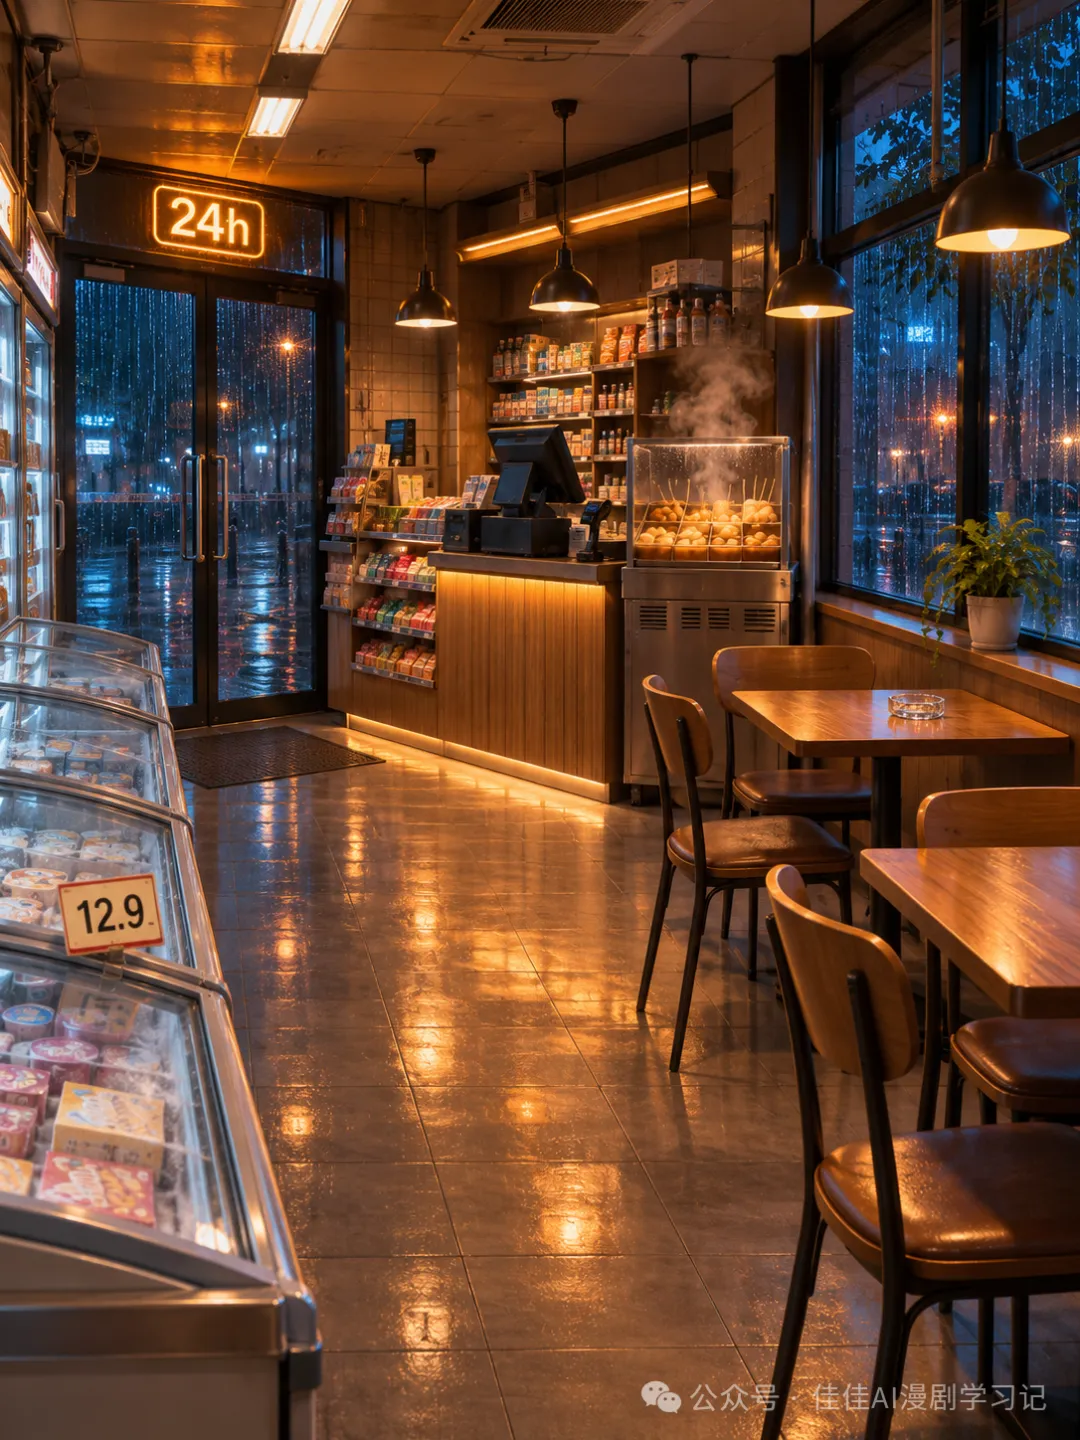
场景锚点卡示例:
场景名称:深夜便利店
空间布局:玻璃门在左侧,收银台在中间,冰柜靠左墙,靠窗座位在右侧。
固定道具:收银台旁边的关东煮机、冰柜上的12.9元价签、靠窗第二张桌子的烟灰缸。
色彩和光线:室内暖黄色灯光,窗外是冷蓝色雨夜。
标志性细节:门口的24h灯牌微微闪烁。
5.2 拆分分镜图
12格故事板生成后,还需要把每个镜头单独保存,方便后面逐个制作视频。
操作方法:
使用 GPT Image 2 等工具,按照原故事板逐格生成独立分镜图。
也可以用图片裁剪工具,把12格图片分别裁出来。
每张图片对应一个镜头,尽量保留原来的构图和人物动作。
文件命名:
建议统一命名为:场景名_镜头号.png
例如:便利店_镜头01.png、便利店_镜头02.png。
拆分后检查:
每张图的内容是否和原故事板一致?
人物外貌和服装是否与16视图一致?
场景布局和固定道具有没有发生变化?
这样整理好之后,后面生成视频就不用每次重新找图,也能减少人物和场景前后对不上的情况。
第六步:把故事板导入 Seedance 2.0,生成视频
输入:角色16视图 + 场景锚点卡 + 拆分好的分镜图。
操作:把前面准备好的素材上传到 Seedance 2.0,按照镜头顺序添加参考图,再输入运镜提示词生成视频。
Seedance 2.0 操作设置
需要上传的素材:
分镜图:按照镜头顺序上传,每张图对应一段视频。
角色参考:上传16视图中的正面图和侧面图,固定人物形象。
场景参考:上传对应的场景图,保证环境和道具一致。
模式选择:使用全能参考模式,可以同时添加多张参考图。
@图片用法:用 @ 标记每张图片的用途,避免AI弄混。
例如:@图片1-12作为分镜参考,@图片13作为角色参考,@图片14作为场景参考。
时长建议:每段视频控制在6~10秒,最长15秒。需要更长的内容,可以分段生成,最后再用剪映拼接。
运镜提示词模板(可直接复制)
根据上传的分镜图片,按照原来的剧情顺序生成一段连贯视频。
镜头运动要求:
镜头1(0-2秒):远景,镜头缓慢推进,交代场景环境。
镜头2(2-4秒):中景,轻微手持晃动,增加画面真实感。
镜头3(4-6秒):近景,镜头固定,突出人物表情。
镜头4(6-8秒):全景,快速横移,展示周围环境。
镜头5(8-10秒):特写,缓慢推进,突出画面细节。
镜头6(10-12秒):中景,镜头围绕人物做小幅度移动。
镜头7(12-14秒):远景,镜头缓慢拉远,展示完整场景。
生成注意事项:
人物五官、发型和服装尽量保持一致。
场景布局和固定道具不要随意变化。
人物动作要自然,避免突然变形或跳帧。
运镜幅度不要太大,尽量保证镜头衔接自然。
每段生成后先检查画面,再决定是否需要重新生成。
最后把生成的视频导入剪映,按照分镜顺序拼接,补上配音、字幕和背景音乐,一部完整的AI短剧就基本完成了。
核心约束
制作过程中,下面几个细节尽量不要忽略:
所有镜头的场景要保持一致,道具位置和整体色调不要随意变化。
人物的脸、发型和服装要与角色参考图保持一致。
镜头之间尽量自然衔接,不要突然切换。
整段视频要有连贯感,避免人物动作和画面跳变。
不要出现多余的文字、水印和LOGO。
关键参数
画质:选择 Standard 模式,优先保证画面质量。
分辨率:建议1080P或以上。
帧率:24fps或30fps。
六步制作流程图(简要版)
剧本 → 提取人物形象 → 生成角色面板(文字)
↓ 第一步:角色面板 → 第二步:生成定妆照(1张)
↓ 第三步:根据定妆照生成16视图(1张)
↓ 第四步:根据剧本生成12格分镜故事板
↓ 第五步:提取场景锚点卡 + 拆分独立分镜图
↓ 第六步:导入 Seedance 2.0 → 生成15秒视频
制作时间估算(新手版)
刚开始做的时候,很多环节都需要反复调整,可以先参考下面的时间安排:
整体耗时:不算剧本创作,第一次完整跑下来大约需要1.5~2小时,可以得到一段15秒左右的视频。
等整套流程熟悉之后,很多提示词和素材都能直接复用,制作时间也会慢慢缩短,熟练后争取控制在1小时以内。
常见问题排查指南
制作过程中难免会遇到一些小问题,尤其是刚开始做的时候,可以对照下面的方法调整。
写在最后
到这里,整套六步流程就算跑通了。
从最开始写剧本、设计人物,到定妆照、16视图、分镜和视频生成,之前零散的操作现在终于能串在一起了。
刚开始不用追求一次就做得多完美,可以先完成第一个15秒视频,熟悉每个环节怎么衔接,再慢慢优化人物、场景和镜头效果。
先把一整套流程跑通,比一开始就纠结某个镜头的细节更重要。
等真正熟悉之后,你会发现,很多步骤都可以复用,后面制作新故事也会轻松不少。
我是佳佳!点关注,不迷路,我们下期再见!!

