爆款短剧怎么拍的?rea-video 逐镜头拆开,复刻方案直接给你
- 2026-11-19 09:12:01
爆款短剧怎么拍的?rea-video 逐镜头拆开,复刻方案直接给你
刷到一条爆款短剧,第一反应是收藏。第二反应是:这条到底怎么拍的?是实拍、AI 生成,还是代码做的?换成我自己的产品,能不能照着做一条?
以前这个问题没有标准答案,只能凭感觉猜。现在有了 rea-video:一个开源工具,把一条视频逐镜头拆开,判断每个镜头是实拍、AI 生成还是代码渲染,再给你一份能照着做的复刻方案。
这篇是我亲自装上、跑通一次的记录。用的官方样片是一条 19 秒的混合短片,我把全过程、真实输出和踩到的坑都写下来了。
这是什么
rea-video(JuneYaooo/rea-video,Apache 2.0 开源)做一件事:逆向拆解一条视频是怎么做出来的。
它不直接生成视频。它回答三个问题:
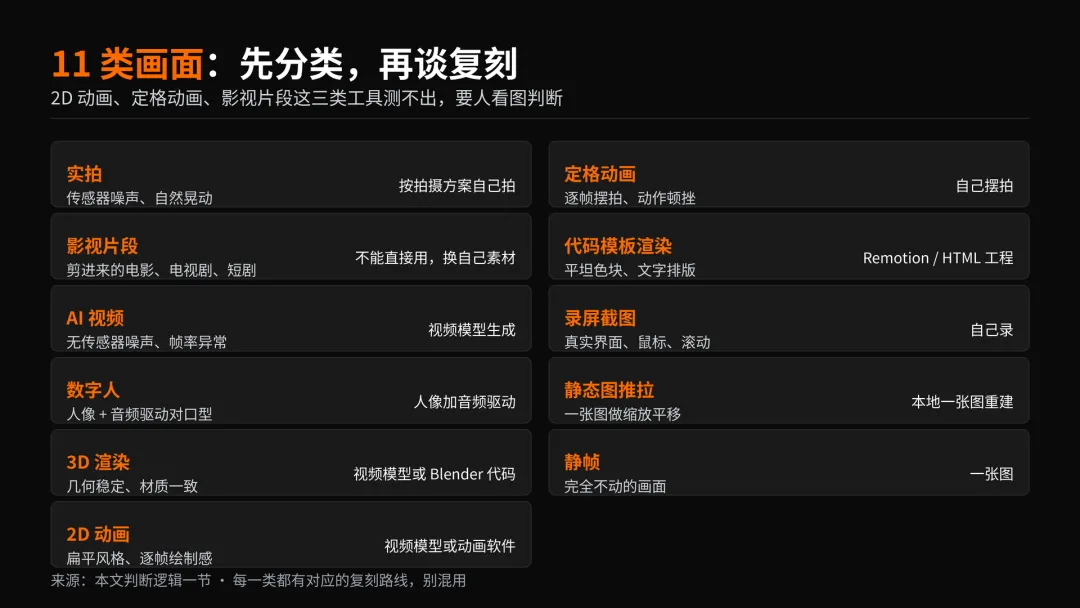
每个镜头底层画面怎么来的?从 11 类里选:实拍、影视片段、AI 视频、数字人、3D 渲染、2D 动画、定格动画、代码模板渲染、录屏截图、静态图推拉、静帧。实拍镜头还要看有没有被 AI 加工过(换脸、对口型、风格化、换装、换背景)。 上面叠了什么?逐句字幕(时间轴、颜色、描边、入场方式)、花字、标题、贴纸、画中画,以及音效卡在哪个画面事件上。 怎么复刻?每镜给出路线和工具:AI 镜头交给视频模型生成,实拍镜头给拍摄方案,代码镜头写成 Remotion 工程。
它跟同作者的 rea(Reverse Engineer Anything)是同一个思路:从你看到的东西倒推它是怎么做的,每个结论都要有证据。只不过 rea 针对软件,rea-video 针对视频。
先看结论:我实测了一条 19 秒混合片
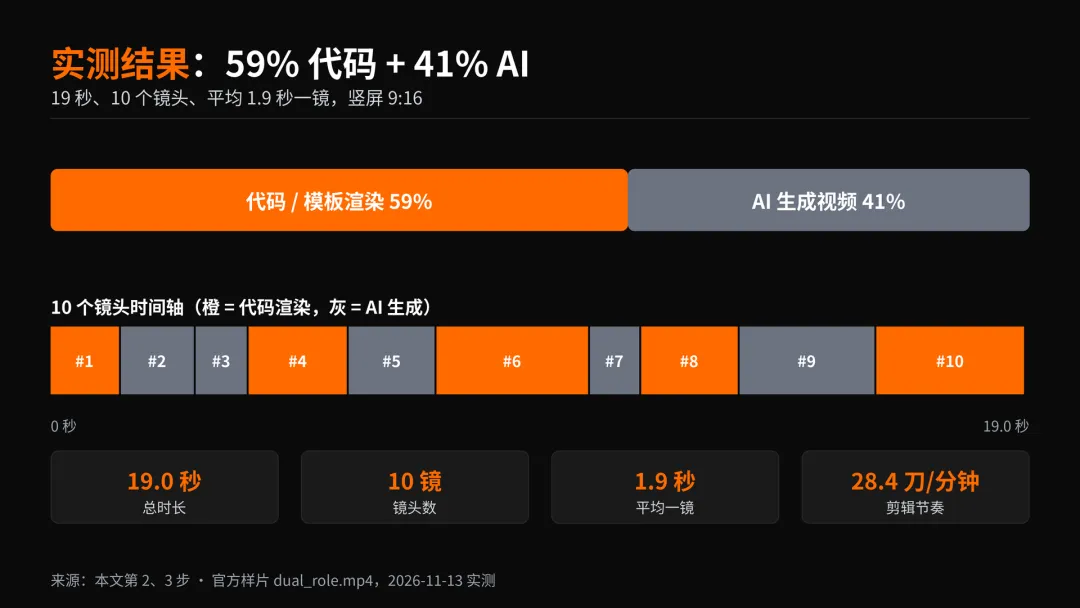
先报结果,再讲过程。我跑的是官方仓库里的样片 dual_role.mp4:19 秒、竖屏 9:16、10 个镜头,一条 AI 角色对话和代码模板画面交替出现的混合片。
工具给出的结论:
混合制作:代码/模板渲染 59% + AI 生成视频 41%
复刻方案只有两行:
AI 视频 5 镜 → 1 个生成单元、1 次 Seedance 2.0 调用 代码渲染/录屏 5 镜 → 1 个代码工程(5 段)
真实素材要自己准备 5 处:4 处录屏素材(共 8.2 秒)、1 处界面截图(2.9 秒)。
这个结论跟官方公布的同一条样片报告完全一致。官方报告也是 59% 代码 + 41% AI,5 个对话镜头分 4 次生成(我这版工具合并成了 1 次生成单元,版本差异,下面会讲)。
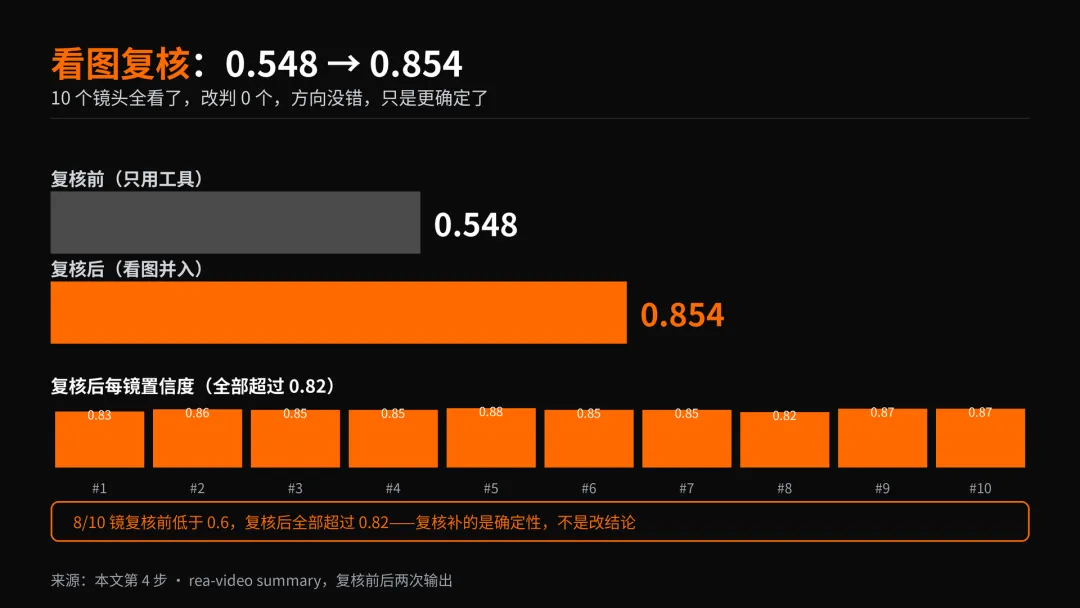
但第一次跑完,置信度只有 0.548(满分 1),10 个镜头里有 8 个低于 0.6。原因在后面讲:我没配 VLM,只靠像素统计判断。做完看图复核后,置信度升到 0.854,10 个镜头全部超过 0.82。
第 1 步:安装
rea-video 是给 AI Agent 用的工具,跑在 Claude Code、Codex 或任何能执行命令的 Agent 里。你也可以自己在终端跑。
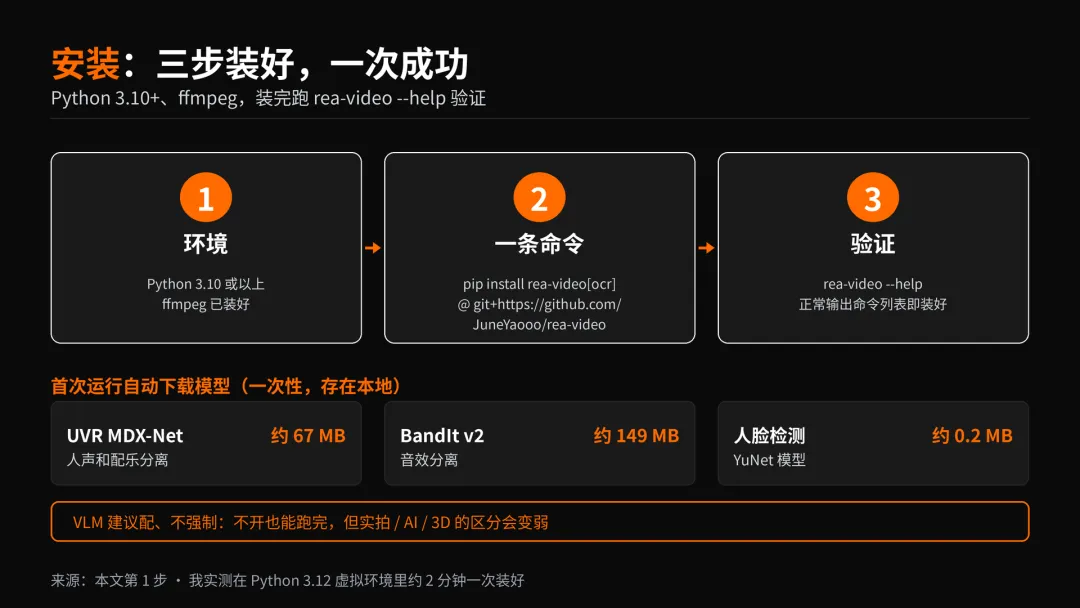
环境要求
Python 3.10 或以上 ffmpeg(已装好) 一条能看视频的 Agent(或者你自己看图复核)
安装命令
pip install "rea-video[ocr] @ git+https://github.com/JuneYaooo/rea-video"
装完验证:
rea-video --help
我实测是在 Python 3.12 的虚拟环境里装的,从敲命令到 rea-video --help 正常输出,用了约 2 分钟,一次成功,没遇到依赖冲突。
注意两点:
系统 Python 报 externally-managed-environment时,别加--break-system-packages,改用 pipx 装,或跑仓库里的scripts/install_skill.sh(它会自动改用 pipx 或仓库内.venv)。Python 太新时可能出现 onnxruntime找不到对应版本,换 3.10–3.14 的解释器就能解决。
首次运行会下载模型
第一次拆解时,工具会自动下载声音分离模型到 ~/.cache/rea-video/models:
人声和配乐分离:UVR MDX-Net,约 67 MB 音效分离:BandIt v2,约 149 MB 人脸检测:约 0.2 MB
这些都是一次性的,下载完就存在本地。之后每次跑都不用再下。
VLM:建议配,不强制
VLM 是能看图、看视频的多模态大模型(Gemini、GPT-4o、豆包、Qwen-VL 都行)。配置走 OpenAI 兼容接口:
export REA_VLM_BASE_URL=https://.../v1
export REA_VLM_API_KEY=你的密钥
export REA_VLM_MODEL=gemini-2.5-pro,gpt-4o
不开 VLM 也能跑完、出报告,但实拍、AI、3D 的区分明显变弱,音效清单也只有信号层的低置信候选。我的实测就是没开 VLM 跑的,结论是对的,但置信度低,靠后面的看图复核补回来。
密钥不要写进对话、仓库或报告。用 --env-file 读一个 .env 文件,或者直接 export 环境变量。
第 2 步:跑一次拆解
一条命令:
rea-video decompose dual_role.mp4 -o out/dual_role --lang zh
参数说明:
dual_role.mp4:要拆的视频文件-o out/dual_role:输出目录--lang zh:报告用中文(默认就是中文;要英文报告用--lang en)没配 VLM 就不要加 --vlm,工具会照常跑,不会因此中止
我这次跑了 522.5 秒(约 8.7 分钟),其中下载模型占了约 7 分钟,真正拆解约 1 分钟。官方说法是“一条 30 秒视频不开 VLM 约 1 分钟出结果”,跟我的实测吻合——模型下载完之后再跑就快了。
输出文件都在 out/dual_role/ 里:
VIDEO.md | |
report.htmlreport.md | |
breakdown.json | |
storyboard.jpg | |
shots/ | |
packaging/ | |
stems/ | |
audio.png |
第 3 步:读懂结论
跑完先看紧凑摘要:
rea-video summary out/dual_role/breakdown.json
我的实测输出(关键部分):
结论:混合制作:代码/模板渲染 59% + AI 生成视频 41%
  (其中 31% 时长实拍还是 AI 证据不足,待确认)
置信度:0.548
VLM:未开 VLM;实拍/AI/3D 的区分只靠像素统计,可信度有限
低置信:8/10 镜置信度 <0.6,都要复核(只有 #5、#9 不用)
逐镜表长这样:
注意两点:
次选概率很关键。比如 #4 判定代码渲染只有 40%,次选 3D 渲染 33%,两个只差 7 个点,说明工具自己也不确定。这时候不要直接信结论,要看图复核。 “待确认”不是失败,是诚实。工具在 31% 的时长上写明“实拍还是 AI 证据不足”,而不是编一个确定的答案。这个态度值得学:宁可写“待确认”,也不要编答案。
除了逐镜结论,摘要里还有一整套测量数据:
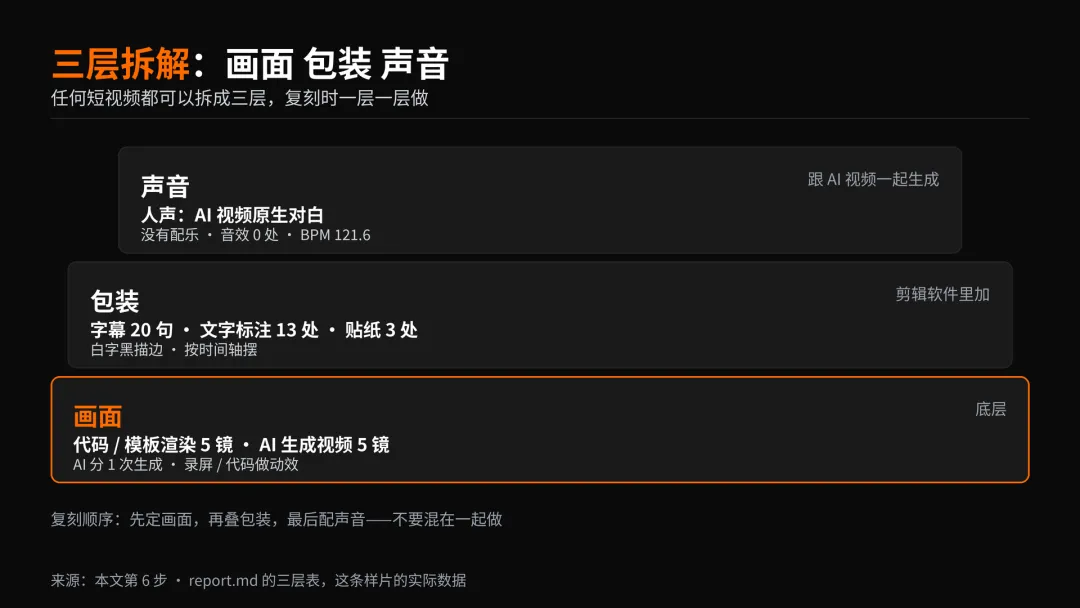
取景:景别近景 100%,主体是人脸 机位:固定机位 66%、移动机位 34% 打光:夜景/弱光环境光,没有专门补光;主光正面,从下往上;光比约 1.3:1;色温偏冷 调色:自然,饱和度、对比、黑位都正常 剪辑:每分钟 28.4 刀,平均镜头 1.9 秒 声音:有人声(AI 视频原生对白),没有配乐,BPM 121.6,F 大调;音效 0 处 包装:字幕 20 句(白字黑描边)、文字标注 13 处、贴纸 3 处
打光那段有个重要提醒:画面不是实拍,以上是画面里的光影,用于写生成提示词,不是拍摄方案。AI 生成的画面也有光影,但那不是真的灯光,别照着去布灯。
第 4 步:看图复核(最关键的一步)
工具只靠像素统计时,置信度普遍偏低。官方的建议是:能看图的 Agent 自己当 VLM,逐镜看图复核,再把答案并入结论。
流程是三条命令:
# 1. 生成逐镜看图任务和答案模板
rea-video review out/dual_role

# 2. 按 review_tasks.json 的指引,逐镜看图,把答案填进 review_answers.json
#    每镜填:label_probs(你认为的类别概率)、evidence(你看到的证据)、
#    description(这镜在讲什么)、narrative(叙事作用 + 一句话要点)

# 3. 并入结论,重写报告
rea-video apply-review out/dual_role --by Muse
我照这个流程做了。看的是工具生成的故事板(10 个镜头拼成一张图),10 个镜头全看了:
5 个 AI 镜头(#2、#3、#5、#7、#9):同一个女主角,短发、眼镜、绿马甲配白衬衫,夜景房间里对着镜头说话。5 个镜头长相完全一致,皮肤和光影是生成画面的质感。确认是 AI 视频。 5 个代码镜头(#1、#4、#6、#8、#10):深色模板底、白色文字排版,画面里是笔记诊断文字、榜单、操作步骤和一张 GitHub 仓库页截图。确认是代码/模板渲染。
并入结果:
已并入 10/10 个镜头;改判 0 个
结论:混合制作:代码/模板渲染 59% + AI 生成视频 41%
VLM:由 Muse 看图复核 10/10 个镜头,已并入结论
置信度从 0.548 升到 0.854,10 个镜头全部升到 0.82–0.88。改判 0 个,说明工具的原始判断方向是对的,我的复核只是把“不太确定”变成了“确定”。
叙事线也出来了:
#1–2 抓注意 → #3 补信息 → #4 给证据 → #5 转折 → #6 给证据 → #7 补信息 → #8 给结论 → #9 转折 → #10 引导行动
这条线是复刻时最值得保留的东西:不是照抄画面,而是照抄“为什么有效”的结构,换成自己的案例和素材重写。
第 5 步:读 VIDEO.md(给 AI 读的拆片包)
每次拆解都会在输出目录写一个 VIDEO.md。官方的说法是:每个 Skill 都有 SKILL.md,每条视频就该有个 VIDEO.md。
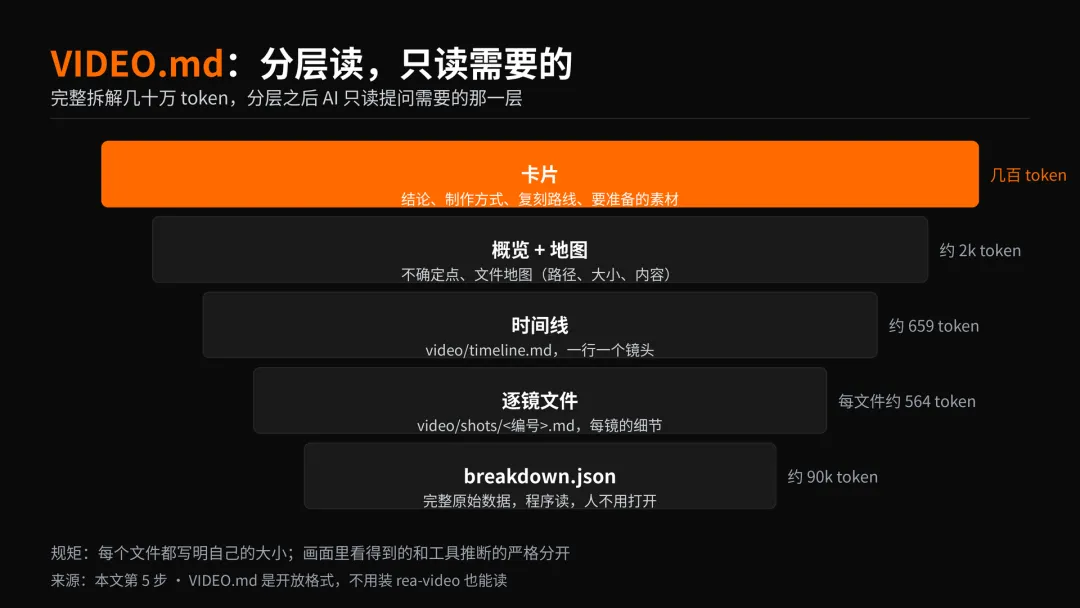
它的设计思路是分层:一个完整拆解有几十万 token,直接全读太贵。VIDEO.md 把内容按层组织,AI 只读提问需要的那一层:
video/timeline.md | ||
video/shots/<编号>.md | ||
video/content.mdvideo/cast.md(角色场景)、video/sound.md(声音)、video/look.md(拍法打光)、video/packaging.md(包装)、video/remake.md(复刻方案) |
还有两条规矩:
每个文件都写明自己的大小,AI 读之前就知道要花多少 token。 画面里看得到的和工具推断的严格分开:时间线里键名带 ~的是推断,不带的是画面里看得到的。
这个格式是开放的(videomd/videomd),其他 Agent 和工具不用装 rea-video也能读:
pip install videomd
videomd check out/ref
第 6 步:读报告(三层拆解)
report.md 是给人看的版本。它的结构很值得学:任何短视频都可以拆成三层,复刻时一层一层做。
| 画面 | ||
| 包装 | ||
| 声音 |
分镜表是报告的核心。每镜一行:时间、时长、画面、运镜、叠加层、制作方式、素材来源、复刻路线。比如这条样片的 #9(13.5–16.1 秒,2.7 秒):AI 生成视频 70%,叠加字幕和标题,复刻走 AI 生成 G1 单元。
报告里还有一份“自己复刻”的步骤清单,按顺序做:
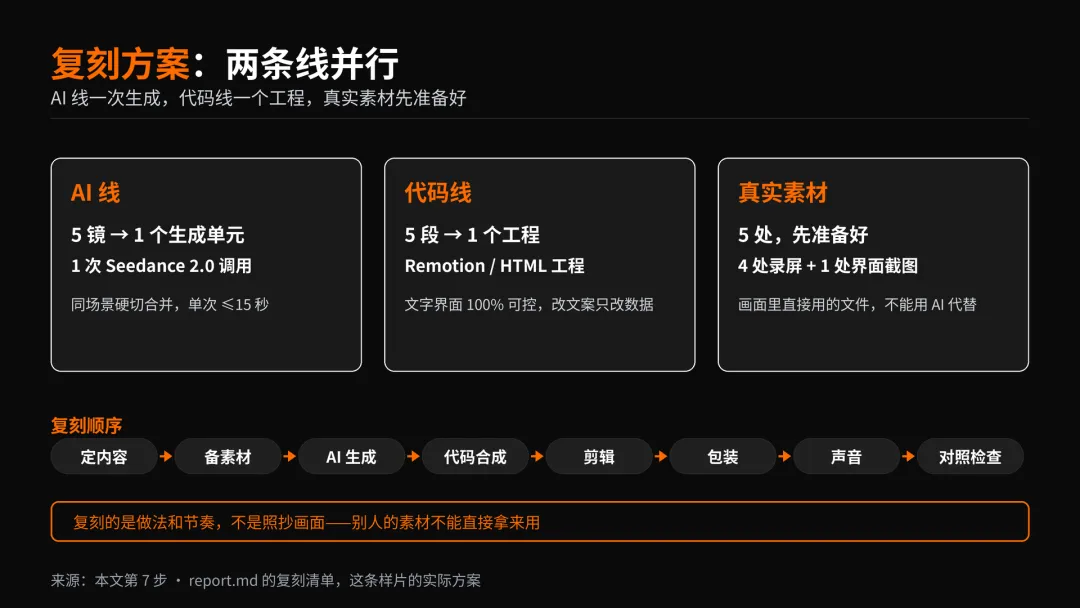
定内容:照叙事线写自己的脚本 备素材:见下方清单 AI 生成:1 次生成 录屏和动效:代码合成 剪辑:按原时间线拼 包装:字幕文件直接导入剪辑软件 声音:每处音效都能先试听 对照检查:成片和原片并排看一遍,镜头长短、字幕位置、音乐起落对不对得上
第 7 步:拿去复刻
复刻不是把原片照抄一遍。官方报告开头就写明:复刻的是做法和节奏,不是照抄画面。别人的 footage、音乐、角色、长相不能直接拿来用,要用自己有版权的素材。
备素材:先准备这 5 处
注意:录屏素材和界面截图是画面里直接用的真实文件,复刻时必须拿到原文件,不能用 AI 生成代替。工具在报告里把每处的位置(x、y、宽、高)和时长都标出来了,照着录就行。
AI 生成:5 镜合并成 1 次调用
5 个 AI 镜头(#2、#3、#5、#7、#9)是同一个场景、硬切相连,工具把它们合并成 1 个生成单元,1 次 Seedance 2.0 调用。分组规则:
同场景、硬切相连的 AI 镜头合并为一次生成 单次不超过 15 秒 单元内连续硬切尽量不超过 8 秒,最多 10 秒 在叠化、淡入淡出和换场景处切开
提示词写法(Seedance 2.0 通用结构):精准主体 + 动作细节 + 场景环境 + 光影色调 + 镜头运镜 + 视觉风格 + 画质 + 约束条件。中文 500 字以内。参考素材先定义再复用:“将图片 1 中的……定义为主体 1”,每个主体带 2–3 个稳定特征。台词用 {} 标,音乐用 () 描述,音效用 <> 标。不想要的内容写在末尾约束里,比如“保持无字幕”“不要生成 Logo”。
口播不要让视频模型生成:单独录好再混进去,方便改文案和卡时间。
代码合成:1 个 Remotion 工程
5 段代码/录屏画面写成 1 个 Remotion(或 HTML)工程。文字和界面 100% 可控,改文案只改数据,可以直接让大模型写这个工程。不需要视频模型。
包装:字幕文件直接导入
字幕不用重新打:packaging/subtitles.srt 可以直接导入剪辑软件;样式和时间轴见报告的“剪辑包装层”。或者用 ffmpeg 直接把 ASS 字幕压制上去:
ffmpeg -i 复刻成片.mp4 -vf ass=out/dual_role/packaging/overlays.ass -c:a copy 输出.mp4
贴纸和动图要找同款素材(表情包库、GIF 库),截图在 packaging/ 目录下。
自动复刻:capsule-cinema
如果装了 capsule-cinema,AI 镜头可以自动生成并放回原时间线:
# 先看任务清单,不真正生成
rea-video remake-plan out/dual_role/breakdown.json --capsule-root ~/code/github/capsule-cinema

# 确认后再执行(会计费,先 --dry-run)
rea-video remake-run out/dual_role/remake/jobs.json --dry-run
实拍镜头要按拍摄方案自己拍,代码镜头写成 Remotion 工程。最后用 rea-video assemble 把复刻结果按原时间线拼回,输出对比视频。
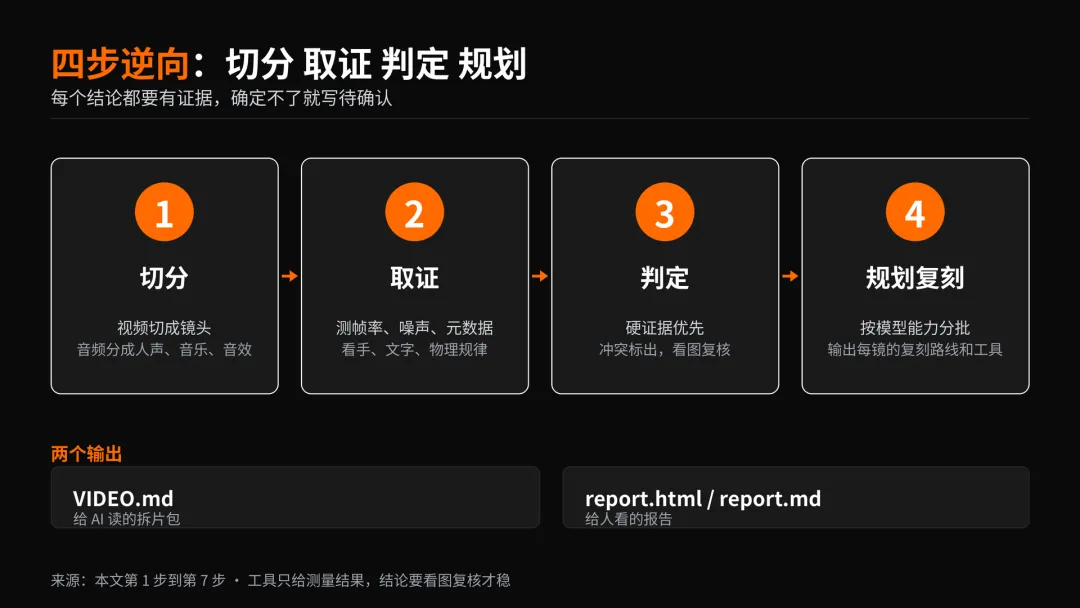
它怎么判断的:四步 + 硬证据优先
理解判断逻辑,才能知道什么时候该信它、什么时候该自己看。
四步流程
切分:把视频切成镜头,音频分离成人声、音乐、音效三轨 取证:测量(帧率、传感器噪声、整幅画面是否像一张平板一样整体移动、元数据里的 AIGC 标识)、看(手、文字、物理规律)、听(BPM、调性、唱还是说) 判定:硬证据优先,冲突的标出来让 Agent 看图复核 规划复刻:按目标视频模型的能力分批(最长片段、多镜头支持、参考图数量)
硬证据优先
这是最关键的一条规则:有 AIGC 标识、帧率异常这类硬证据时,硬证据说了算,哪怕画面“看起来像”实拍。反过来,元数据缺失不能当成“不是 AI”的证据——平台转码经常清除元数据。
几个容易踩的坑,官方文档里明确写了:
不要只凭画风判断。卡通 3D 风格既可能是 AI 视频,也可能是 Blender 渲染,要看形变、闪烁和几何稳定性。 不要把代码画面里的文字算成叠加层。那些文字就是画面本身。 不要把用户的真实素材写成“可用 AI 生成”。录屏和截图必须拿到原文件。 平台转码会压暗部。软硬光和补光的测量会偏保守。
11 类画面,一张表记住
准确率与局限:先看官方数据,再看我的实测
官方在 eval/RESULTS.md 公布了评测数据(按镜头时长加权):
真实素材识别率 97–99%。在 9 条人工标注的片子上,镜头边界召回率 95%、精确率 94%。
转码视频是最弱的一环。只用工具时,微信转码过的视频准确率掉到 88.6%,因为转码清除了噪声证据。加视觉模型或看图复核能拉回 99% 以上。
我的实测也印证了这一点:样片是重新压缩过的,平台标记被清掉了,只用工具时置信度只有 0.548,8/10 个镜头低于 0.6。看图复核后升到 0.854。结论方向没错,但不做复核就直接信,风险很大。
另外两个局限要知道:
声音判断要能听音频的模型。官方案例里有一条 AI 音乐 MV,工具把人声判成 TTS 旁白、音乐判成曲库配乐,实际是 AI 生成的歌。看图复核只看画面,声音得靠能听音频的模型。 2D 动画、定格动画、影视片段,工具测不出。这三类要人看图判断。
常见坑
坑 1:拿样片跑,结果跟官方报告不一样
官方样片为了减小仓库体积重新压缩过,平台标记(抖音、TikTok、微信)没有保留,还多了一层压缩痕迹。自己拿它们跑,结果会和报告有出入,只用工具、不做看图复核时更明显。要复现报告,用平台下载的原文件。
坑 2:VLM 那行写着 failed / not_configured,还以为开了
VLM 是否真的生效,以 rea-video summary 的 VLM: 一行为准。failed 或 not_configured 等同没开,报告里要如实写,不能写“已开 VLM”。
坑 3:把 breakdown.json 直接贴给用户
breakdown.json 有几十万字,是给程序读的。给人看的是 report.html / report.md,给 AI 读的是 VIDEO.md。不要把原始 JSON 贴进对话。
坑 4:复刻时照抄原片画面
官方 FAQ 里明确写了:rea-video 是用来学一条视频的结构、节奏和手法,再用自己有版权的素材重做。不要直接复用别人的 footage、音乐、角色、长相。发布时遵守平台规则和本地 AI 内容标注要求。
坑 5:长视频一次跑完
默认最多 60 次 VLM 调用,镜头更多时先看最拿不准的,其余只靠确定性取证。需要全看就加 --max-vlm-shots N 重跑,或对这些镜头做看图复核。
未核实说明
下面这些我没有亲自验证,写出来是让动手的人心里有数:
VLM 模式没有实测。我全程没配 VLM(没有可用的多模态模型密钥),所有结论都是工具 + 我自己看图复核得出的。配了 Gemini 或豆包之后准确率能到多少、调用花多少钱,没有实测数据,以官方评测表为准。 capsule-cinema 自动复刻没有跑通。 remake-plan、remake-run、assemble这些命令我只核对了文档和帮助信息,没有真的装 capsule-cinema、没有付费生成过。自动复刻的实际效果、耗时和费用未知。Remotion 工程没有真的写出来。报告说代码镜头可以写成 1 个 Remotion 工程,我没有动手写这个工程,也没有验证生成效果。 长视频没有测。我跑的是 19 秒、10 个镜头的样片。官方案例里最长的是一条 165 秒、86 个镜头的 AI 音乐 MV,耗时和稳定性我没有实测。 中文以外的 OCR 没有测。字幕和花字是日文时要加 --ocr-lang ja,这个参数我没有实测。ASR 语音识别没有装。可选的 rea-video[asr]包(SenseVoice 语音识别)我没有安装,台词识别效果未知。我的实测里台词来自字幕 OCR,不是语音识别。不同平台下载的原片没有对比。我只跑了官方样片(重压缩版)。抖音、TikTok、微信下载的原片各有什么差异,没有实测。

