研究了一下 AI 短剧开源项目shuohao-skills
- 2026-11-19 04:45:34
大家好,我是格里灰丝。
这次拆的项目叫 shuohao-skills,一套做 AI 短剧的 skill 包。今年 8 月 6 日建仓,三个月攒了六千三百多个 star、近九百个 fork,已经发到 2.2.1 版。
前面我们拆过写小说的 InkOS、chinese-novelist,也拆过做短剧的 Toonflow 和 Jellyfish。问题照旧:主模型是 Opus 5.5,写剧本、写分镜提示词它都会,这套 skill 还能帮它什么?
拆完的结论:有价值,价值在作者翻车以后补上的那些规则,大部分落在"文字变成视频"这一段。整套框架(怎么分层、JSON 加检查脚本、报告页面)Opus 5.5 一天就能搭出来,不值钱;搭不出来的,是作者把一部小说一路做到视频投产包、出图出错以后才知道的事。这些规则大多只跑过一两次,没有对照实验,拿来用要自己再验一遍。
它是什么
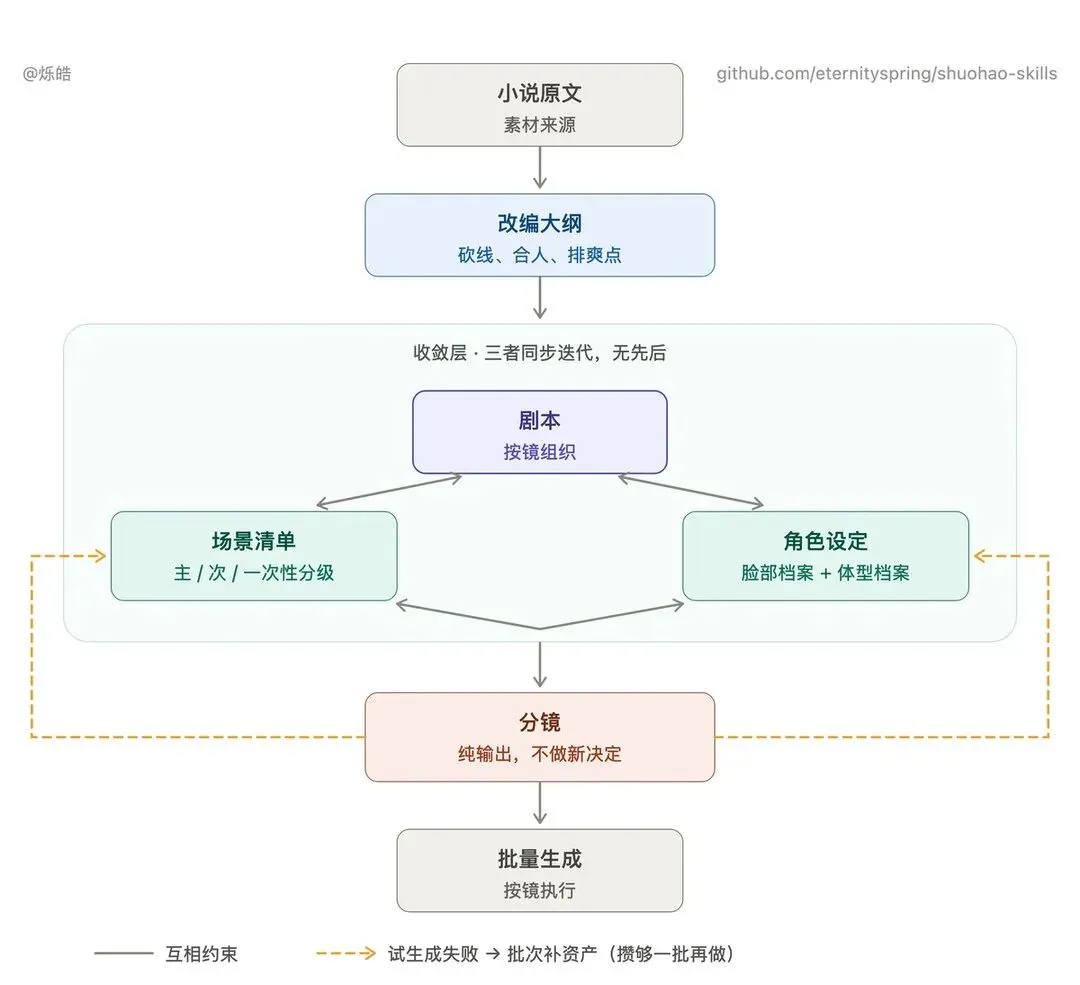
7 个 skill,串成一条管线:
1. novel-outline 把小说改编成短剧大纲:砍线、合人、排爽点、列道具。
2. novel-characters、novel-art、novel-script 三个互相迭代:角色设定、场景和道具设定、剧本。
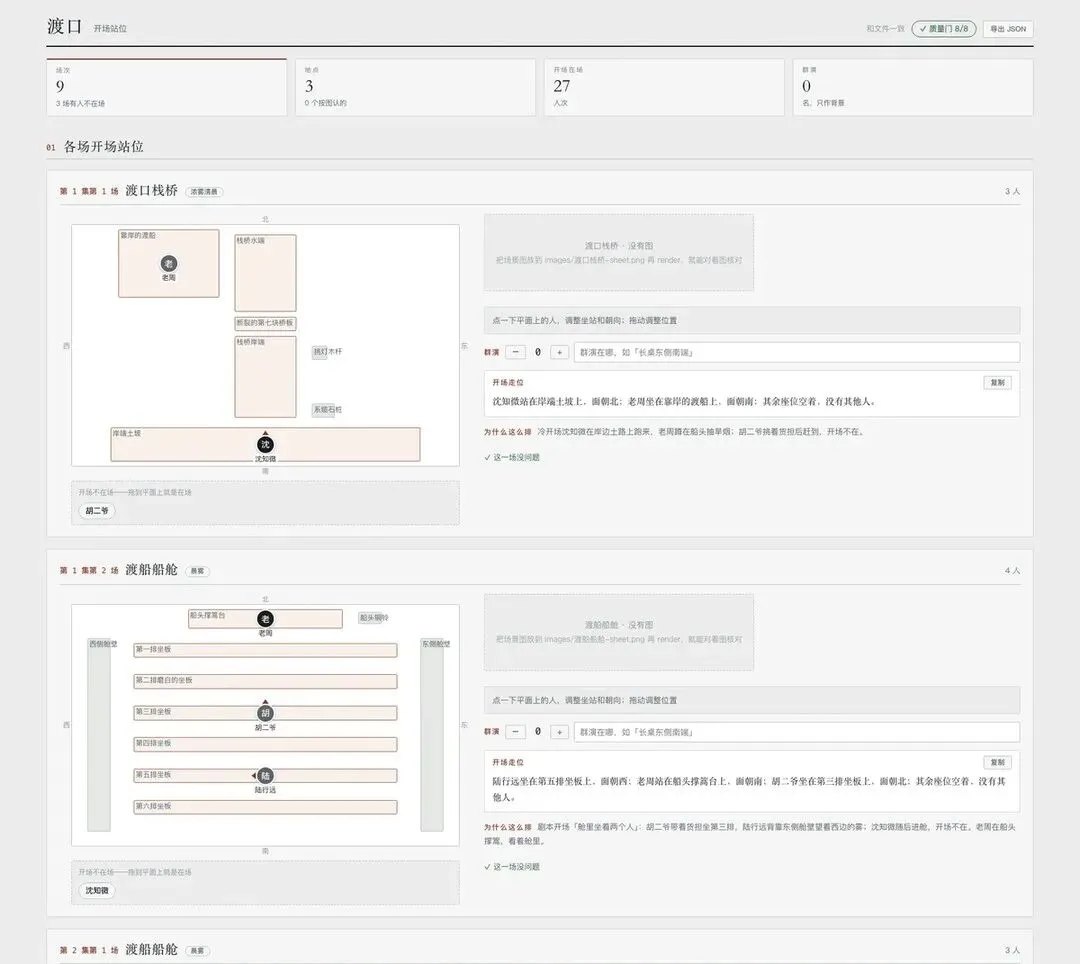
3. novel-staging 给每一场排开场站位。
4. novel-storyboard 切分镜,导出给 MiniMax H3 或 Seedance 用的投产包。每段视频一个文件夹,里面是提示词和分镜图清单。
5. character-refs 单独存在,真的调用图像模型给角色出参考图。
做法很统一:模型只填 JSON,零依赖的 Node 脚本负责检查、渲染报告、导出。六个制作阶段的检查加起来大约 80 道,作者叫"质量门",每一道都配了故意写坏的测试用例,证明它真的会拦。除了 character-refs,其余 skill 都只交提示词,不出图,也不出视频。
样例是作者自己写的 6 集短剧《渡口》:民国,一个抱着旧皮箱的女人,上了一条雾里的渡船。从大纲到分镜,每一层的产物仓库里都有。
模型这么强,为什么还需要它
作者在第一个版本的更新说明里写了一句话,整套项目都建在它上面:"checklist 交给模型自觉是靠不住的。"
这句我们认同。可光靠检查,解决不了另一类问题:视频模型会怎么失败。动作写得多精巧就会崩,参考图少挂一张会怎样,哪句话会被画进画面,这些事发生在图像模型和视频模型里。Opus 的训练数据里没有,推理也推不出来,只能跑一次看一次。
这个项目的规则文档里,带"实测""踩过""必崩"的句子特别多。下面只挑这类经验,框架本身略过。
第一份精华:剧本在写的时候就要替视频模型着想
先说清楚,这个项目不写小说,它把现成的小说改编成短剧大纲和剧本。文字这一侧,"台词要短""别让一个人连说四句""台词别把信息说尽"这些写作课,Opus 本来就会。有增量的只有下面几条,全是为了视频模型才定的规矩。
动作只写常见动作。 判据就一句:这个动作在生活视频里常见吗?上船、坐下、递东西、点头、回头、抱紧,放心写。"货担撞上船帮,老周伸篙一挡,担子稳稳落进舱里",篙、担、船帮三样东西互相作用,作者的原话是"必崩",要改成"胡二爷挑着担子上船,老周搭手帮他把担子卸进舱里"。微表情(睫毛颤)、以寸计的位移(退了半寸)、比喻式的画面,一律改写。样例里 29 处这类动作,全按这条洗过一遍。
冷开场要在运动中给。 第一拍原本是"旧皮箱抱在怀里,指节掐白",一个静物特写。作者人审时发现这一秒画面是死的,竖屏观众划走就在这一秒。改成"抱着旧皮箱在雾里跑",掐白的指节留到登船那一刻再给。
声景也是动作指令。 剧本把撞船帮改成了搭手卸担,声景还写着"铜铃在撞击时炸响",视频真把撞击演了出来。改画面,声景要一起改。
改一拍,连读前后三拍。 写的时候,人物在哪、手里拿着什么,都在脑子里;改的时候,这些状态不在了。所以每改一拍,前后各读一拍,专查位置、道具、谁在场。
第二份精华:文字变成视频这一段的翻车经验
这是全项目最值钱的部分。先交代一下它的结构:段是一次视频生成,不超过 15 秒,不跨场次;段里切成 2 到 5 秒一个的镜头,大致 3 秒一切;每个镜头配一张分镜图。给 H3 时,第一张图钉在 0 秒,其余各钉在自己镜头开始的那一秒。这套结构 Opus 自己也设计得出来,值钱的是下面这些出过错才知道的事。
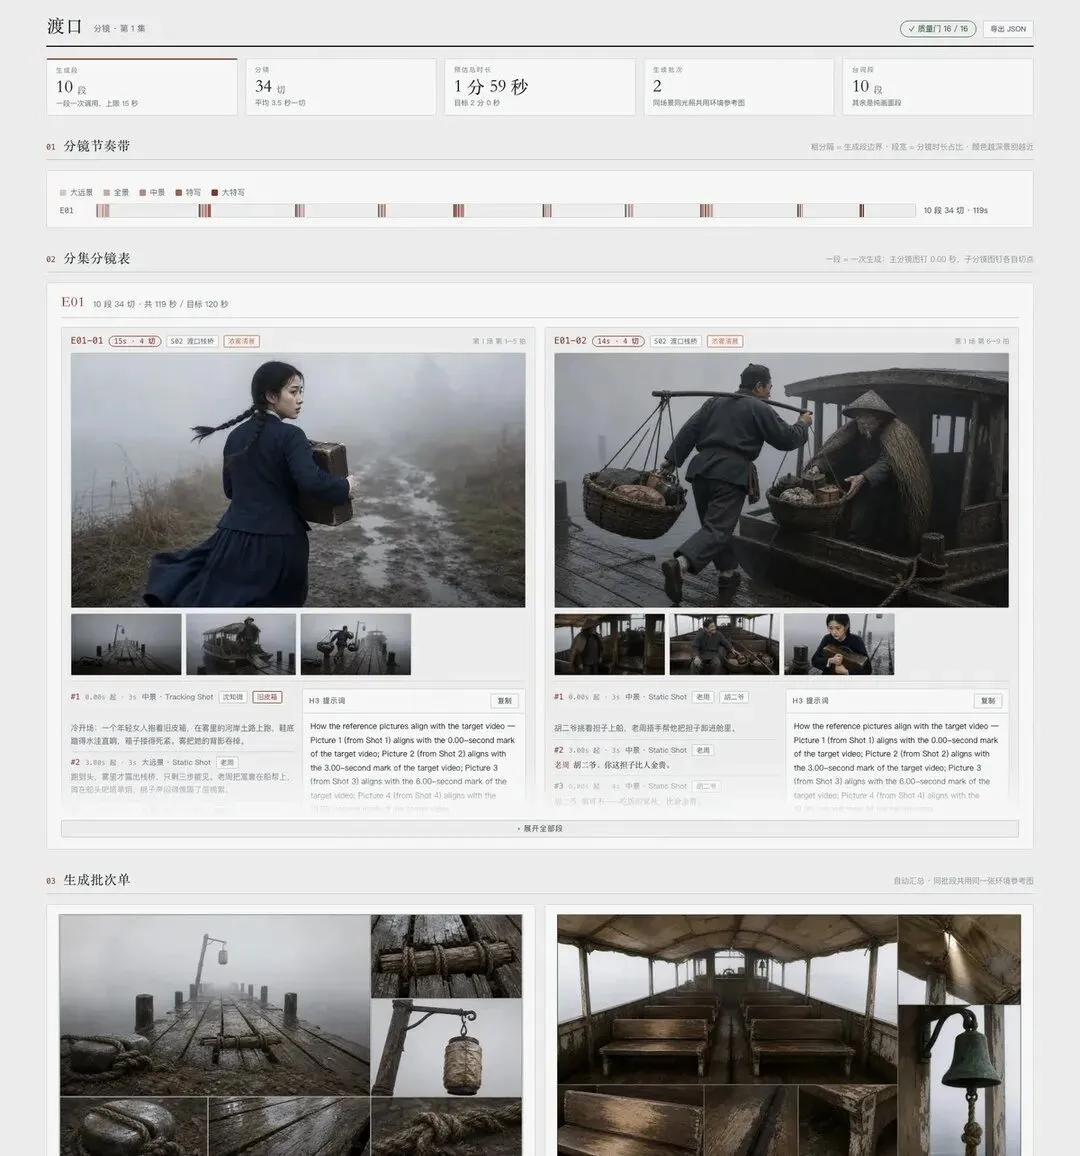
参考图按"画面里有什么"挂。 这段属于栈桥那场,画面里却出现了渡船,就要把渡船的设定图也挂上。作者漏挂过一次,结果每一帧都发明了一条新船。船、马车、宅门这类会入画的大件都一样。
人物此刻在哪,要写进提示词。 只写构图,不写"已上船、在舱内、站在桥头",模型会把上了船的人又画回岸上。
名字的规矩两头相反。 分镜图的提示词里直接写角色名,因为它是挂着角色设定图一起生成的,名字就是"去找哪张图"的地址;两个年轻男子同框时,写"一名年轻男子"分不清谁是谁。视频提示词的正文里一律写通用身份,比如"一名铁灰袍中年男子",这是 H3 和 Seedance 官方提示词规范的要求,人名只许出现在台词里。设定图本身的提示词也禁写名字,图像模型会照着它记忆里的同名角色画。
两家视频模型的官方口径,它整理好了。 H3 要英文、逐镜写时间码、台词放进
每场先排开场站位。 这是 10 月新加的一步。每段视频各自生成,每场第一段谁坐哪是模型自己编的,群戏里桌边多出五个没名字的宾客,端酒的人穿着主角的衣服。站位这一步先从场景图里认出能站能坐的东西,再排谁在哪。两条规矩很实用。一是认图,不认提示词:提示词里写了北端有个主位高台,图上没画出来,站位让人坐了上去,出来的视频每段都不一样。二是剧本没写有别人,就是没有别人:别为了热闹加群演,视频模型会把空出来的位置画成一个个有脸的人。
画风别写进每条提示词。 1.x 版把画风写死在每条提示词里,换风格要逐条改,还会和出图时选的画风打架。2.0 版全部拿掉,上游只写"画什么",出图时整批附加画风。代价作者也写了:写死的时候,能压住一部分画风漂移。
第三份精华:设定图和参考图的写法
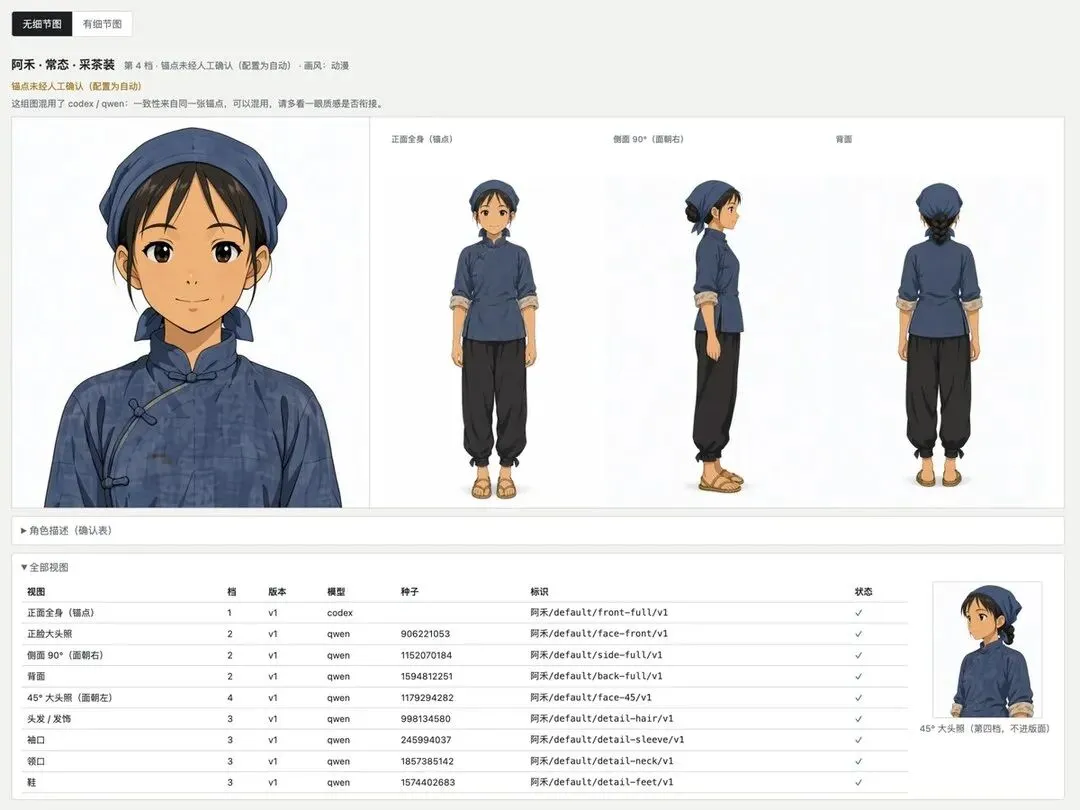
character-refs 的提示词文档开头写着:"每一条都是某一轮实测失败换来的。"测的是 Qwen Image 2.1 和 GPT 出图,四个角色,多数写法各跑两个种子。
一组图只有一个根。 正面全身是唯一一张从文字生成的图,大头照、侧面、背面、细节图都只参考它。图与图之间不互相参考,否则偏差会一张张累积,重出一张还会牵连一串。
改图模型只听第一句。 参考图的构图力量很强,模型默认照着重画一张差不多的。要大头照,第一句就得写"拉近成证件照式的头肩特写",再写头顶贴上边、下巴在画面正中、下边切在锁骨;只写 close-up,出来是半身。要正面,就写成几何:肩、髋、脚都正对镜头,两只耳朵一样可见。只写"面向镜头",动漫画风会画成微侧身。
一致性清单要短。 大头照只写脸、头发、上装。写了裤子和鞋,模型就把镜头拉远去画它们。细节图把整套衣服列了一遍,第一轮 8 张全部失败。
还有几个小坑:
写光的效果,别写光源。写了 window,窗户就会出现在画面里。
别写 model sheet、turnaround,模型会在一张图里画好几个视图。
细节图没有脸做参照,露出来的皮肤会画老,要补一句"露出的皮肤是 16 岁的皮肤"。
脸上的小东西(比如眼镜)单独出特写,三种写法、两个种子,全都画成了整张大头照。
多人同框时,给每人一张"大头照加三视图"的拼接图当参考,4 张里有 3 张画出了三四个人,女主还被男主"吃掉"了。
角色和场景设定的写法,也有几条好的。
关于设定的话不进提示词。 "古代""架空"在画面上没有对应物,模型只能自己挑,于是庭院出成宋、书房出成明、道具出成清。整部剧要定一个具体朝代,架空的就写它像哪个朝代。
"用旧"不能当默认。 场景的表面处理分两档:日常使用的,有掉漆、水渍、包浆;一直有人维护的,漆面匀亮,只在门槛、扶手、台阶这些人走出来的地方有磨损。整部戏都写成用旧,金銮殿出来就是漆面剥落、门框带水渍。
服饰的款式名放第一个。 中文描述转成英文时,丢东西总是从尾巴开始丢。"素玉小冠""细密暗纹丝绸"放在中段,转完英文都没了,只剩一件谁都能穿的素袍。
族裔不写,模型默认画西方人。 民国的老船夫,出成了穿工装的美国老头。
道具的尺寸要写死。 手持、桌面、家具三档,各有一个固定的英文短语进提示词,不写的话,皮箱会被画成衣柜。
第四份精华:音色提示词
有用户拿生成的音色描述去跑语音合成,效果很差。作者查出两个原因。
写成参数串,别写成散文。 同一个角色,500 字的英文散文明显不如 230 字的参数串。他给了固定顺序:年龄性别、音色、音区、共鸣、动态范围,然后是音量、语速、语调习惯、口音、默认情绪。比喻、表演指导("威胁时从不提高音量")、条件分支("公堂上能切换成官话")都不要写。引号里的台词更不能写,有些引擎会把它念出来。
界面上只留一条能复制的。 原来报告里中文对照排在前面,用户点了它,把中文散文喂进了引擎。作者的修法是直接删掉中文对照,他的原话是"消除歧义优于解释歧义"。
有的引擎根本不吃文字描述。 Qwen3-TTS Voice Design、ElevenLabs、MiniMax speech 吃;CosyVoice 的 instruct 和 IndexTTS 不吃,它们的音色只来自参考音频。
第五份精华:检查规则怎么设
这部分对做任何 AI 流水线的人都有用。
误拦的检查比没有检查更糟。 "开场有没有运动""音色描述里有没有比喻",这类语义判断靠关键词扫描,会两头漏。作者只把它们写进规则文档,不设检查。
阈值是量出来的。 判断两个角色的提示词是否雷同,他先量了样例:正常角色两两最高 39%,"只改年龄和衣服颜色"的坏例 98%,阈值定在 75%。
缺了上游文件,要明说跳过。 不判失败,也不悄悄略过。
检查失败要攒起来看。 每次失败记一行日志,统计哪条规则最常被违反(该改措辞了),哪条从没响过(可能是死规则)。作者没让程序据此自动改规则,理由是没有评测集,自动改就是瞎改。他还给自己留了一句:"如果长期没人打开它,说明这个功能不该做。"
哪些部分不值钱,或者已经过时
框架和报告。 分层设计、JSON 结构、约 80 道检查、能拖动调整的报告页面、把五份报告合成一页的组装器、中英双语界面,代码写得很认真,Opus 5.5 照着需求一天能搭出来。读这个项目,scripts 目录可以跳过。
写作课。 前面说过,剧本规则里通用的写作手法 Opus 都会。
跟着模型版本走的数字,过时得很快。 单段 15 秒是按当时的模型定的,Seedance 2.5 已经能一次生成 30 秒。它整理的是 Seedance 2.0 的官方指南,到了 2.5,时间怎么写已经有不同说法。ChatGPT 订阅大约出 25 张图触顶、Qwen Image 2.1 的工作流参数,换个版本都要重测。
给弱模型留的余量,可能偏保守。 分集梗概每批不超过 10 集,理由是"60 集一口气写,后半段一定崩";扫描小说找角色,每块 4 万字符。作者自己已经把分块从 1.4 万字符提上来过一次,理由是"现在的模型读 4 万字符毫无压力"。换成百万上下文的 Opus 5.5,这些上限多半还能放宽,我们没有测过。
仓库里已经被自己推翻的写法。 角色设定图还是把半身像、三视图、细节拼在一张 16:9 的图上。后来做的 character-refs 实测发现,拼接图当参考会把人画小,多人同框时还会画出多余的人,于是改成每个视图单独一张;Seedance 官方也说多视图会被当成几个人。拼板当设计稿给人看没问题,别拿去当视频的参考图。
"出图提示词一律写英文"值得重新想。 角色和场景的出图提示词规定全用英文,理由是图像模型吃英文最稳。前面"款式名放第一个"那条,翻车的原因恰恰是中文转英文时丢了尾巴。现在 Qwen Image、Seedream、Seedance 都是中文原生模型,它 2.0 版的分镜图提示词也已经改成了中文。这一条是我们的判断,没有实测。
用之前要知道的几件事
证据偏薄。 大部分"实测"是一两个种子、一个样例故事,没有前后对照。和做过严格对照的 h3-storyboard 放在一起,还有一处冲突:shuohao 让每个镜头用文字写谁在左谁在右,h3-storyboard 的对照实验发现,文字写的站位对左右不起作用,站位由图决定。
停在投产包。 它不出视频,也不检查生成出来的视频。场景设定里的"锚点"写明了是给质检核对用的,这一步没有做。站位结果也要人手抄进分镜。
跨集的故事记忆很薄。 剧本一集一集独立写,靠大纲衔接,没有伏笔账本这类东西。几十集的长剧,这方面不如 InkOS。
镜头配方卡没公开。 更新记录里有一套 71 张的镜头配方卡和技法卡,已经迁到作者的私有仓库,公开版只剩 3 张测试卡。
和之前拆过的几个项目放在一起看
写小说、管长篇记忆,InkOS 更强。从剧本到视频这一段,shuohao-skills 是我们看过的项目里规则最细、落到程序最多的一个。
最后
简单总结一下:shuohao-skills 值得读,值得读的是它的规则文档,代码不用细看。用 Opus 5.5 做 AI 短剧,从剧本到视频提示词这一段,它能省下一轮轮"生成出来不对、回头查原因"的来回。拿来用之前,挑几条关键的自己跑一次。
如果只想读,最值得看的是这几个文件:
skills/novel-storyboard/references/ 下的 storyboard-pass.md、shot-writing.md、frame.md:分镜和挂图规则;
skills/character-refs/references/prompting.md:参考图的实测写法;
skills/novel-script/references/script-pass.md:常见动作和冷开场;
skills/novel-characters/references/profile-pass.md:角色设定和音色提示词;
skills/novel-art/references/scene-pass.md 和 skills/novel-staging/references/read-pass.md:场景设定和认图;
CHANGELOG.md:每次为什么改,翻车经过大多写在这里。
希望这篇对你有帮助。对 AI 做视频感兴趣的朋友,欢迎在留言区一起交流。
项目地址:github.com/eternityspring/shuohao-skills

