花3天做AI短剧,累计播放破10万:这些坑,我替你踩了一遍
- 2026-11-18 02:26:16
从定妆、生成到补拍与剪辑,一轮真实制作的流程与踩坑记录。
生成出一段视频,和完成一条能让人看懂的剧情,是两回事。
最近,我连续做了一轮AI短剧,也拿到了一点小的结果,破了10万的播放。
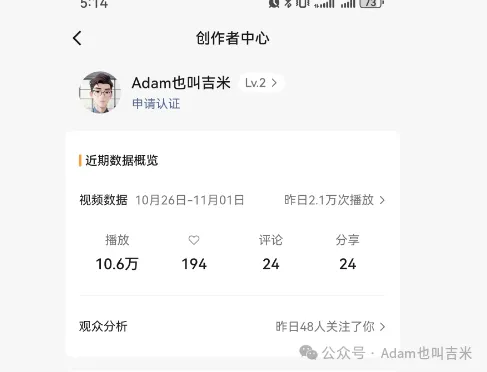
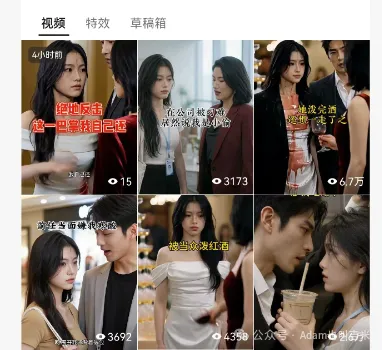
有总裁吃醋,有宴会上被泼红酒,也有被冤枉后站出来反击的场景。
真正动手之前,很容易以为流程就是:
找个故事,写段提示词,上传人物图,等模型生成。
做完才发现,生成出一段视频,和完成一条能让人看懂的剧情,是两回事。
我让AI拍一场项链引发的误会。结果大家都在说项链,观众却几乎看不清项链。
另一条里,男主明明已经接过女主的帆布包,几个镜头以后,包又回到了她肩上。
还有一次,男主说着“滚”,脸却朝向了自己正在保护的人。
每个问题单独看,好像都不算特别严重。连成剧情,意思就可能变了。
所以,这篇不讲“一句提示词做出爆款”。
我把这轮制作整理成了一套流程:先想清楚拍什么,再决定交给模型做什么,最后检查它到底有没有做到。
PART 01 / 故事
先写清15秒,再打开生成工具
一开始,我也想把故事做大。
固定男女主、反派、身份秘密、宴会冲突,再接下一集的反转,似乎很容易做成系列。
但自然流里的观众,不一定从第一集开始看。
他可能只刷到其中一条。如果还要先搞懂谁是谁、之前发生过什么,15秒已经过去一半了。
后来,我把每条内容缩成:
一个场景、一件事、一次变化、一个结果。
例如:女主觉得自己配不上对方,想避开;男主认真回应;最后她从回避变成主动对视。
不需要交代两个人怎么认识,也不用同时塞进身世秘密。
生成前,我现在更愿意先写三行:
开头:观众第一眼看见什么? 中间:局势发生了什么变化? 结尾:这条视频承诺的事情,有没有回应?
注意,是“回应”,不一定每次都要大反转。
可以是一句坚定的话,也可以是接过包、握住手、把座位挪到她身边。
时长短,不代表情绪可以没有过程。
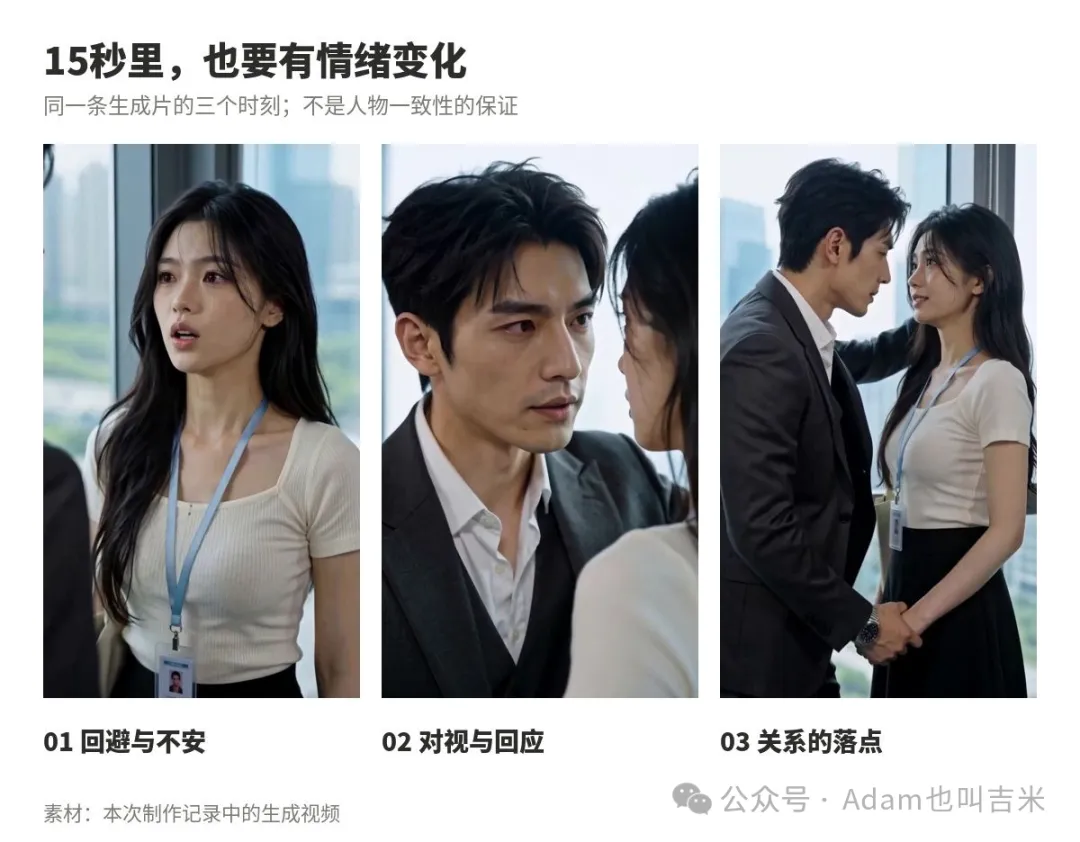
从回避、对视到关系落点,画面之间要有变化,不只是轮流念台词。
下面这段,是我这一轮制作中的生成样片。它不是完美示范,但能看出人物表情和关系的推进。
制作记录中的15秒AI生成样片,尚未叠加后期字幕。
PART 02 / 定妆
参考图不在多,在于分工清楚
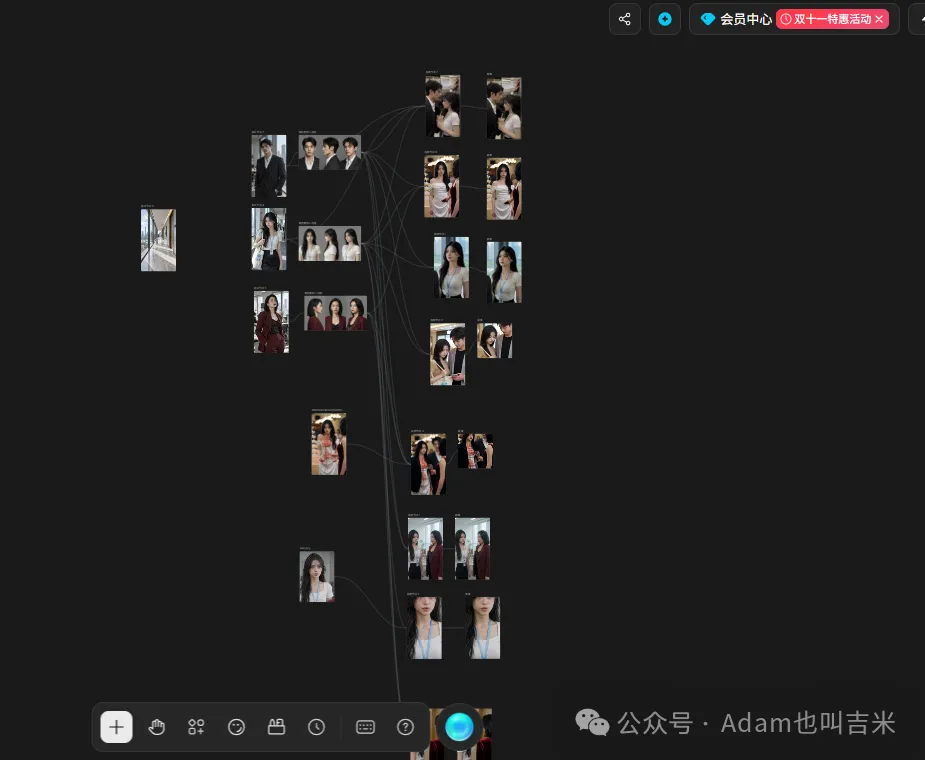
我这一轮用Libtiv做了人物和场景定妆图,后面也准备了人物多角度参考。
准备这些图,主要想解决两个问题:
这个人是谁?这一场,他穿什么?
它们不能完全混在一起。
比如,一张办公室定妆照里,女主穿白上衣、戴蓝色工牌。
后来换成宴会场景,如果仍然把整张图当成所有元素的参考,模型就可能继续保留不该出现的工牌或办公室背景。
我的建议是,把素材分成三类:
人物面容参考:主要帮助识别五官和不同角度。 服装参考:确定本场的衣服、发型、配饰。 场景参考:只有环境需要精准延续时,再准备。
提示词里也写清楚每张图的用途,而不是把几张图上传后,让模型自己猜。
还有一个容易忽略的问题:脸在参考图里是否足够清楚。
全身图可以看穿搭,但面部细节有限。近景、多角度参考可以补充信息,但也需要检查侧脸是否仍然像同一个人。
三视图不是“上传后永不崩脸”的保证。
它只是提供参考,最终仍要检查成片。
如果是新手,第一条不妨先做两个人、一个简单场景。别一上来就挑战多人宴会、复杂道具和连续动作。
PART 03 / 提示词
少堆形容词,多写动作顺序
“电影感”“真实”“霸气”“委屈”。
这些词都能写,但它们不能代替具体的动作。
同样是“男主护短”,下面两种写法给出的信息完全不同。
一种是:
男主霸气地保护女主,让反派道歉。
另一种是:
男主走到女主身旁,停稳,看向对方。先说清事实,短暂停顿,再要求对方道歉。说完不立刻转身,留出对方回应的时间。
第二种没有那么多气氛词,但模型更容易知道:先做什么,再做什么,镜头该看到什么。
我后来把提示词整理成这几个部分:
基本设置:画幅、时长、本条镜头数量。 参考素材:每张图片对应谁,参考面容、服装还是场景。 人物与道具:本场的服装、配饰、核心道具。 镜头:每个镜头多长、拍多近、人物先后做什么。 对白与声音:谁说哪句话,重音、停顿、情绪如何。 连续性:什么东西必须保持不变,哪些动作不要增加。
这不是某个模型专属的“神奇格式”,而是一张拍摄说明书。
不同工具的参考图绑定方式和参数入口不同,时长、比例、清晰度,要在实际界面里设置。把“1080p”写进提示词,不等于输出就会变成原生1080p。
也不要为了把故事塞进15秒,让角色越说越快。
台词写完,自己按角色语气读一遍。连人都觉得赶,就先删,不要等模型替你解决。
PART 04 / 表演
“霸气一点”,为什么还是没气势?
这轮制作里,我特别在意一个问题:
男主说“道歉”,有时听起来却像在温柔商量。
台词没错,人物立场却软了。
回头看,提示词里反复强调“克制、不吼叫、声音平稳”,却没把愤怒、重音和停顿写清楚。
模型可能把“克制”理解成“轻柔”。
后来,我更倾向于拆开写:
先看住对方,不边转身边说; 短暂停顿,笑意收住; 正常发声,不用气声; 关键字咬清,句尾落下; 说完留一点反应时间; 背景音乐不要盖住这句话。
克制的是音量和动作,不是立场。
但也不是所有场景都要变凶。
面对欺负她的人,可以冷硬;面对家人,需要坚定;转向女主时,才放柔。
角色有这种区别,才像在对不同的人说话,而不是用同一种声线读完整段文字。
这些描述能让生成方向更明确,不代表每次都能准确执行。如果画面满意,只是一句话的语气偏了,可以评估局部配音,不一定整条重做。
PART 05 / 验片
单帧没问题,连起来却穿帮了
我最容易犯的一个错误,是看到人物好看、镜头顺,就觉得这条差不多了。
但AI很擅长生成一张看起来合理的画面,未必擅长把前后关系一直维持正确。
比如帆布包这一条:
前镜头里,男主接过了包。
后镜头里,包又回到了女主肩上。
中间没有交还动作。
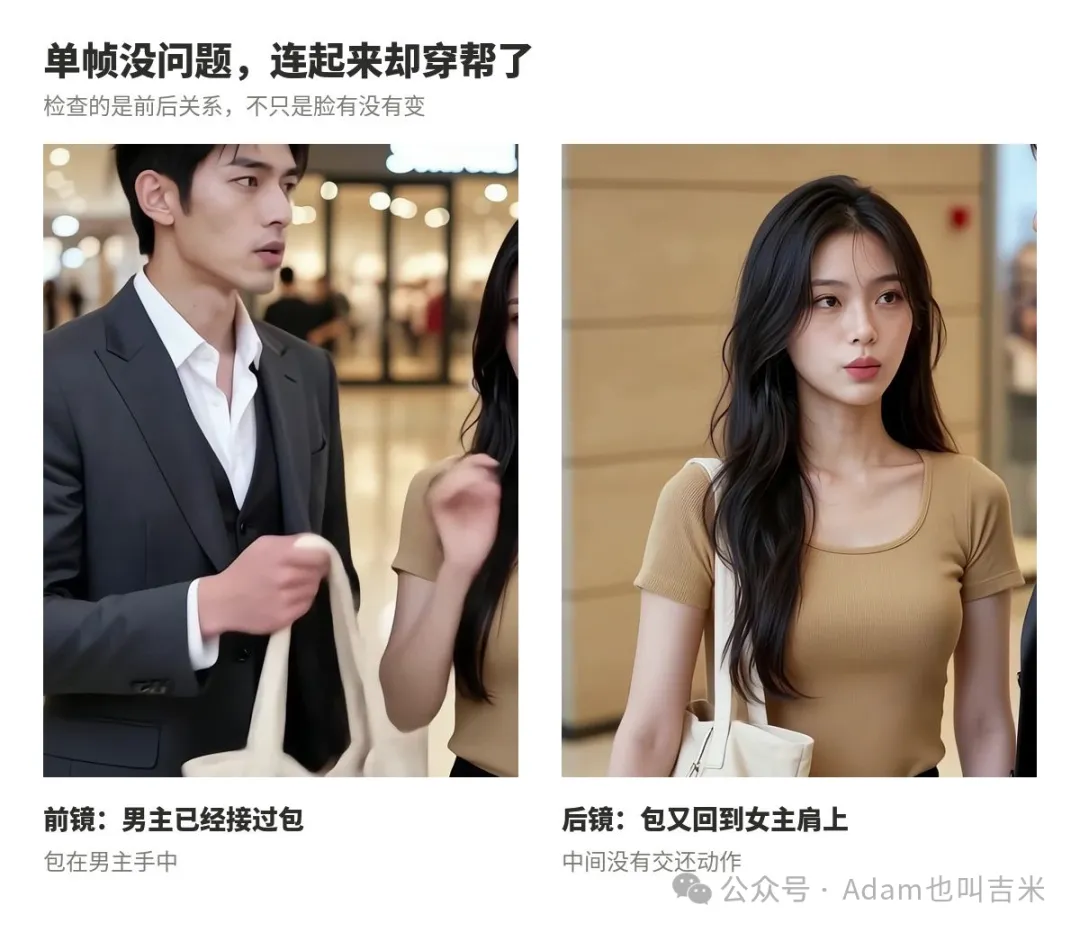
这两个画面单独看都能成立,连起来却少了一个过程。
当时也考虑过加一句心声:“重新背上包,这次,我有了底气。”
它可以提示叙事变化,但我不会把这写成万能修复方法。
字幕没有真的补出交还动作。
能避开矛盾画面,通常比加解释更干净;如果包本来就是故事核心,更应该在生成前约束它的位置和移动。
项链那条也类似。
模型不是完全没生成项链,而是吊坠太小,蓝色工牌又更抢眼。大家都在争论这个东西,观众却没看清它。
这让我意识到:
核心道具不仅要存在,还要在观众需要理解它的时候看得见。
现在我检查成片,会先问:
观众知道他们在争什么吗? 这句话对谁说,是否清楚? 上一镜拿走的东西,下一镜还在正确位置吗? 结尾是不是兑现了开头?
这些通过了,再去看皮肤、色调和镜头质感。
PART 06 / 修正
先局部修,别急着整条重抽
重新生成很容易成为默认选项。
但每次重抽,都可能解决一个问题,再带来两个新问题。
我现在更建议按问题范围决定:
核心道具看不清:先评估补一个短近景。
项链这次,我就补出了更清楚的镜头。补拍时,不只给人物三视图,还应给原片截图,让服装、道具和光线有依据。
不过,补出素材不等于问题已经解决。还要看插入后是否自然、有没有拖慢节奏。
一句对白语气不对:评估局部配音。
同时检查声线、口型和环境声能否匹配。
一小段动作出错:看能否缩短、换反应镜头或在动作中间切开。
不要强行保留每一帧。
人物关系或剧情顺序根本不成立:回去改脚本。
别让字幕承担所有解释。
文件清晰度不足:先找平台能下载的高清原文件。
低清素材导出成1080p,不等于缺失细节恢复了。
一个简单原则是:
局部问题,先局部修;结构问题,先改结构。
PART 07 / 发布
做得出来,不等于发出去就行
这篇主要讲制作,但发布不能完全放到最后才想。
同样一条内容,不同平台的发布方式和要求可能不同。尤其准备做固定角色、跨作品衔接的故事时,应当先确认相应的剧集或内容承载要求。
我这一轮也收到过相关提示。具体经历和后续调整,值得另写一篇。
这里先留下一个提醒:
原创、AI生成声明、剧情演绎声明,都不等于其他要求自动满足。
也不要因为某条播放低,就马上删掉重发,或者认定模型不行、账号不行。
制作问题、内容吸引力和发布要求,是三件需要分别检查的事。
CHECKLIST / 留给下一次制作
从故事到发布,这7步别跳过
01 写清一件事
开头是什么,中间怎么变,最后有什么回应。
02 准备少而明确的参考素材
面容、服装、场景分工清楚。
03 按镜头写动作和对白
写顺序、对象、重音,不只堆气氛词。
04 先生成一个简单场景
先把两个人的关系拍清楚,再增加复杂度。
05 检查连续性和理解成本
不只问“脸好不好看”,也问“故事能不能看懂”。
06 决定局部修,还是回去重做
不要把每个问题都交给下一次抽卡。
07 做字幕、声音和发布检查
对白逐字校对,核心画面别被字幕遮住,按当前平台要求发布。
做完这一轮,我对AI视频的理解变了。
以前以为,难的是让模型生成一个好镜头。
现在觉得,更难的是:
知道自己要拍什么,也能判断模型到底有没有拍对。
AI能替我完成一部分画面,但不能替我决定人物该看谁、道具该在哪儿、这句话该用什么态度说。
提示词只是开始。
真正让一条视频成立的,是生成前的判断,以及生成后的取舍。
我是Adam,也叫吉米。这里继续记录我真正做过的AI视频流程、翻车和修正。
你如果已经开始尝试,最容易卡在哪一步:人物一致性、动作、对白,还是剪辑?欢迎留言,我会结合实际案例继续拆。
文中人物画面及示例视频为AI生成,配图来自本次制作记录,仅用于说明创作过程。
我是Adam也叫吉米,持续创作AI干货,分享图像和视频创作工作流,关注我,不迷路~

