一个人做AI短剧,真正难的不是画面,而是这5步能不能接上
- 2026-10-05 00:10:55
AI 视频工具越来越多,生成一个好看的镜头,已经不算最难的环节。
真正麻烦的是下一步。
剧本怎么往下走?人物能不能保持一致?角色是不是会撞脸?分镜、场景、道具谁来管?15个镜头里有一个不满意,是全部重做,还是只改那一个?
AI 短剧真正的门槛,不是让某个模型生成一个漂亮镜头,而是让剧本、角色、分镜、视频和片头真正接上。
下面这套流程,把一个人做 AI 短剧需要处理的几个关键环节拆开。
图注:LibTV 官方网站首页
这类工具解决的不是“生成”,而是串联
现在的模型,单独生成一段画面已经不稀奇。
难的是把前后环节连起来:
故事写到一半,人物形象变了;
场景生成得很好,但进入下一个镜头对不上;
分镜拆得够细,可人物和道具没有固定资产;
15个镜头生成完,还得重新找节奏、补声音、加字幕和片头。
LibTV 1.5 这次更新的重点,正是把这些问题往同一条工作流里收。
整套流程可以分成 5 步:
用 TV Director 写剧本; 用资产清单和角色造型是固定人物、场景、道具; 用导演分身拆镜头并批量生成; 用成片精修处理节奏、片头、声音和字幕; 用 3D-BOX 预演复杂镜头。 关注重播 分享 赞
顺序最好不要反。
很多作品看起来“生成得很努力,但成片很散”,原因往往不是模型不够强,而是前面的剧本和资产没有定下来。
第一步:先让 TV Director 把剧本定下来
新建画布后,点击页面底部的 TV Director。
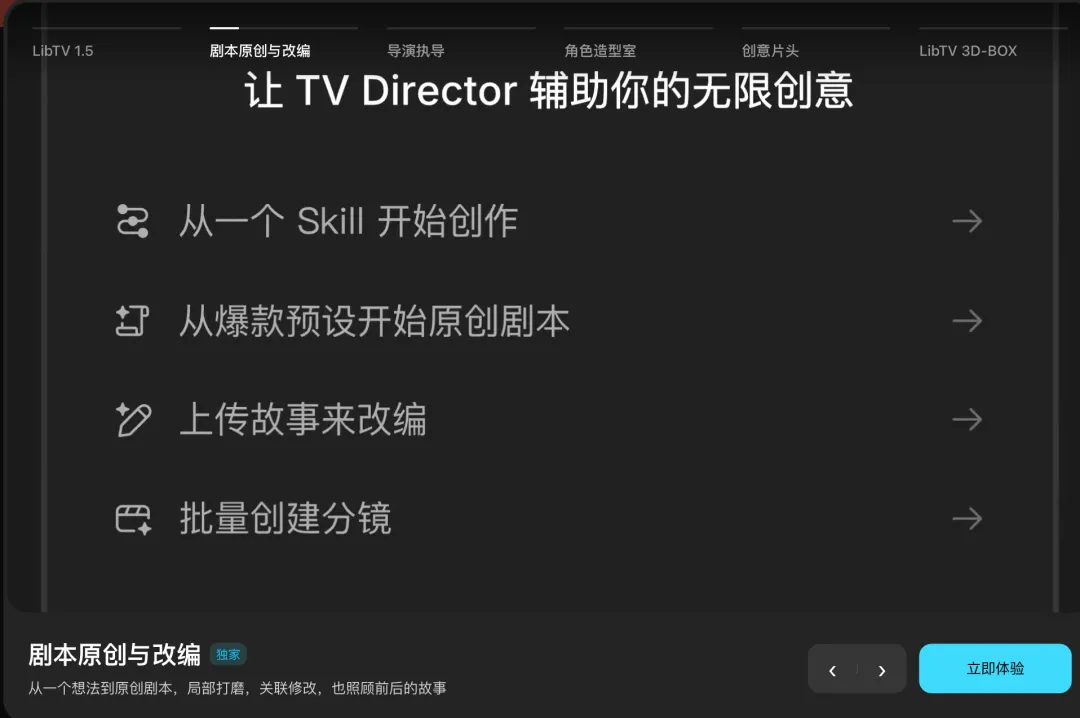
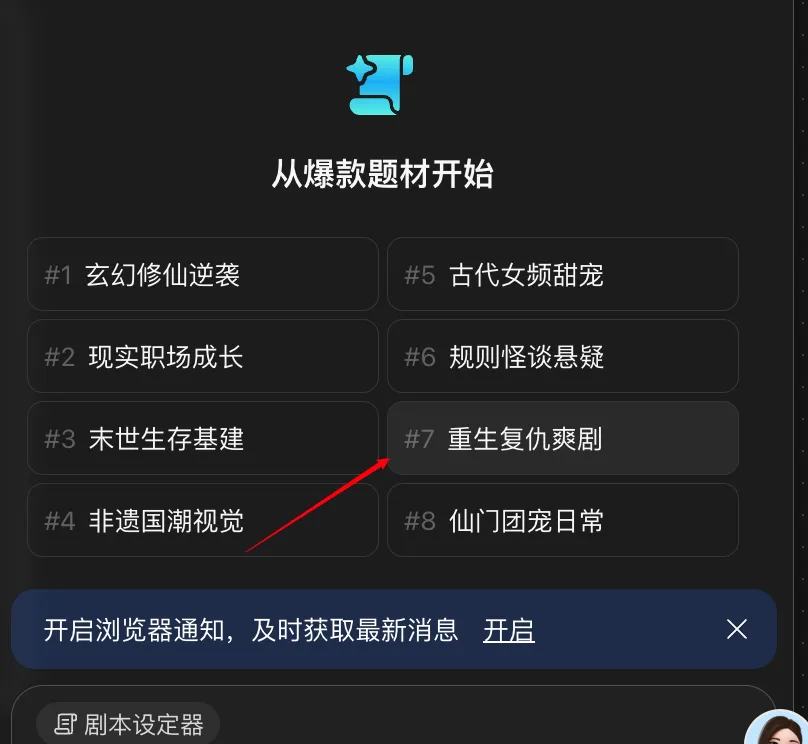
在剧本原创环节,可以先从“爆款预设”开始。LibTV 按照常见短剧题材和节奏整理了多个创作方向。
以“重生复仇爽剧”为例:
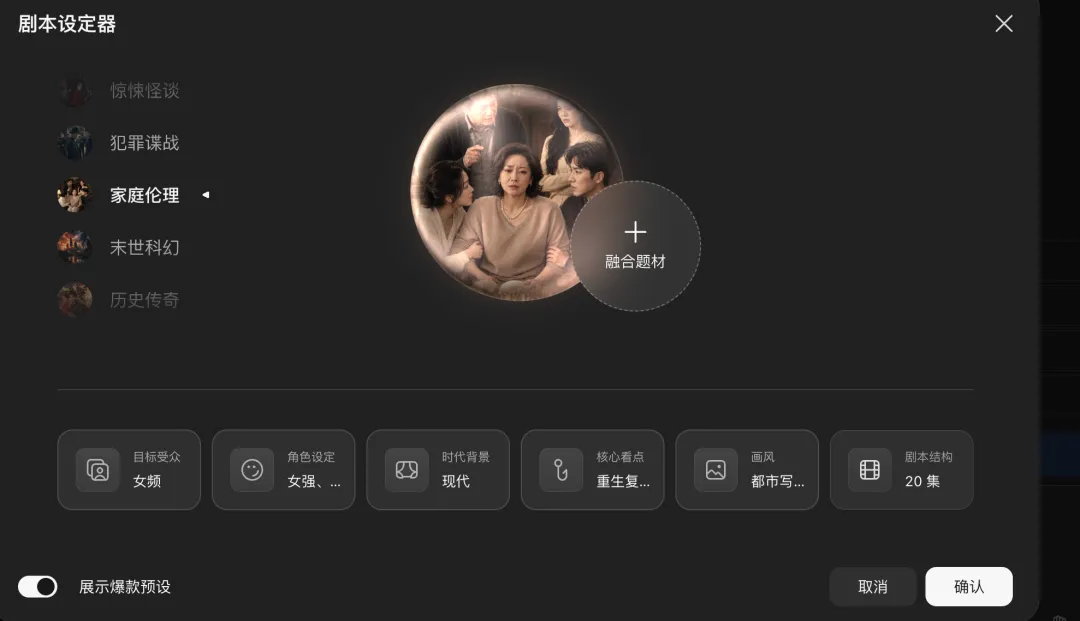
然后选定剧本设定等选项,根据自己的需求进行选择即可。
先把故事核心输入进去:
核心故事是:女主苏晚被丈夫和表妹设计,葬身火海,重生回周年宴当天,开始寻找两人转移公司资金的证据。帮我写一个重生复仇的剧本,要快节奏、反转爽剧。
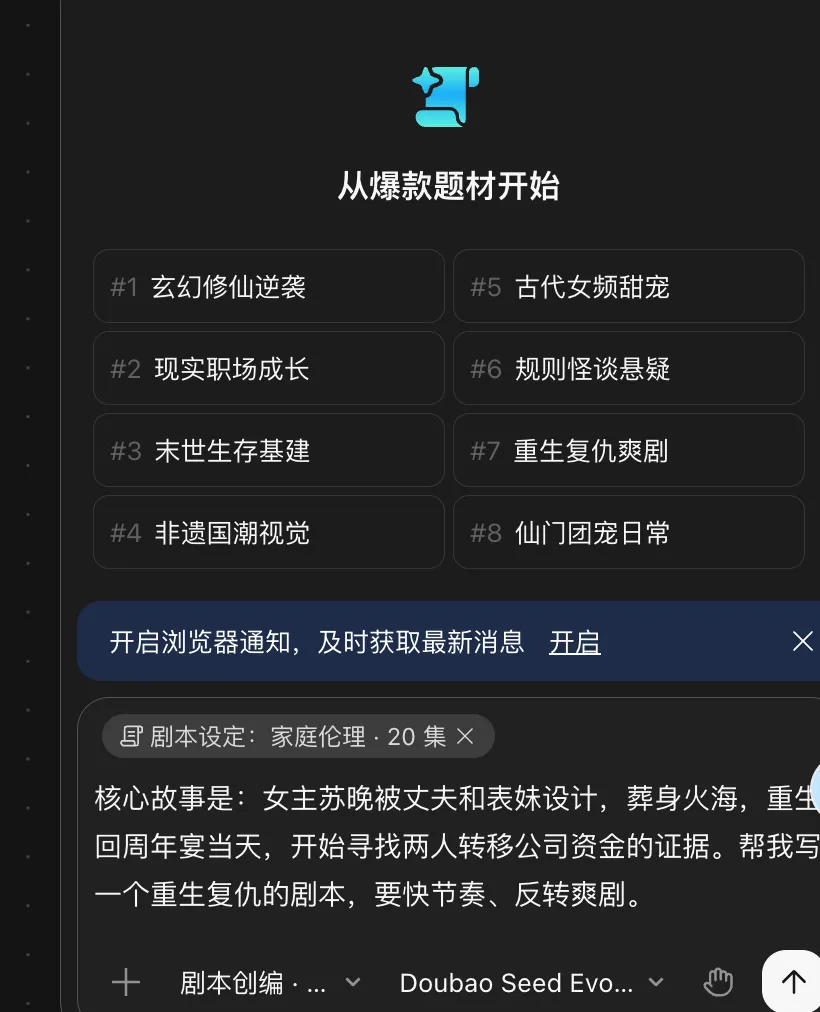
系统先生成全剧的大纲,再继续生成第一集完整剧本。
这里有一个很实用的细节:剧本局部需要修改时,可以直接用对话提出要求。
这样改的是具体位置,不会因为一句小修改,把已经确认的整份剧本全部推翻。
这一步看起来最像“传统写作”,但它决定了后面所有画面有没有共同方向。
第二步:把角色、场景、道具先变成资产
剧本确认后,让 TV Director 根据内容整理资产清单。
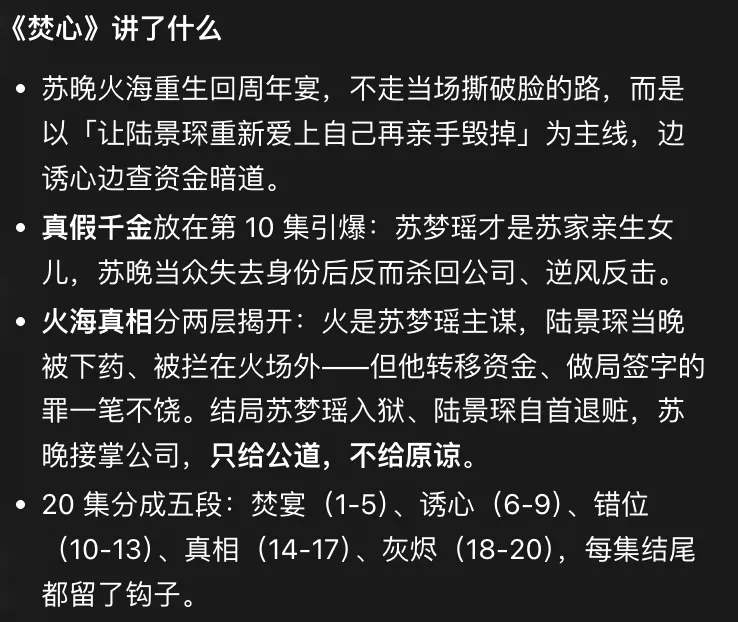
短剧《焚心》的主要角色包括苏晚、陆景琛和苏梦瑶。
有场景和道具等,这和真实拍摄很像。
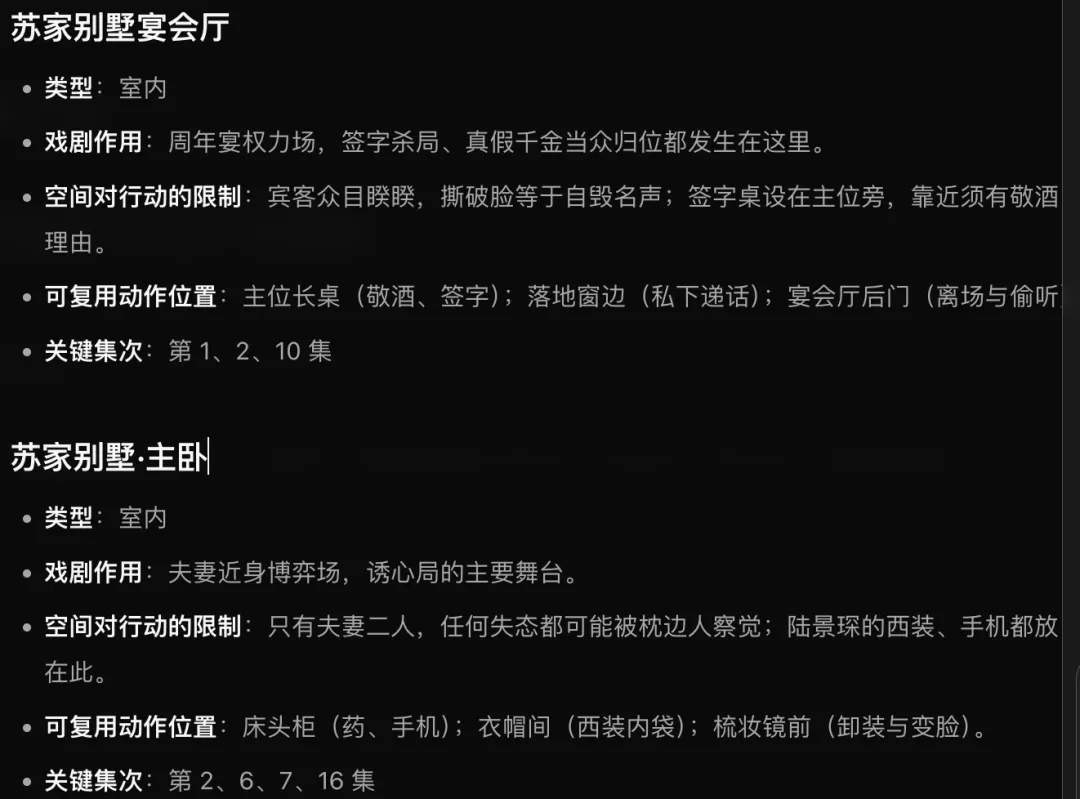
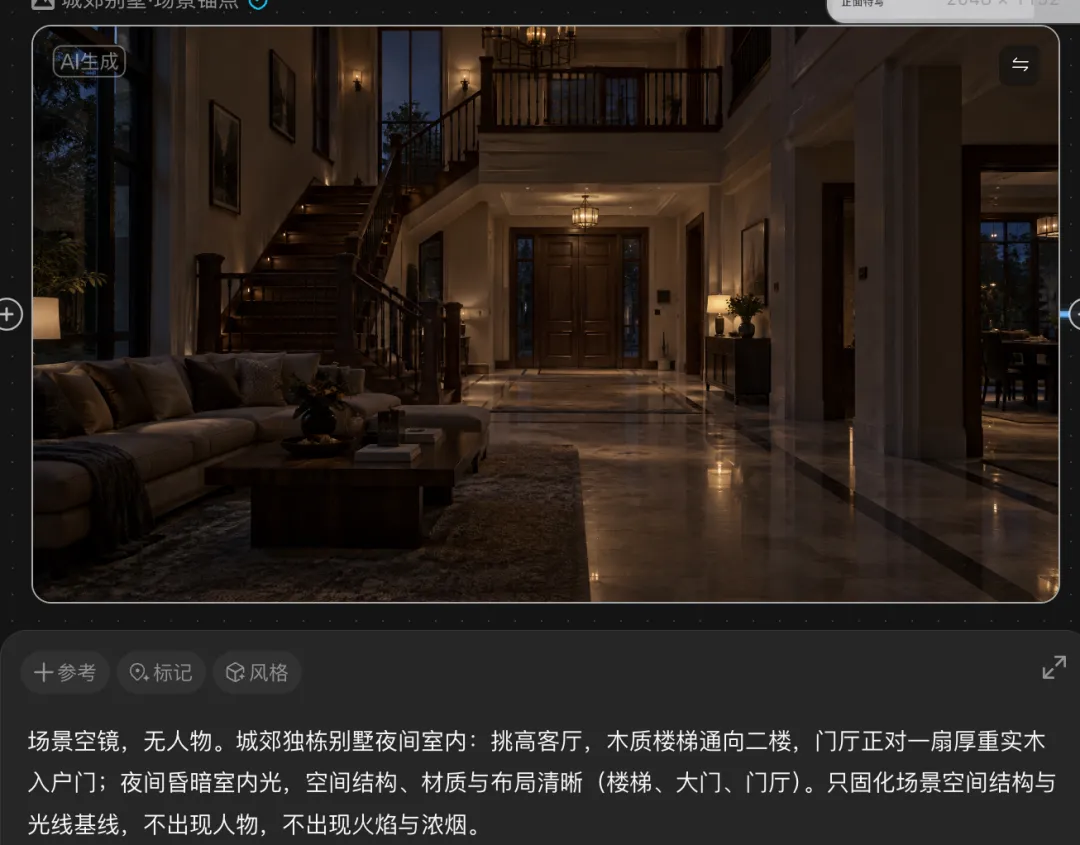
先把演员、置景和道具定下来,后面的分镜才有东西可以调用。
第一次生成人物时,最容易出现的一个问题是:主角都是年轻女性,五官和发型接近。人物单独看没问题,放在同一部短剧里就容易认错。
这时进入角色造型设计,选中苏晚的形象继续调整,重新生成即可。
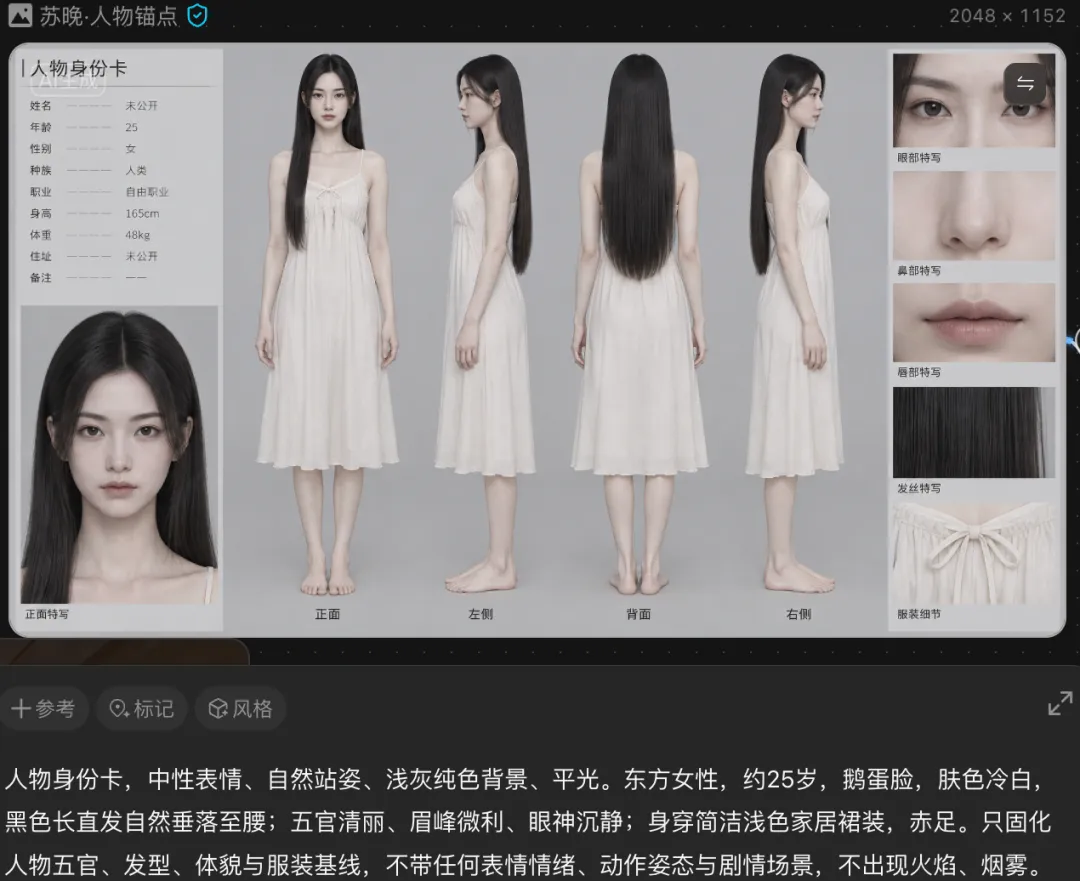
可调整的内容包括:
脸型; 眉毛、眼睛、鼻子和嘴巴; 发型; 痣、疤痕、雀斑等细节; 服装; 音色音调。
最后把苏晚可以改成更有辨识度的头发等,并生成一套角色卡。
角色卡里包含头像、全身图、不同角度的转面和多种表情参考。
这张卡不是一次性的结果,后面会反复用于分镜和视频节点。
同理,其他场景也一样。
到这一步,人物、场景和道具才算真正准备好。
第三步:用导演分身拆镜头,别一次把全片丢给模型
资产准备完成后,把 TV Director 切换到“导演执导”。
LibTV 支持选择预设导演,也可以导入自己的创作方法或提示词模板,生成导演分身。
选择“悬疑短剧”导演分身,再把剧本、角色、场景和道具交给它,让它完成分镜。
导演分身先阅读剧本,再拆成独立视频节点。
《焚心》第一集最后拆成了 15 个镜头。
每个节点里都有:
对应剧情; 出场人物; 参考场景; 道具; 镜头提示词。
比如苏晚在电脑上查看转账记录的镜头,节点会连接苏晚的角色卡、贵宾休息室场景和相关道具,再描述动作、景别与氛围。
批量生成之前,先逐节点检查角色、场景状态、道具和时长。
这一步不要省。
首轮生成后,不同镜头的质量肯定会拉开。
能用的保留,人物动作、构图或情绪不对的单独重做。其中一个镜头首轮使用 Seedance 2.0,效果没有达到预期,后来切换到 Seedance 2.5 并调整提示词重新生成。
这比“不满意就整片重跑”更接近真实制作。
第四步:镜头都有了,还要做节奏、声音、字幕和片头
15 个镜头都能用之后,按剧情顺序拼接,继续处理节奏、声音和字幕。
接着制作片头。
在视频节点上方进入成片精修工具栏,点击“创意片头”。
操作顺序是:
从视频里选择一帧画面; 输入片名; 选择片名设计风格; 选择文字动效; 生成并导出片头。
片头示例选择的是苏晚坐在豪宅的画面,片名是《焚心》,版式使用“简约高级”,文字动效使用“融入原片”。
这一步的价值不是多做一个炫技动画,而是让整部短剧有统一的片名识别。
第五步:复杂镜头先用 3D-BOX 预演
第四集里有一场地下停车场的偷听戏。
这场戏的问题不在“能不能生成”,而在空间关系能不能成立。
人物站在车哪一侧?苏晚藏在哪根柱子后?柱子能不能挡住她?摄影机什么时候揭示她?最后怎么推进到录音笔近景?
这些细节如果只靠一大段自然语言描述,很容易在生成后才发现理解错了。
所以在 LibTV 首页打开 3D-BOX,用白模确定停车场结构、人物位置和摄影机运动。
预演结果可以直接检查,也可以继续用文字修改人物站位或手动调整摄影机轨迹。
确认之后有两种处理方式:
导出 3D 白模视频; 点击“去画布生成”,把预演带回项目画布。
回到画布后,把白模视频作为运镜参考,再连接角色资产,输入写实视频提示词。
白模负责告诉模型“镜头怎么拍”,角色资产负责确定“画面里的人是谁”。
这就是复杂镜头为什么要先预演,而不是直接交给一段提示词。
这套流程真正值得复用的地方
把 LibTV 1.5 这条流程看完,会发现它和“多试几个视频提示词”不是同一件事。
它把制作拆成了几个可检查的岗位:
TV Director 负责故事; 角色造型室负责人物资产; 导演分身负责分镜和节点; 成片精修负责最后收口; 3D-BOX 负责空间与运镜预演。
每一步都有明确输入和输出。
对个人创作者来说,真正的效率提升不一定来自“一次生成多快”,而是下一次项目能不能继续调用已经确认的角色、场景和工作方法。
如果只用一句话让AI直接出片,最后很可能还是要手工收拾所有前后不一致。
先写清楚故事,固定人物资产,再做分镜和视频,这条路看起来慢,实际返工最少。
想试的话,从这里开始
LibTV 官网已经核验:
LibTV 官方视频创作工具
第一次不要直接做完整短剧,可以先用一个只有 3 个镜头的场景练手:
先写剧本; 固定 1 个角色和 1 个场景; 拆成 3 个节点; 生成后只重做不合格的镜头; 最后再补声音、字幕和片头。
先把小场景跑通,再扩展到 15 个镜头。
你最想先做哪一种短剧:重生复仇、校园故事,还是知识科普?
欢迎关注、点赞、转发、收藏

